Qwen: что это за нейросеть, какие есть модели и как их использовать
Qwen — семейство нейросетей от Alibaba Cloud для работы с текстом, кодом, изображениями и другими типами данных. В линейке есть универсальные, мультимодальные, кодовые и embedding-модели разных размеров и архитектур. Некоторые из них доступны с открытыми весами, поэтому их можно запускать на собственном оборудовании.
Разобраться в многообразии версий Qwen бывает непросто. В статье рассмотрим основные модели семейства, сравним их возможности и разберем три способа использования: через веб-чат, локально и по API в облаке.


Что такое Qwen и кто его разрабатывает
Qwen выходит поколениями: Qwen3, Qwen3.5, Qwen3.8 и другие. У каждой версии свои размер, контекст и лицензия. Под названием Qwen пользователи подразумевают разное: чат на сайте, открытые веса для запуска на своем сервере или API в облаке. Для выбора важна конкретная версия и способ ее запуска.
Qwen — семейство LLM Alibaba Cloud с открытыми весами
Qwen — это серия больших языковых моделей (LLM, Large Language Model), которую с 2023 года развивает Alibaba Cloud. Нейросеть выходит в двух форматах: открытые модели с весами на Hugging Face и закрытые флагманы Qwen Max, доступные через API. Большинство открытых версий — Qwen3, Qwen3-Coder, Qwen3-VL, Qwen3-Embedding и Qwen3-Reranker — выходит под лицензией Apache 2.0, поэтому веса можно запускать на своем оборудовании. Исключение — флагманская Qwen3.8-2.4T-A95B: она распространяется под кастомной лицензией Qwen3.8-Max License с ограничениями для крупных коммерческих пользователей.
Как Qwen работает с русским языком
Qwen3 обучали на 119 языках и диалектах, включая русский. Qwen на русском понимает запросы и отвечает связным текстом, а Qwen3-Embedding и Qwen3-Reranker поддерживают более 100 языков. Малые версии чаще ошибаются на сложных формулировках, поэтому проверяйте их на своих примерах.
Какие есть модели Qwen
Модели Qwen различаются размером, архитектурой и задачами, для которых предназначены. По архитектуре их делят на два основных типа: плотные (dense) и MoE (Mixture of Experts).
В плотных моделях все параметры участвуют в обработке каждого токена. Чем больше параметров, тем выше потенциальные возможности модели, но тем больше вычислительных ресурсов требуется для ее запуска.
В MoE-моделях используется другой подход: для обработки каждого токена система выбирает только часть параметров — так называемых экспертов. Поэтому, даже если общее количество параметров велико, одновременно работает лишь их часть. Например, обозначение 235B-A22B означает, что модель содержит 235 млрд параметров, но для обработки каждого токена задействует 22 млрд.
Разберем основные семейства Qwen и задачи, для которых они подходят.
Qwen3: универсальные модели — плотные и MoE
Qwen3 — семейство универсальных языковых моделей, которое Alibaba представила 29 апреля 2025 года. Они подходят для работы с текстом, ответов на вопросы, анализа информации и других задач, связанных с обработкой естественного языка.
В первоначальную линейку вошли восемь моделей:
Плотные: шесть версий с 0,6, 1,7, 4, 8, 14 и 32 млрд параметров. Все параметры каждой модели участвуют в обработке токенов.
MoE: Qwen3-30B-A3B с 30 млрд параметров, из которых активны 3 млрд, и Qwen3-235B-A22B с 235 млрд параметров, из которых активны 22 млрд.
Размер контекстного окна тоже зависит от модели. На момент выхода две младшие версии поддерживали до 32 тыс. токенов, остальные — до 128 тыс. В обновлении 2507 контекстное окно Qwen3-235B-A22B расширили до 262 144 токенов без дополнительных расширений.
Модели распространяются по лицензии Apache 2.0, которая допускает использование весов в коммерческих продуктах.
В дальнейшем линейка пополнилась новыми поколениями. В феврале 2026 года вышла Qwen3.5 — MoE-модель на 397 млрд параметров с 17 млрд активных. В апреле представили Qwen3.6 — MoE-модель 35B-A3B с лицензией Apache 2.0. В августе 2026 года появились Qwen3.7 и Qwen3.8. Актуальные характеристики отдельных версий стоит проверять на страницах соответствующих моделей.
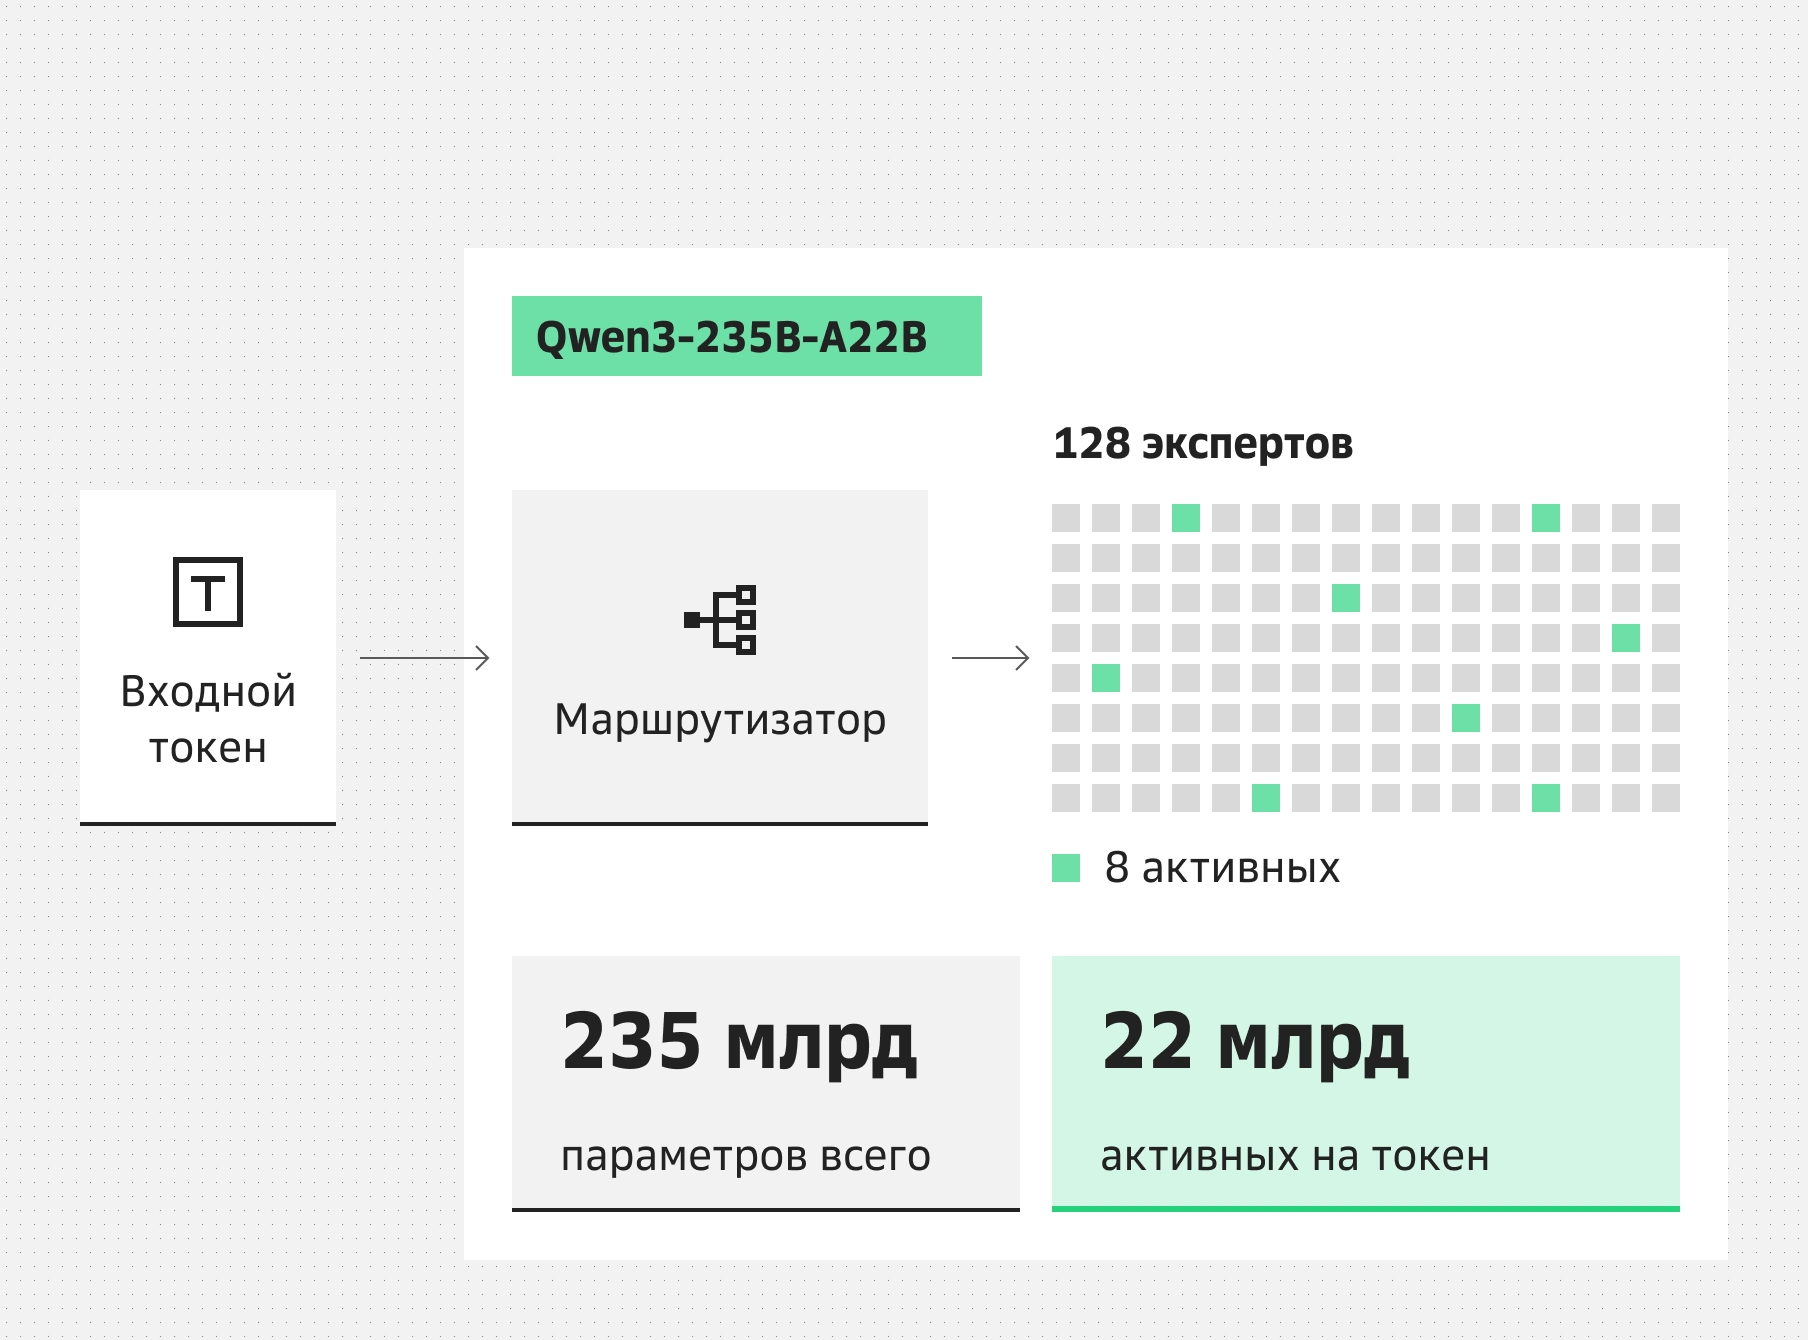 В MoE-модели Qwen3-235B-A22B на каждый токен работают 8 экспертов из 128
Qwen3-Coder: модели для генерации и анализа кода
Qwen3-Coder — семейство моделей, предназначенных для программирования. Их используют для генерации и анализа кода, а также в разработке ИИ-агентов, которые могут выполнять задачи с помощью инструментов.
Среди основных моделей:
Qwen3-Coder-480B-A35B — старшая модель с 480 млрд параметров, из которых активны 35 млрд. Поддерживает контекстное окно до 262 144 токенов, которое можно расширить до 1 млн с помощью YaRN.
Qwen3-Coder-Next — более компактная модель, представленная в феврале 2026 года. Содержит 80 млрд параметров, из которых активны 3 млрд, и ориентирована на создание кодовых агентов.
Обе модели поддерживают вызов функций (tool calling), то есть могут обращаться к внешним инструментам и сервисам. При этом Qwen3-Coder-Next работает только в режиме без рассуждений (non-thinking) и не генерирует блоки think. Это упрощает ее интеграцию в продакшен-сценарии.
Qwen3-VL: мультимодальные модели для изображений и документов
Qwen3-VL — семейство мультимодальных моделей, которые умеют работать не только с текстом, но и с изображениями и видео. Например, с их помощью можно анализировать фотографии, извлекать информацию из документов и описывать видеоматериалы.
В линейку входят две группы моделей:
Плотные: версии с 2, 4, 8 и 32 млрд параметров.
MoE: версии 30B-A3B и 235B-A22B.
Для каждой модели доступны варианты Instruct и Thinking. Первый предназначен для выполнения инструкций и ответов на запросы, второй — для задач, в которых полезно пошаговое рассуждение.
Контекстное окно составляет до 256 тыс. токенов. Модели также поддерживают распознавание текста на 32 языках.
Qwen3-Embedding и Reranker: модели для поиска и RAG
Эти модели предназначены для поиска информации и построения RAG-систем — решений, которые дополняют ответы языковой модели данными из внешних источников.
У них разные задачи:
Qwen3-Embedding преобразует текст в числовой вектор (эмбеддинг). Благодаря этому система может находить документы и фрагменты по смыслу, а не только по совпадению слов.
Qwen3-Reranker оценивает релевантность найденных фрагментов запросу и сортирует результаты по степени соответствия.
Обе линейки включают модели размером 0,6, 4 и 8 млрд параметров. Контекстное окно составляет 32 тыс. токенов, лицензия — Apache 2.0.
Для работы с изображениями и документами можно использовать мультимодальные модели Qwen3-VL. Специализированные VL-версии Qwen3-Embedding и Qwen3-Reranker в открытом доступе не представлены.
Instruct и Thinking: чем отличаются режимы
У моделей Qwen3 есть два режима работы:
Instruct выполняет запрос и сразу выдает ответ.
Thinking сначала анализирует задачу и последовательно прорабатывает решение, а затем формирует итоговый ответ.
В Qwen3 переключаться между режимами можно с помощью команд /think и /no_think. В обновлении 2507 для старших моделей варианты Instruct и Thinking стали доступны как отдельные модели. В младших версиях переключение с помощью команд может сохраняться — это зависит от способа запуска.
Режим Thinking полезен для задач, требующих сложных вычислений, логики и многоэтапного анализа. Однако на рассуждения уходит больше выходных токенов, поэтому ответ может обходиться дороже и занимать больше времени. Стоимость таких токенов зависит от провайдера и выбранного тарифа.
Модель | Тип | Архитектура и параметры | Контекстное окно | Для каких задач |
Qwen3 | Универсальная | Dense 0,6–32B; MoE 30B-A3B, 235B-A22B | 32К–128К (в 2507 — 262К) | Чат, анализ текста, перевод |
Qwen3-Coder, Coder-Next | Кодовая | MoE 480B-A35B; MoE 80B-A3B | 262К | Генерация кода, ИИ-агенты |
Qwen3-VL | Мультимодальная | Dense 2–32B; MoE 30B-A3B, 235B-A22B | 256К (до 1М) | Документы, изображения, видео |
Qwen3-Embedding | Эмбеддинги | 0,6B, 4B, 8B | 32К | Векторный поиск, RAG |
Qwen3-Reranker | Реранкер | 0,6B, 4B, 8B | 32К | Ранжирование результатов поиска |
Qwen3.5–3.8 | Универсальные | MoE 397B-A17B, 35B-A3B; dense 27B | 256К–262К (у части до 1М) | Чат, агенты, длинный контекст |
Qwen Max | Флагманская | Закрытые версии, доступ по API | До 1М | Сложные задачи |
Как пользоваться Qwen: три способа
Qwen можно использовать тремя способами: через веб-чат, локально или по API в облаке. У каждого варианта свои требования к ресурсам, стоимость запуска и особенности обработки данных. Поэтому важно заранее выбрать подходящий способ: от него зависит, насколько легко масштабировать решение, какие нагрузки оно выдержит и где будут обрабатываться запросы.
Так сохраняется исходный посыл, но текст читается легче и плавнее подводит к сравнению трех способов использования.
Веб-чат: быстрый старт и лимиты
В официальном Qwen Chat достаточно зарегистрироваться и выбрать модель. Базовый доступ бесплатный, но лимиты Qwen действуют на число сообщений и набор моделей, их актуальные значения смотрите в чате. Встроить чат в приложение нельзя, а переписка обрабатывается на стороне сервиса.
Локальный запуск через Ollama: требования к GPU и памяти
В Ollama Qwen доступен в нескольких размерах, а установить Qwen локально можно одной командой, например ollama run qwen3:8b. Ollama скачивает квантизованную версию в формате GGUF, а размер файла задает минимум видеопамяти. По данным библиотеки Ollama, файлы занимают:
qwen3:8b — 5,2 ГБ;
qwen3:14b — 9,3 ГБ;
qwen3:32b — 20 ГБ;
qwen3:235b — 142 ГБ.
Сверху нужен запас под контекст: 32B помещается на видеокарту с 24 ГБ при небольшом контексте. MoE-модели активируют мало параметров, но загружаются в память целиком; без видеокарты инференс на процессоре идет заметно медленнее. Выбор оборудования разбираем в материале про локальный запуск нейросетей.
API в облаке: без своего железа и с оплатой за токены
Qwen API предоставляют облачные платформы: ответы приходят по OpenAI-совместимому интерфейсу, а оплата идет за токены. Свой сервер не требуется, провайдер берет на себя масштабирование, и смена модели сводится к замене ее названия в запросе.

Критерий | Веб-чат | Локальный запуск | API в облаке |
Стартовые затраты | Нет | Видеокарта или мощный компьютер | Нет, оплата за токены |
Требования к оборудованию | Браузер | От 6 ГБ видеопамяти для 8B, сотни ГБ для крупных MoE | Нет, запрос по HTTP |
Контроль над данными | Низкий, обработка на стороне сервиса | Полный, данные остаются в вашем контуре | Зависит от провайдера и модели |
Масштабирование | Ограничено лимитами | Докупка GPU | Масштабирует провайдер в рамках лимитов |
Подходит для продакшена | Нет | Да, при готовой инфраструктуре и команде | Да |
Qwen или DeepSeek: что выбрать под задачу
Выбор Qwen или DeepSeek сводится к сравнению конкретных пар моделей: размеры в семействе Qwen различаются в сотни раз. Оценка «лучше» или «хуже» без привязки к задаче теряет смысл.
Различия в архитектуре, размерах и специализации моделей
Qwen и DeepSeek используют архитектуру MoE в своих крупных моделях, но отличаются масштабом и разнообразием линейки. Например, Qwen3-235B-A22B содержит 235 млрд параметров, из которых активны 22 млрд. У DeepSeek V4-Pro — 1,6 трлн параметров, из которых активны 49 млрд.
У Qwen шире выбор специализированных моделей: помимо универсальных, есть отдельные версии для программирования, работы с изображениями и видео, а также семантического поиска. DeepSeek V4 представлен в двух основных версиях: Pro и Flash.
Обе линейки поддерживают большие контекстные окна: у DeepSeek V4 — до 1 млн токенов, у некоторых новых моделей Qwen — также до 1 млн. Различаются и лицензии: DeepSeek V4 распространяется по MIT, большинство открытых моделей Qwen — по Apache 2.0.
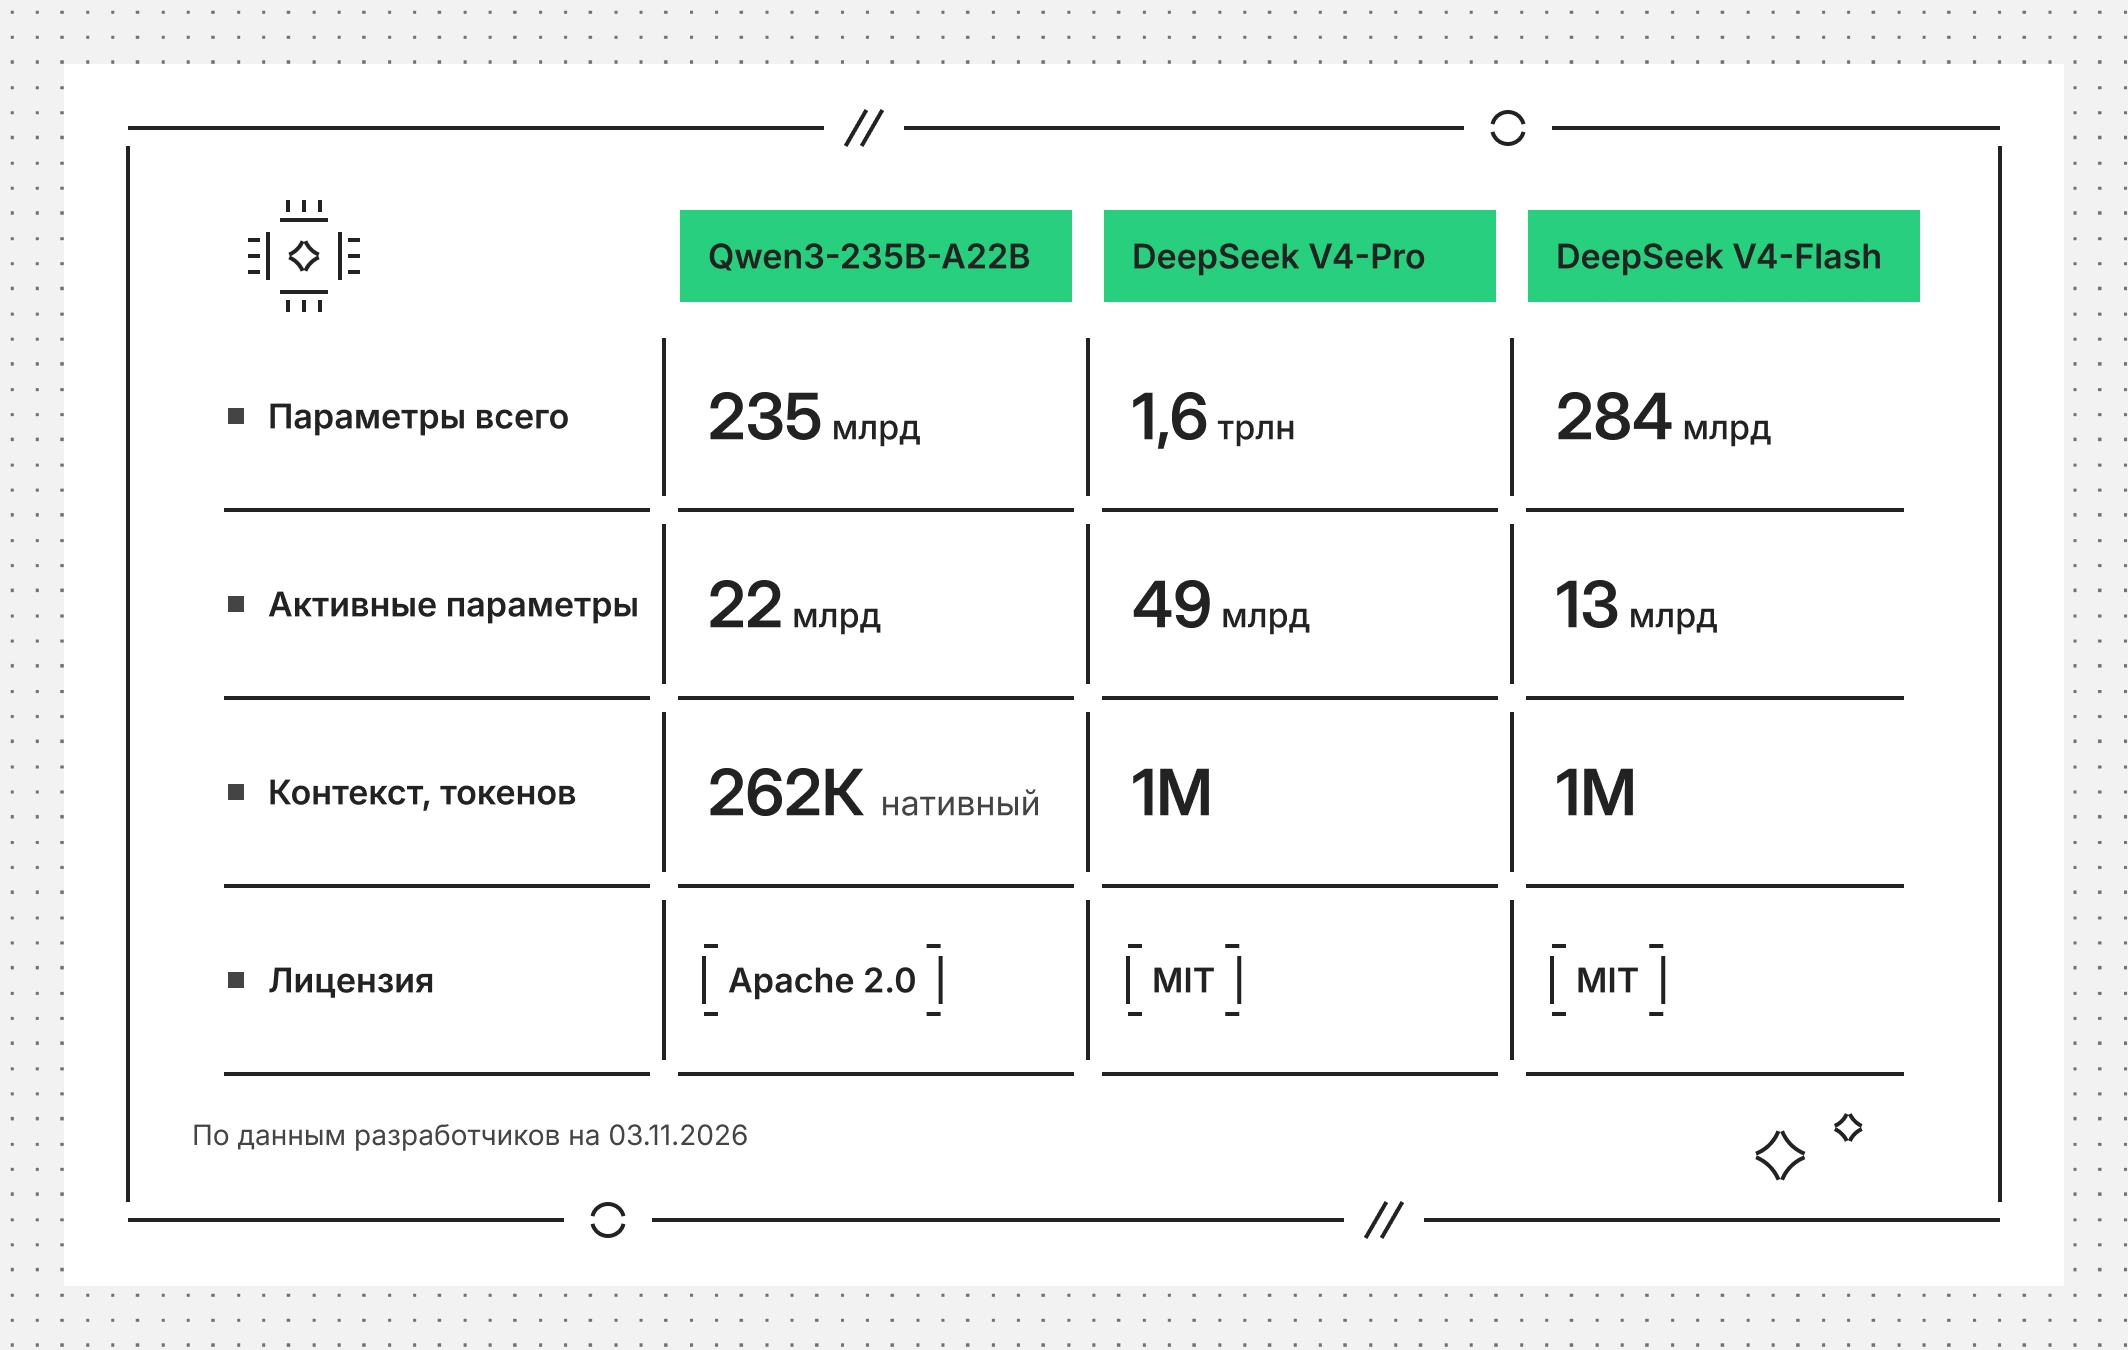 Параметры MoE-моделей Qwen и DeepSeek
Когда брать Qwen, а когда DeepSeek
Qwen стоит рассмотреть для небольших моделей на одной видеокарте, мультимодальности или связки LLM, эмбеддингов и реранкера из одного семейства. DeepSeek V4 подойдет для сценариев с крупной универсальной MoE-моделью и контекстом до 1 млн токенов. Прогоните обе модели на 20–30 реальных запросах и сверьтесь со сравнением нейросетей 2026 года.
Где Qwen применяют в бизнесе
В бизнесе Qwen берут под конкретную задачу, потому что размер и специализация модели определяют цену токена и скорость ответа. Небольшая специализированная версия обычно отвечает быстрее и стоит дешевле крупной универсальной.
Помощник разработчика на базе Qwen3-Coder
Qwen3-Coder пишет функции, проверяет pull request и генерирует тесты. Модель совместима с Qwen Code и Cline, а подключить Foundation Models к VS Code можно по документации. Решение о слиянии кода остается за командой: модель находит типовые ошибки, но контекст проекта знает человек.
Поиск по базе знаний: связка embedding-модели, реранкера и LLM
Qwen3-Embedding переводит документы и запрос в векторы, Qwen3-Reranker ранжирует найденные фрагменты, а LLM отвечает по лучшим из них. Этапы схемы разобраны в статье про то, как работает RAG. По тарифу Qwen3-Reranker-0.6B стоит около 0,85 ₽ за 1 млн токенов с НДС, так что реранкинг почти не влияет на бюджет. Готовый конвейер без разработки собирается в Evolution Managed RAG.
Обработка документов и изображений с Qwen3-VL
Qwen3-VL извлекает текст из сканов и таблиц, разбирает структуру длинных документов и отвечает на вопросы по изображениям, а принципы работы описаны в разборе мультимодальных нейросетей.
ИИ-агенты с вызовом инструментов
Qwen-агенты строят на tool calling: модель получает описание функций, выбирает нужную и формирует параметры, а приложение выполняет вызов к CRM, базе данных или API.
Как подключить Qwen в Evolution Foundation Models
В Evolution Foundation Models модели Qwen доступны по API без развертывания инфраструктуры: достаточно выпустить ключ и выбрать модель.
Какие модели Qwen доступны в каталоге
В каталоге Evolution Foundation Models доступно более 20 моделей семейства Qwen. Среди них есть универсальные модели Qwen3-30B-A3B и Qwen3-32B, кодовая Qwen3-Coder-Next, а также новые версии Qwen3.5-397B-A17B, Qwen3.6, Qwen3.7 и Qwen3.8.
Для работы с поиском и RAG доступны Qwen3-Embedding-0.6B и Qwen3-Reranker-0.6B. Для мультимодальных задач можно выбрать модели семейства Qwen3-VL.
Контекстное окно моделей в каталоге варьируется от 40 тыс. токенов у Qwen3-30B-A3B до 1 млн у Qwen3.8. Для Qwen3-30B-A3B это ограничение провайдера: нативное контекстное окно модели может быть больше. Актуальные характеристики и ограничения каждой версии можно посмотреть в ее карточке.
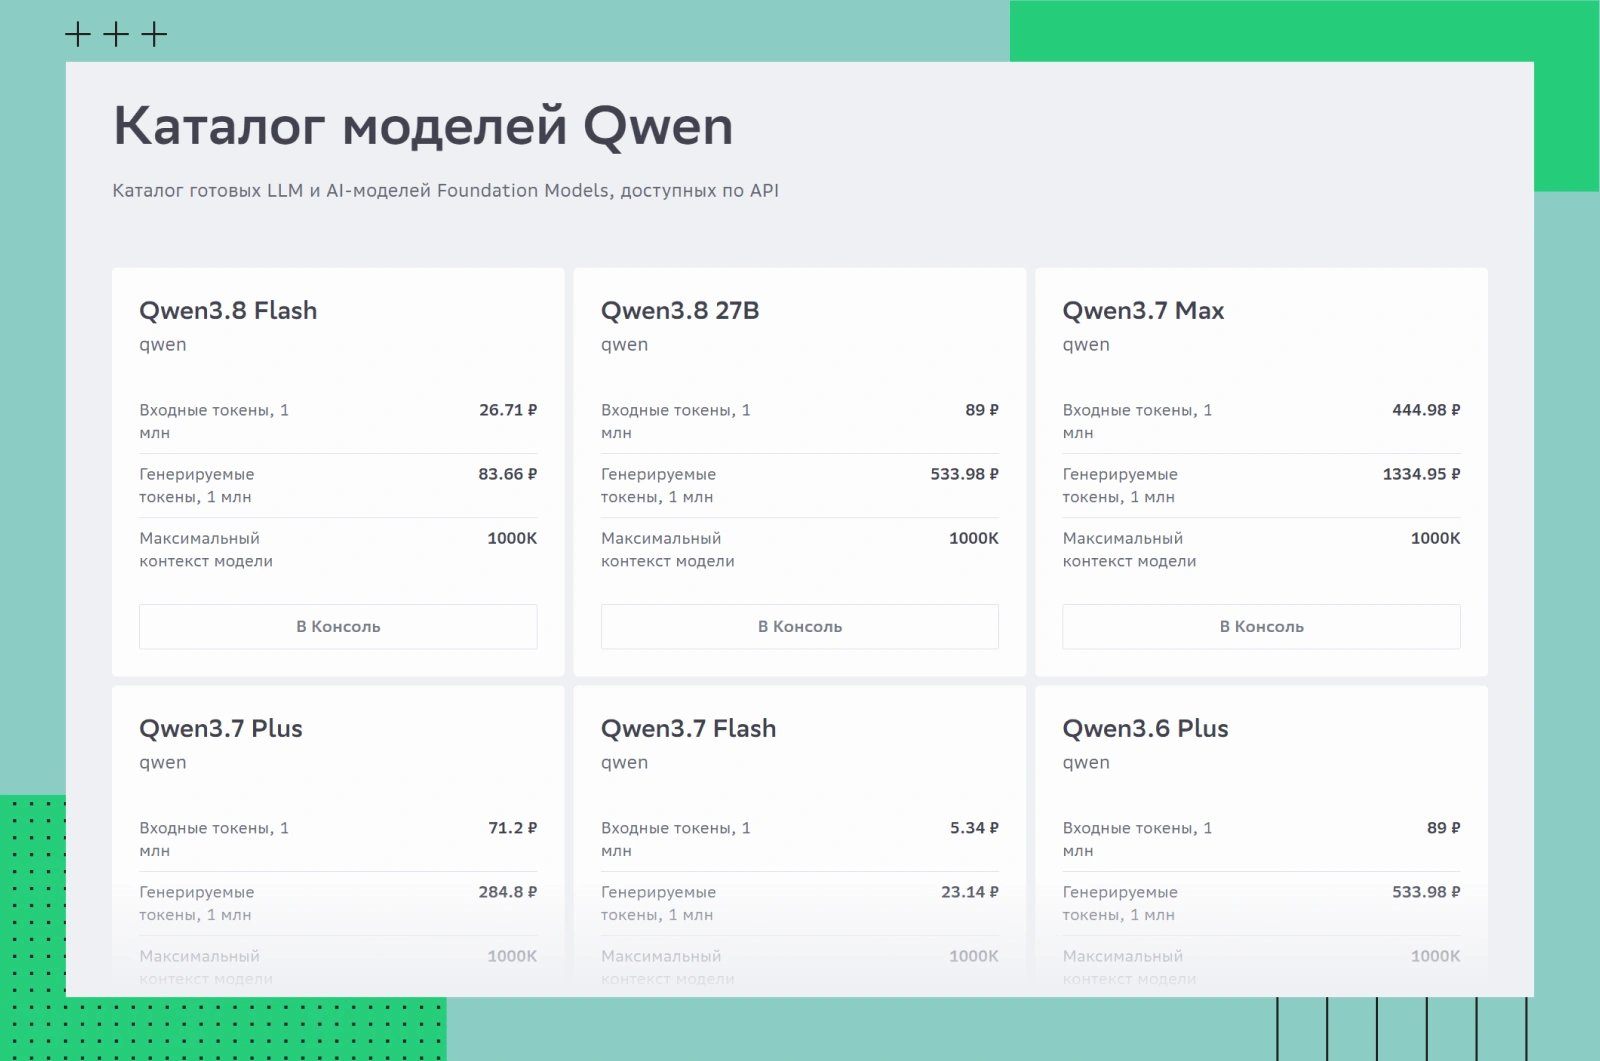 Модели Qwen в каталоге Evolution Foundation Models
OpenAI-совместимый API: подключение за несколько строк кода
Evolution Foundation Models поддерживает формат OpenAI API. Поэтому для подключения моделей Qwen можно использовать те же библиотеки и инструменты, что и для OpenAI API. При этом в коде достаточно указать адрес API и ключ доступа к Cloud.ru. Само подключение состоит из трех шагов:
Создайте сервисный аккаунт в разделе «Пользователи» → «Сервисные аккаунты».
Выпустите API-ключ для сервиса Foundation Models и сохраните Key Secret: повторно его не покажут.
Укажите в клиенте OpenAI адрес https://foundation-models.api.cloud.ru/v1 и модель из каталога.
Пошаговая инструкция есть в документации: как создать сервисный аккаунт и API-ключ. Запрос к модели на Python с библиотекой OpenAI выглядит так:
Модели развернуты на российских серверах, оплата по фактическому использованию
Cloud.ru указывает, что модели развернуты на российских серверах, а оплата идет по фактическому использованию: по тарифу Qwen3-Coder-Next стоит 122 ₽ за 1 млн входных и 244 ₽ за 1 млн выходных токенов с НДС. Часть моделей в тарифах помечена как партнерские: их запросы обрабатывает внешний провайдер, поэтому для персональных данных выбирайте модели без пометки (подробнее про внешние модели в Foundation Models). Чувствительные данные маскирует Guardrails.
Заключение
Qwen — семейство моделей для разных задач: работы с текстом и кодом, анализа изображений и видео, поиска по документам. Выбирать подходящую версию стоит с учетом ее возможностей, требований к вычислительным ресурсам и бюджета.
Способ запуска зависит от целей проекта. Для знакомства с моделями и экспериментов подойдут веб-чат или локальный запуск через Ollama. Если вы планируете использовать Qwen в продукте и ожидаете рост нагрузки, можно подключить модели через облачный API. Например, в Evolution Foundation Models доступны разные версии Qwen, которые можно сравнить на собственных запросах и выбрать подходящую для проекта.
FAQ
Qwen бесплатный?
Открытые модели можно скачать бесплатно по лицензии Apache 2.0. В веб-чате доступ бесплатный в пределах лимитов, через API платят за токены.
Понимает ли Qwen русский язык?
Да, Qwen3 обучали на 119 языках и диалектах, включая русский. Малые версии справляются хуже крупных, поэтому проверяйте модель на своих текстах.
Какую модель Qwen выбрать для программирования?
Для генерации и проверки кода подойдет Qwen3-Coder, для агентов — Qwen3-Coder-Next. При нехватке видеопамяти смотрите Qwen3-Coder-30B-A3B.
Сколько видеопамяти нужно, чтобы запустить Qwen локально?
Ориентир — размер квантизованного файла плюс запас под контекст: от 6–8 ГБ для 8B до 24 ГБ для 32B. Крупным MoE вроде 235B нужно несколько GPU.
Чем Qwen отличается от DeepSeek?
Qwen — широкая линейка с моделями для кода, изображений и поиска, а DeepSeek V4 выходит в версиях Pro и Flash. У DeepSeek лицензия MIT, у большинства открытых моделей Qwen — Apache 2.0.
Как подключить Qwen по API в России?
Через сервис с OpenAI-совместимым API: создайте ключ, укажите адрес и название модели. В Evolution Foundation Models оплата идет в рублях.
Можно ли использовать Qwen в коммерческих проектах?
Да, если это разрешает лицензия конкретной модели. У большинства открытых моделей Qwen — Qwen3, Qwen3-Coder, Qwen3-VL, Qwen3-Embedding и Qwen3-Reranker — это Apache 2.0. У флагманской Qwen3.8-2.4T-A95B — кастомная Qwen3.8-Max License с ограничениями для крупных коммерческих пользователей.