Локальные нейросети 2026: лучшие модели и инструменты — обзор
Локальный запуск ИИ перестал быть задачей со звездочкой — появились готовые модели, удобные оболочки и инструменты для развертывания нейросетей на собственном оборудовании. Ниже — гайд по популярным решениям и требования к ресурсам.


Что такое локальные нейросети
Локальные нейросети — это модели, которые запускаются на компьютерах или серверах пользователя. Данные обрабатываются на собственном оборудовании и не передаются внешним сервисам, если модель и все связанные с ней инструменты работают локально. Такой подход позволяет использовать нейросеть без постоянного подключения к интернету и лучше контролировать работу с данными.
При этом локальный запуск требует собственных вычислительных ресурсов и технической поддержки. Для небольших моделей и простых задач может хватить обычного компьютера. Но при высокой нагрузке, работе с крупными моделями или одновременных запросах нескольких пользователей может потребоваться серверная инфраструктура с GPU, достаточным объемом памяти и системами хранения данных. Также нужно следить за обновлениями моделей, доступностью сервисов и состоянием оборудования.
Публичные чат-боты ChatGPT, Claude, Gemini — модель на серверах провайдера
Публичные чат-боты — самый простой способ начать работать с нейросетями. Не нужно устанавливать модели и настраивать инфраструктуру: достаточно открыть чат и отправить запрос. Но у такого подхода есть ограничения. Запросы обрабатываются на стороне провайдера, поэтому для работы с конфиденциальными данными нужно учитывать условия обработки и хранения информации.
Еще один нюанс — лимиты на количество запросов и объем использования. У платных тарифов они могут быть выше, но при постоянной высокой нагрузке стоимость публичных сервисов может оказаться выше, чем у локального решения.
Наконец, для работы с публичными чат-ботами нужен интернет. Если соединение пропадет или сервис провайдера будет недоступен, обратиться к модели не получится. Для бизнеса это означает зависимость рабочих процессов от доступности внешнего сервиса.

Есть еще один вариант: использовать модели через облачную платформу Cloud.ru. Сервис Evolution Foundation Models позволяет обращаться к моделям в инфраструктуре Cloud.ru, не разворачивая их на собственных серверах.
При этом данные пользователей не логируются и не хранятся в Cloud.ru, а запросы не передаются во внешние системы. Такой подход позволяет использовать облачные вычислительные ресурсы и при этом учитывать требования к конфиденциальности данных. Это может быть актуально для компаний, которые работают с корпоративной информацией и должны соблюдать требования 152-ФЗ.
Сравнение подходов, включая облачный:
Критерий | Локальная нейросеть | Публичный чат‑бот | Cloud.ru Foundation Models |
Данные | На вашем железе | У провайдера | Внутри инфраструктуры Cloud.ru |
Интернет | Не нужен | Обязателен | Нужен |
Большие модели | Ограничены железом | Есть | Есть |
Стоимость | Железо + электричество | Подписка | По токенам |
Какие нейросети можно установить локально
Сценарий подходит не только для текстовых моделей. На своем оборудовании можно развернуть разные виды локальных нейросетей для генерации изображений, видео, работы с мультимодальными данными. Выбор упирается в задачи и доступные мощности.
LLM — текстовые помощники
Это самый развитый класс для локального запуска. Модели подходят для генерации текста, программирования, анализа, ответов на вопросы. Они помогают в разных рабочих задачах: составлении отчетов, извлечении информации из файлов, объяснении кода, структурировании данных.
Можно выбрать компактную версию, рассчитанную на обычный компьютер либо крупную, которая ляжет на мощное оборудование. Оценивайте не только качество ответов модели, но и доступные вычислительные ресурсы. Если мощностей мало, LLM не запустится или не оправдает ожиданий.
Нейросети, которые работают с визуалом
Подходят для генерации изображений (Stable Diffusion) локально, обработки видео (DeepFaceLab) и распознавания объектов в системах компьютерного зрения. Для комфортной работы требуется мощная GPU с достаточным объемом видеопамяти. Чем сложнее модель и выше требования к генерации, тем больше вычислительных ресурсов нужно.
Локальный запуск особенно полезен, если визуальных данных много. Можно обрабатывать их у себя, не отправляя каждый раз запросы во внешние сервисы и даже автоматизировать эти процессы.
Звуковые нейросети
Используются для работы с аудио и речью. Одни модели умеют распознавать голос и локально выполнять транскрипцию (Whisper) интервью, лекций, звонков, голосовых сообщений. Другие — синтезируют речь из текста и подходят для создания аудиоконтента, озвучки, голосовых помощников.
Звуковые модели относительно компактные и могут работать даже без GPU. Мощная видеокарта нужна, если хочется больше скорости при обработке больших объемов аудио.
Мультимодальные локальные LLM
Это модели, которые могут понимать разные типы данных: текст, картинки, аудио. Пример — Gemma 4 26B A4B с поддержкой текста, изображений и видео (до 60 секунд при 1 кадре в секунду). Она подходит для анализа объектов на фото, описания видеозаписей и ответов на вопросы по визуальному содержимому. Нативная поддержка аудио есть только в моделях E2B и E4B.
Требования к железу зависят от размеров моделей, типа данных. Для действий с текстом и изображениями могут подойти обычные компьютеры с достаточным объемом оперативной памяти и видеопамяти. Для обработки аудио и видео в реальном времени нужно больше вычислительных ресурсов.
Преимущества локальных нейросетей
Запуск на своих устройствах дает контроль над работой модели и операциями с данными. Это особенно заметно в задачах, где важны конфиденциальность, автономность и возможность самостоятельно настраивать нейросеть. Преимущества можно сформулировать так:
Приватность данных — промпты и документы не покидают устройство, что важно для юридических, медицинских и корпоративных задач.
Работа без интернета — нужна для промышленных объектов и изолированных сред, в поездках. Это единственный сценарий, где облако не заменяет локальный запуск.
Отсутствие лимитов на запросы — можно гонять батч-задачи сколько угодно.
Кастомизация — fine-tuning на своих данных, изменение параметров модели, полный контроль над конфигурацией.
Чем больше нейросеть интегрируется в рабочие процессы, тем заметнее преимущества локального запуска. Модель можно адаптировать под свои задачи и исключить зависимость от ограничений готового сервиса, особенно бесплатного.
Несмотря на то, что MoE-модели активируют лишь часть параметров при генерации каждого токена, все параметры должны быть загружены в память для быстрого роутинга. Например, Gemma 4 26B A4B активирует 3.8B параметров, но требует загрузки всех 26B. Это объясняет, почему требования к VRAM у MoE-моделей значительно выше, чем можно было бы предположить исходя из количества активных параметров.
Топ-9 локальных нейросетей в 2026 году
Нужно стремиться не просто выбрать одну модель для множества задач, а вписаться в требования к вычислительным ресурсам и оборудованию. Ниже — топовые решения и их характеристики.
Локальные модели для генерации текста, анализа, программирования
Сам V3.2 не имеет компактных дистиллятов. Для локального запуска используйте дистилляты DeepSeek-R1. Описание популярных вариантов для личных и рабочих задач:
DeepSeek V3.2. MoE-модель на 685 млрд параметров, из которых 37 млрд активны при обработке одного запроса. Для локального запуска на потребительском оборудовании используйте дистилляты DeepSeek-R1: версии 7B и 14B. Дистиллят 7B работает с 8 ГБ VRAM, 14B требует около 16 ГБ в 4-битном квантовании. Лицензия DeepSeek-R1 — MIT.
Qwen3.6-35B-A3B. MoE-модель с 35 млрд общих параметров и 3 млрд активных, лицензия Apache 2.0. Поддерживает множество языков, включая русский. На бенчмарке AIME 2026 набирает 92.7%, на GPQA — 86.0%. Для локального запуска в 4-битном квантовании достаточно около 20 ГБ VRAM.
Gemma 4 26B A4B. MoE-модель с 26 млрд общих и 3.8 млрд активных параметров, лицензия Apache 2.0. Поддерживает текст, изображения и видео. Для инференса в 4-битном квантовании требуется около 14.4 ГБ видеопамяти. Модель 31B Dense — отдельный вариант, подходит для серверных задач и показывает более высокие результаты на бенчмарках.
GPT-OSS-120B. Открытая MoE-модель от OpenAI с 120 млрд параметров. Для локального запуска достаточно одной GPU класса H100 (80 ГБ) или нескольких GPU с общим объемом VRAM от 60 ГБ. Для обычных компьютеров не подходит, относится к серверному классу.
ГигаЧат от Сбера. Российская модель, которая хорошо знает локальную специфику и русский язык. Это большой плюс, поскольку зарубежные решения не всегда правильно понимают контекст. Доступна через API и в on-premise версии для компаний.
Mathstral. Специализированное решение для математических вычислений и STEM-задач. Весит всего 7B, поэтому может запускаться на 8 ГБ VRAM. Специализирована на математических и STEM-задачах.
Модели для создания графики и видео
Такие решения сейчас в стадии активного развития. Зарекомендовавшие себя представители этого класса:
Stable Diffusion 3.5 Large. Выполняет генерацию изображений по текстовому описанию. Абсолютный минимум — 8 ГБ VRAM с оптимизациями (offloading), для комфортной работы рекомендуется 12+ ГБ. Запускается через ComfyUI. В 2026 году также актуальны модели семейства Flux.
DeepFaceLab. Умеет работать с видео: менять лица, синтезировать видеоряд. Предъявляет высокие требования к VRAM. Для получения качественных результатов нужно 16+ ГБ.
Модели для создания аудио
В этой категории одной из самых популярных является Whisper.cpp — доступный инструмент для распознавания и транскрипции речи. По точности приближается к облачным сервисам, поддерживает русский язык и может работать без GPU.
Оболочки для запуска моделей
Можно использовать удобный графический интерфейс со встроенным каталогом — GPT4All. Совместим с Windows, macOS и Linux. Не требует навыков работы с командной строкой, поэтому подходит для пользователей без технических знаний.
Для быстрого тестирования разных моделей подойдет LM Studio. Есть встроенный сервер с OpenAI-совместимым API, благодаря чему можно подключать внешние приложения.
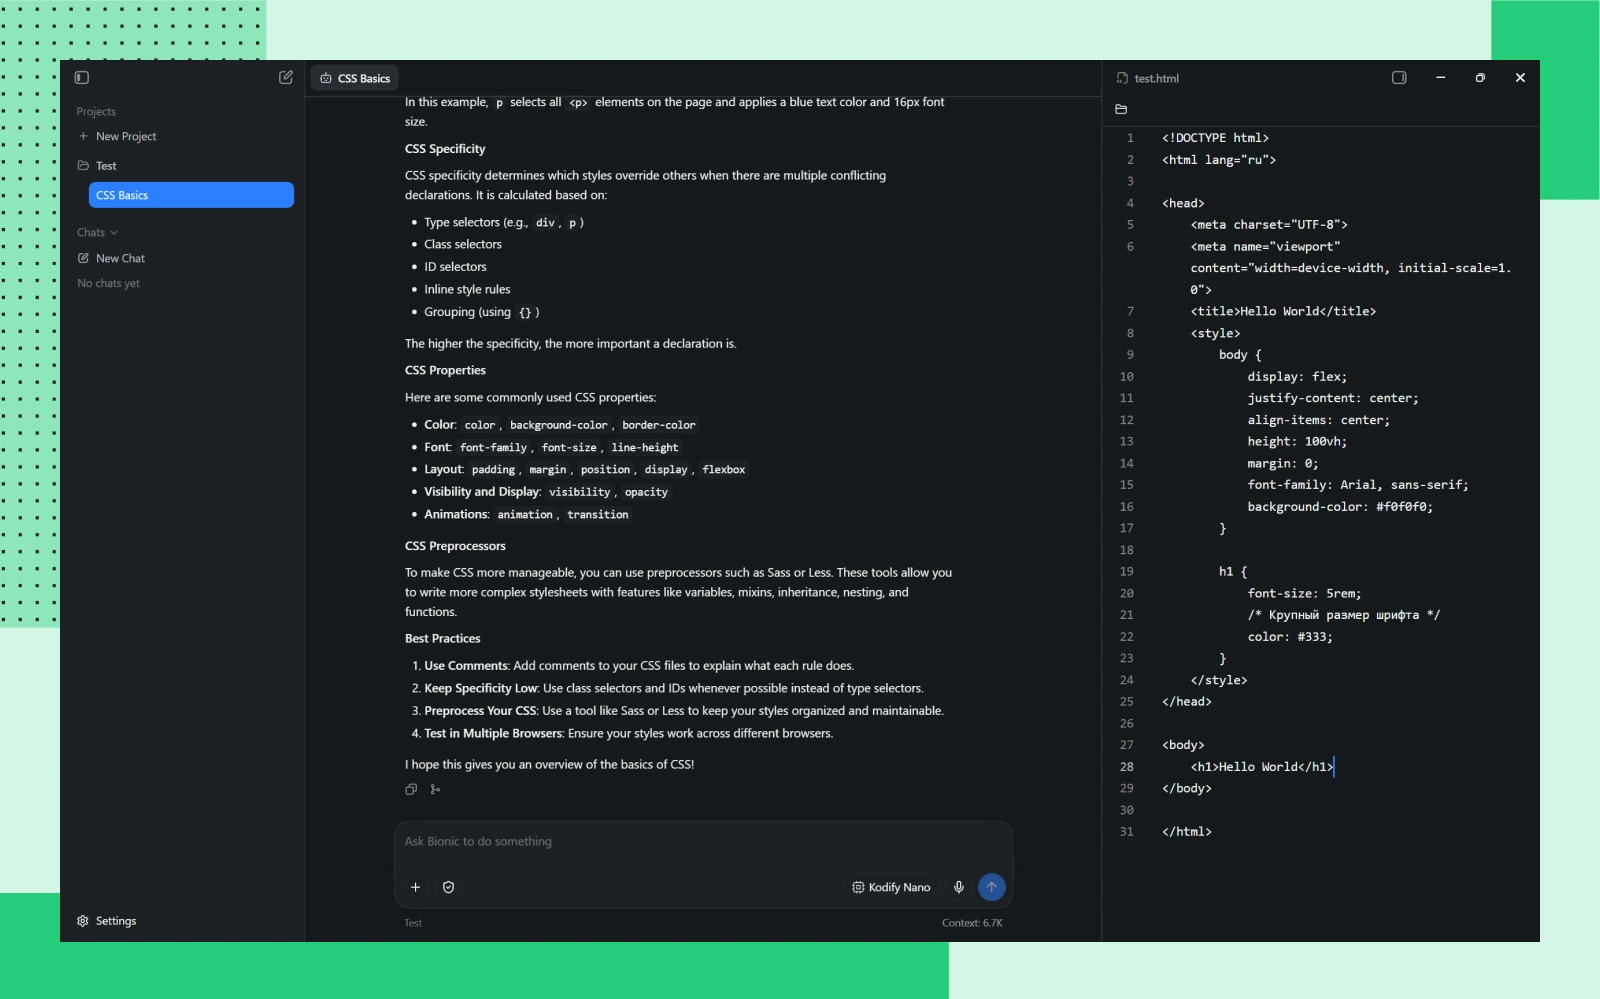 Использование оболочки для тестирования моделей
Преимущества и ограничения локальных нейросетей и облака
Сравним в таблице два подхода — локальный запуск и сервис Cloud.ru Foundation Models:
Критерий | Локально | Cloud.ru Evolution Foundation Models |
Приватность | Полная | Данные не логируются и не хранятся |
Большие модели (70B+) | Требуется дорогое железо | Доступны сразу |
Оффлайн-работа | Да | Нет |
Стоимость старта | Железо от 50К руб | Оплата по токенам |
Настройка | Требует времени | Минуты через API |
Fine-tuning | Доступен | Через Evolution ML Finetuning |
Локальная модель с ростом количества пользователей достаточно быстро упрется в возможности оборудования. Если использовать ее для рабочих задач, придется расширять GPU или докупать сервер. В облаке вычислительные ресурсы можно масштабировать под нагрузку.
Заключение
Выбор локальной нейросети зависит от задач, требований к конфиденциальности и доступных вычислительных ресурсов. Для простых сценариев может хватить модели на 7–14 млрд параметров, запущенной на обычном ноутбуке. Более высокая нагрузка и крупные модели потребуют производительного оборудования, например Mac с чипом M5 Max или компьютера с RTX 4090.
Если нужно работать с моделями от 70 млрд параметров или обеспечивать постоянную production-нагрузку, можно рассмотреть гибридный подход: локальный запуск для одних задач и Evolution Foundation Models Cloud.ru через OpenAI-совместимый API для других. Это позволяет выбирать способ развертывания с учетом требований конкретного сценария.
FAQ
Что такое локальная нейросеть, как ее развернуть и запустить?
Это модель, которая работает на компьютере или сервере пользователя. Нужно скачать ее веса и запустить через специальную среду.
Какую нейросеть лучше запустить локально в 2026?
Для текста и программирования можно использовать Qwen, Gemma, DeepSeek и другие LLM с открытыми весами. Для мультимодальных задач подойдут модели, которые умеют работать не только с текстом. Если будет запуск на обычном компьютере, стоит смотреть в сторону компактных версий.
Какой компьютер нужен для запуска LLM?
Для небольших моделей хватит компьютера с 16 ГБ оперативной памяти. Например, LM Studio рекомендует от 16 ГБ RAM для Windows и macOS. Крупные модели требуют больше памяти, мощную видеокарту или сервер.
Можно ли запустить нейросеть без видеокарты?
Да. LLM можно запускать на процессоре, хотя скорость работы будет зависеть от модели и характеристик компьютера. На практике падение производительности относительно GPU может составлять от 10 до 20 раз, поэтому для интерактивной работы CPU-режим подходит только для компактных моделей.
LM Studio или GPT4All — что выбрать новичку?
Обе программы подходят. LM Studio делает акцент на запуске разных LLM, GPT4All ориентирован на удобный чат с моделями. Стоит выбирать по доступным функциям.
Работают ли локальные нейросети с русским языком?
Русский поддерживают многие модели, но не все хорошо понимают контекст. В локальных сценариях можно использовать мультиязычные Qwen. В Foundation Models Cloud.ru есть ГигаЧат и другие модели с поддержкой русского языка.
Насколько локальные модели уступают ChatGPT?
Локальная LLM может проигрывать в сложном рассуждении, но при этом хорошо справляться с обычным текстом, кодом или извлечением информации из документов. Кроме того, сравнивать нужно конкретные версии моделей, а не локальные нейросети в целом.