Платформа для развертывания ИИ-агентов: требования к инфраструктуре
Собрать ИИ-агента на фреймворке и запустить его на ноутбуке можно за неделю. Этого достаточно, чтобы проверить гипотезу или автоматизировать типовую задачу. Но для промышленной эксплуатации нужны дополнительные возможности: обработка высокой нагрузки, масштабирование, защита данных и соответствие требованиям информационной безопасности.
Чтобы обеспечить их, компании используют платформы для развертывания ИИ-агентов. Такие платформы объединяют инфраструктуру и инструменты, необходимые для запуска агентов, интеграции с корпоративными системами, мониторинга и управления доступом.
В статье разберем шесть ключевых слоев такой платформы, требования к каждому из них и критерии выбора решения.


- Из чего состоит платформа для ИИ-агентов: шесть слоев
- Вычисления: сколько GPU нужно агенту
- Модели: каталог, версии и контроль качества
- Данные и память: RAG, векторная база, хранилище
- Оркестрация и интеграции: MCP, A2A, мультиагентные системы
- Эксплуатация и безопасность: что проверит ИБ-аудит
- Как построить инфраструктуру ИИ-агентов на Cloud.ru
- Чек-лист: 12 требований к платформе перед выбором
Из чего состоит платформа для ИИ-агентов: шесть слоев
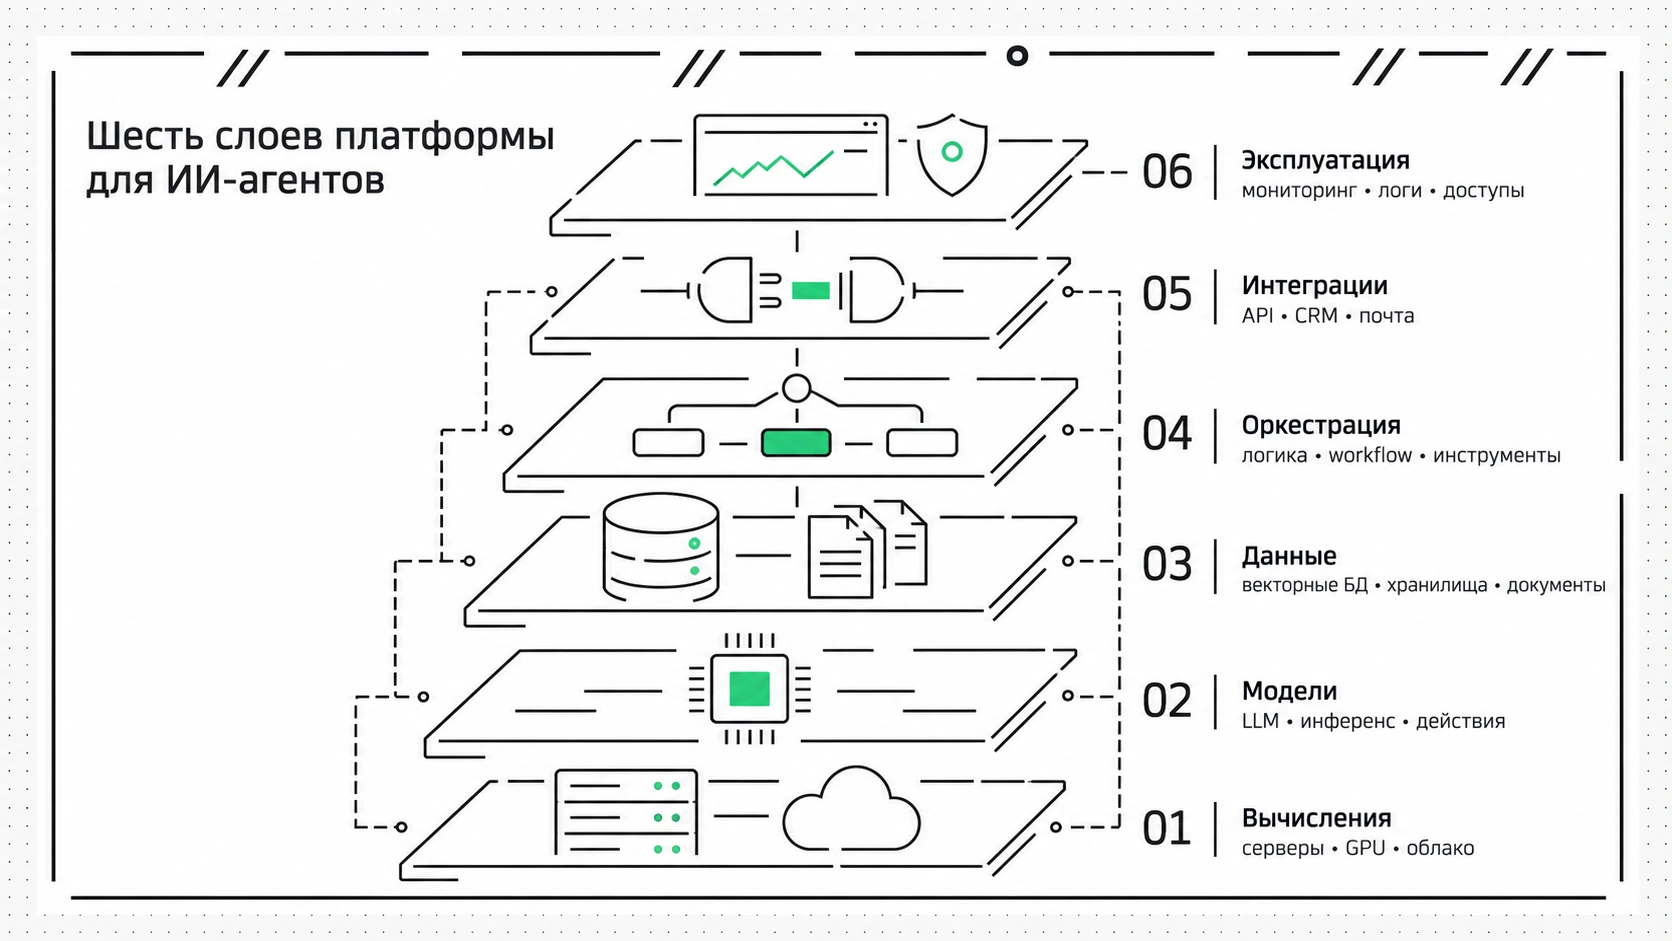
Корпоративная ИИ-платформа — сложный технологический стек вокруг большой языковой модели. Его можно разделить на шесть взаимосвязанных слоев:
Вычисления. По сути это инфраструктура для ИИ: серверы, GPU, облачные мощности и другие компоненты, необходимые для работы агента. Она обеспечивает скорость обработки данных и обучение модели.
Модели (LLM, Large Language Model). Основа автономной интеллектуальной системы, которая может работать с данными, генерировать ответы, совершать действия и принимать решения.
Данные. Память модели и контекст. В платформе слой представлен векторными базами данных, хранилищами, корпоративными документами. Эти компоненты дают ИИ-агенту кратковременную и долгосрочную память.
Оркестрация. Оркестратор — «мозг» и главный координатор системы, который управляет логикой работы ИИ-агента.
Интеграции. API-интерфейсы, плагины и коннекторы к внешним сервисам (CRM, почте, базам данных). Позволяют ИИ-агентам получать данные и выполнять действия для достижения цели.
Эксплуатация. Слой, где обеспечивается наблюдаемость и безопасность. Здесь задействованы инструменты мониторинга, логирования, отладки, контроля прав доступа.
Все слои платформы должны быть готовы к промышленной нагрузке. Если хотя бы один из них станет узким местом, масштабировать ИИ-агента будет сложнее. Поэтому при выборе платформы важно оценивать архитектуру целиком, а не отдельные компоненты. Это поможет заранее выявить ограничения и снизить риски при переходе к промышленной эксплуатации.
 Платформа для ИИ-агентов
Вычисления: сколько GPU нужно агенту
Количество GPU зависит от задач ИИ-агента и ожидаемой нагрузки: какие операции он будет выполнять, сколько пользователей будет работать с ним одновременно и как часто агент будет обращаться к языковой модели.
Расчет VRAM: веса модели + KV-кеш + буферы фреймворка на примере модели 32B в 4-битной квантизации
VRAM (Video Random Access Memory) — оперативная память, оптимизированная под параллельные математические вычисления графического процессора. Нужный объем зависит от весов модели, KV-кеша для контекстов памяти под runtime и промежуточных вычислений. Формула для расчета выглядит так:
Для модели 32B в 4-битной квантизации возьмем следующие показатели:
Расшифруем:
32 млрд × 0,57 ≈ 18–20 ГБ — память под веса модели в квантизации Q4_K_M (стандарт для локального развертывания). Коэффициент 0,57 байта на параметр учитывает метаданные и масштабирующие коэффициенты формата. Теоретический минимум 4 бита = 0,5 байта/параметр дает 16 ГБ, но на практике формат требует больше.
8 ГБ — условная оценка KV-кэша для четырех одновременных запросов с контекстом до 8192 токенов. Точный объем сильно варьируется: зависит от числа KV-голов, размерности головы, количества слоев и типа внимания. Модели с MLA или линейным вниманием (например, GigaChat 3.5) требуют в разы меньше KV-памяти на токен.
2–4 ГБ — память под runtime и служебные буферы.
Если модели требуется более 28 ГБ видеопамяти (VRAM), GPU с 24 ГБ, например RTX 4090, L4 или A10G, могут не справиться с высокой одновременной нагрузкой.
При этом модель на 32 млрд параметров в формате INT4 можно запустить на GPU с 24 ГБ памяти, если использовать небольшой контекст и обрабатывать запросы по одному. В этом случае на веса модели потребуется около 18–19 ГБ, еще 4–6 ГБ займет KV-кэш, который хранит данные для обработки контекста.
Для промышленной эксплуатации, особенно при работе с длинными контекстами и несколькими одновременными запросами, лучше выбрать GPU с 48 ГБ видеопамяти или два GPU по 24 ГБ с использованием tensor parallelism, который распределяет вычисления между видеокартами.
Инференс-сервер: vLLM, TensorRT-LLM, батчинг и целевые задержки для диалоговых и фоновых агентов
Инференс-сервер запускает обученную модель и обрабатывает запросы к ней. От его настройки зависят скорость генерации ответов, количество запросов, которые система может обрабатывать одновременно, и эффективность использования ресурсов GPU.
Для организации инференса используют, например, vLLM и TensorRT-LLM. Они помогают оптимизировать обработку запросов и использование видеопамяти.

Как vLLM управляет памятью. В основе vLLM лежит PagedAttention — механизм управления KV-кешем, в котором хранятся промежуточные данные для обработки контекста. Он разбивает кеш на блоки, которые могут размещаться в разных участках видеопамяти. Это снижает потери памяти из-за фрагментации и помогает эффективнее обслуживать несколько запросов одновременно.
Зачем нужен батчинг. Батчинг (batching, пакетирование) объединяет несколько запросов для совместной обработки на GPU. Это позволяет повысить пропускную способность инференс-сервера и эффективнее использовать вычислительные ресурсы. При этом размер батча нужно подбирать с учетом доступной памяти, нагрузки и требований к скорости ответа.
Как выбрать целевые задержки. Для диалоговых агентов важна скорость ответа: длительное ожидание ухудшает пользовательский опыт. Поэтому при настройке инференса нужно контролировать задержку до первого токена и скорость дальнейшей генерации. Для фоновых агентов, которые выполняют задачи без непосредственного участия пользователя, скорость ответа обычно менее критична. В таких случаях можно отдавать приоритет пропускной способности и обрабатывать больше запросов одновременно, если это не нарушает установленные сроки выполнения задач.
Когда брать выделенный GPU-сервер, а когда — модели по API с оплатой за токены
Все зависит от двух факторов — ожидаемой нагрузки и требований к обработке данных. API с оплатой за токены удобнее для проектов с переменной нагрузкой. Также это подходящий вариант для быстрого запуска. Не нужно покупать или арендовать GPU, настраивать инференс-сервер и самостоятельно поддерживать инфраструктуру.
Выделенный GPU-сервер подходит, если:
нагрузка постоянная и высокая;
данные нельзя выносить за пределы внутреннего контура;
нужен полный контроль над настройками и работой ИИ-агента.
При маленькой нагрузке и постоянном простое собственный GPU обойдется дороже модели по API из-за расходов на оборудование и его обслуживание.
Сразу сделать выбор получается не всегда, поскольку сложно спрогнозировать нагрузку. Разумнее начать с аренды, собрать показатели и сравнить стоимость обработки запросов с постоянными затратами на собственную инфраструктуру.
Модели: каталог, версии и контроль качества
Корпоративная ИИ-платформа может работать с несколькими моделями. Одни подходят для обработки больших данных, другие — для простых задач, третьи — для анализа. При проектировании архитектуры нужно заложить возможность замены модели без переделки логики агента.
Единый API к нескольким моделям и возможность менять модель без переписывания агента
Чтобы не подключать каждого агента напрямую к модели, можно использовать API. Агент отправляет запрос, а платформа сама определяет, какую LLM задействовать.
Если модель нужно заменить или обновить, достаточно перенастроить API, не затрагивая логику агента. Это позволяет тестировать разные LLM на одинаковых задачах и выбирать подходящие по скорости, качеству работы и стоимости.
Дообучение и собственные модели: когда нужны и что для них требуется
Дообучение требуется, если нужно изменить устойчивое поведение модели. Ее можно научить выдавать ответы определенного формата, использовать терминологию, точнее выполнять задачи. В таких случаях недостаточно добавить свежие данные через RAG и внешнюю базу. Нужны релевантные примеры и дополнительные вычислительные ресурсы. После дообучения модель проверяют на тестовых данных и сравнивают с исходной версией.
Если нужен полный контроль над информацией и процессами, компании используют собственные модели вместо дообученных готовых. Бизнес берет на себя ответственность за обучение, инференс, хранение, обновления и мониторинг.
Данные и память: RAG, векторная база, хранилище
ИИ-агенту для выполнения задач могут понадобиться внутренние документы, переписки, инструкции и другие данные. Их хранят отдельно и передают модели по мере необходимости. Для этого используют RAG и разные типы хранилищ.
Требования к RAG: индексация, права доступа на уровне документов, обновление базы знаний
RAG (Retrieval-Augmented Generation, дополненная генерация) позволяет языковой модели использовать внешние источники знаний при подготовке ответов. Благодаря этому не нужно дообучать модель при каждом изменении данных: достаточно своевременно обновлять базу знаний, из которой агент получает информацию.
Чтобы RAG работал корректно, документы нужно подготовить и проиндексировать. Для этого их разбивают на фрагменты и преобразуют содержимое каждого фрагмента в числовое представление — эмбеддинг. При поступлении запроса система находит наиболее релевантные фрагменты и передает их языковой модели для подготовки ответа.
Еще одно важное требование — разграничение доступа к документам. Например, менеджер не должен получать через ИИ-агента данные из бухгалтерских отчетов, если у него нет соответствующих прав. Для этого система должна учитывать права пользователя при поиске и исключать из результатов документы и фрагменты, к которым у него нет доступа.
База знаний также должна регулярно обновляться, чтобы агент учитывал актуальные данные и не использовал устаревшую информацию.
Хранилища: объектное S3 для документов, векторная база для эмбеддингов, PostgreSQL для состояния агента
Для разных типов данных используют разные хранилища:
Документы, файлы и другие исходные материалы удобно хранить в объектном S3.
Для эмбеддингов и связанных с ними данных оптимальна векторная база. Она позволяет искать фрагменты документов, по смыслу близких к запросам.
Для хранения состояния агента (истории выполнения задач, настроек, статусов, идентификаторов сессий) подходит PostgreSQL.
Данные разделяют, чтобы не смешивать документы, поисковые индексы, рабочее состояние системы. В разных хранилищах проще масштабировать эти компоненты и поддерживать их актуальность.
Оркестрация и интеграции: MCP, A2A, мультиагентные системы
ИИ-агенту для работы нужен доступ к разным системам, базам данных и внешним сервисам. Если агентов несколько, они должны «общаться» друг с другом. Важно определить, какие стандарты и протоколы помогут это организовать.
MCP-серверы
MCP (Model Context Protocol) — открытый протокол, который позволяет ИИ-агентам взаимодействовать с внешними источниками данных и инструментами. С его помощью можно подключать CRM, тикет-системы, корпоративные базы знаний и другие сервисы.
MCP использует клиент-серверную архитектуру: агент выступает клиентом, а MCP-сервер предоставляет ему доступ к определенным данным и операциям во внешней системе. Например, агент может находить информацию о клиентах, создавать заявки или получать сведения из корпоративных сервисов.
Для каждой подключаемой системы можно настроить отдельный MCP-сервер и определить доступные операции. Например, разрешить агенту просматривать данные о клиентах, но запретить изменять или удалять записи. Так агент получает только те инструменты и права, которые нужны для выполнения его задач, без полного доступа к подключенным системам.
Мультиагентная система: координация нескольких агентов по протоколу A2A и ограничение прав каждого
Мультиагентная система (МАС) — концепция использования группы цифровых агентов, которые могут делить задачи и обмениваться данными. Цепочкой управляет оркестратор: определяет порядок действий, распределяет шаги между агентами, получает результат и передает его пользователю. Обмениваться данными помогает протокол A2A (Agent2Agent).
A2A (Agent-to-Agent) — открытый стандарт межплатформенного взаимодействия агентов, разработанный Google и переданный в открытое сообщество. Позволяет агентам, построенным на разных фреймворках и работающим на разных серверах, обнаруживать друг друга через Agent Card, делегировать задачи и координировать выполнение поверх HTTP с использованием JSON-RPC 2.0. Обнаружение агентов происходит через Agent Card — JSON-метаданные, публикуемые по стандартному пути /.well-known/agent.json.
Обмен данными происходит через JSON-RPC 2.0: агенты отправляют типизированные сообщения (текстовые и структурированные), а каждая задача проходит через формализованные состояния — от submitted до completed или failed. Это позволяет обрабатывать как синхронные запросы, так и длительные асинхронные процессы.
Например, агент поддержки может поручить агенту поиска найти в CRM информацию о клиенте, а затем передать результаты агенту, который подготовит отчет. Каждый агент выполняет свою часть работы, а оркестратор координирует процесс и помогает получить итоговый результат.
Для взаимодействия агентов, в том числе работающих на разных платформах и фреймворках, можно использовать протокол A2A (Agent2Agent). Он позволяет передавать задачи и обмениваться результатами между агентами.
При этом каждому агенту необходимо назначить права доступа в соответствии с его задачами, придерживаясь принципа минимальных привилегий. Например, агент поиска может только читать документы, а агент CRM — создавать и изменять записи в пределах разрешенных операций. Так каждый агент получает доступ только к тем данным и действиям, которые необходимы для его работы.
Для этих задач можно использовать свою или managed-платформу.
Критерий | Самосборная платформа | Управляемая платформа |
Срок запуска | Долго — нужно собрать и настроить компоненты | Быстро — многие компоненты уже готовы |
Команда | Нужны разработчики, ML и DevOps | Часть задач на провайдере |
Стоимость сопровождения | Высокая | Зависит от тарифов |
Безопасность | Настраивается и контролируется самостоятельно | Есть готовые механизмы доступа, защиты и контроля |
Масштабирование | Нужно самостоятельно планировать и настраивать ресурсы | Автомасштабирование по мере роста нагрузки |
Эксплуатация и безопасность: что проверит ИБ-аудит
Безопасность должна быть неотъемлемой частью эксплуатации инфраструктуры ИИ-агентов. Для этого необходимо контролировать запросы к агенту и его ответы, обращения к внешним системам и все операции с данными.
Наблюдаемость: логирование запросов и действий агента, трассировка цепочек вызовов, метрики стоимости
Наблюдаемость помогает контролировать работу ИИ-агента, находить ошибки и оценивать эффективность использования ресурсов. Для этого используют логирование, трассировку и метрики.
Логи фиксируют запросы пользователей, ответы агента, вызовы инструментов и внешних систем, результаты операций и возникающие ошибки. По этим данным можно восстановить ход выполнения задачи и выяснить, на каком этапе возникла проблема.
Доступ к логам необходимо ограничивать: они могут содержать персональные данные, фрагменты запросов и другую конфиденциальную информацию.
Для более детального анализа используют трассировку цепочек вызовов. Она позволяет проследить весь путь выполнения задачи: какие шаги предпринял агент, к каким инструментам обратился и сколько времени занял каждый этап. Это помогает выявлять причины ошибок и задержек, проверять ответы агента на признаки галлюцинаций и находить возможности для оптимизации промптов и расходов на языковые модели (LLM).
Отдельно отслеживают метрики, которые показывают нагрузку на инфраструктуру и стоимость работы агента. К ним относятся:
количество обработанных запросов;
потребление токенов;
время выполнения задач;
количество вызовов внешних сервисов;
стоимость обработки запросов.
Эти показатели помогают оценивать производительность ИИ-агента, выявлять неэффективные операции и контролировать расходы на его эксплуатацию.
Guardrails, разграничение прав, подтверждение критичных действий человеком
Для защиты ИИ-агентов от prompt injection, обхода правил и утечки конфиденциальных данных используют Guardrails — набор механизмов безопасности, которые проверяют входные запросы, ответы модели и действия агента. Они помогают блокировать нежелательные запросы, маскировать конфиденциальные сведения плейсхолдерами и ограничивать вызовы инструментов. Например, Guardrails могут запретить агенту удалять записи или выполнять другие опасные операции.
Еще один уровень защиты — разграничение прав по принципу минимальных привилегий. Агент получает только те разрешения, которые необходимы для выполнения его задач. Это ограничивает возможный ущерб в случае ошибки или компрометации агента.
Для критичных операций используют подход human-in-the-loop: перед выполнением действия агент запрашивает подтверждение человека. Например, подтверждение может потребоваться перед удалением данных, изменением важных записей или отправкой внешнего сообщения. Так человек сохраняет контроль над действиями, которые могут привести к серьезным последствиям.
Как построить инфраструктуру ИИ-агентов на Cloud.ru
AI Factory — цифровая среда для создания, дообучения и запуска ИИ-агентов. Она позволяет обойтись без разрозненных инструментов и построения сложной инфраструктуры с нуля.
Evolution AI Agents: мультиагентные системы, поддержка MCP и A2A, готовые агенты в каталоге
Сервис Evolution AI Agents предназначен для создания и запуска автономных ИИ-агентов и мультиагентных систем с поддержкой MCP-серверов и протокола A2A . Есть готовые baseline-модели, возможны собственные реализации из Docker-образов.
Сервис соответствует требованиям 152-ФЗ и подходит для работы с персональными данными. Также используются технологии шифрования для защиты конфиденциальной информации.
Evolution Foundation Models (20+ моделей, единый API, Guardrails) и Evolution ML Inference для собственных моделей
Evolution Foundation Models предоставляет доступ к каталогу из 20+ моделей, включая GigaChat и open source модели, через единый OpenAI-совместимый API. С ними можно работать через единый OpenAI-совместимый API — инфраструктуру разворачивать не нужно. Для защиты данных предусмотрены Guardrails Filter, который выявляет и маскирует чувствительные сведения в запросах.
Если готовых решений недостаточно, можно использовать Evolution ML Inference. Это сервис для запуска ML-моделей из библиотеки Hugging Face на облачных мощностях с GPU. Вариант подходит, когда нужны собственная модель, отдельный экземпляр инференса или полный контроль над средой выполнения.
Evolution Managed RAG, аренда GPU, Evolution Managed Kubernetes и Object Storage как слои данных и вычислений
Evolution Managed RAG отвечает за работу агента с данными. Сервис создает базы знаний на основе корпоративных документов, которые могут храниться в облачном хранилище Evolution Object Storage. Для запуска и управления контейнерными приложениями может использоваться Evolution Managed Kubernetes как отдельный сервис Cloud.ru. Текущий состав Evolution AI Factory уточняйте в официальной документации.
В облаке Cloud.ru можно арендовать и серверы с GPU. Они подходят для ресурсоемких ИИ и ML-приложений. При необходимости ресурсы легко масштабировать под нагрузку.
Cloud.ru Agents Space: интерфейс для сотрудников без технических навыков, работающий на том же стеке
Cloud.ru Agents Space — пространство для работы с ИИ-агентами. Есть чат, где можно ставить задачи преднастроенным цифровым помощникам. Повторяющиеся действия запускаются по расписанию. Агенты будут стартовать сразу — без сложных настроек и интеграций.
Чек-лист: 12 требований к платформе перед выбором
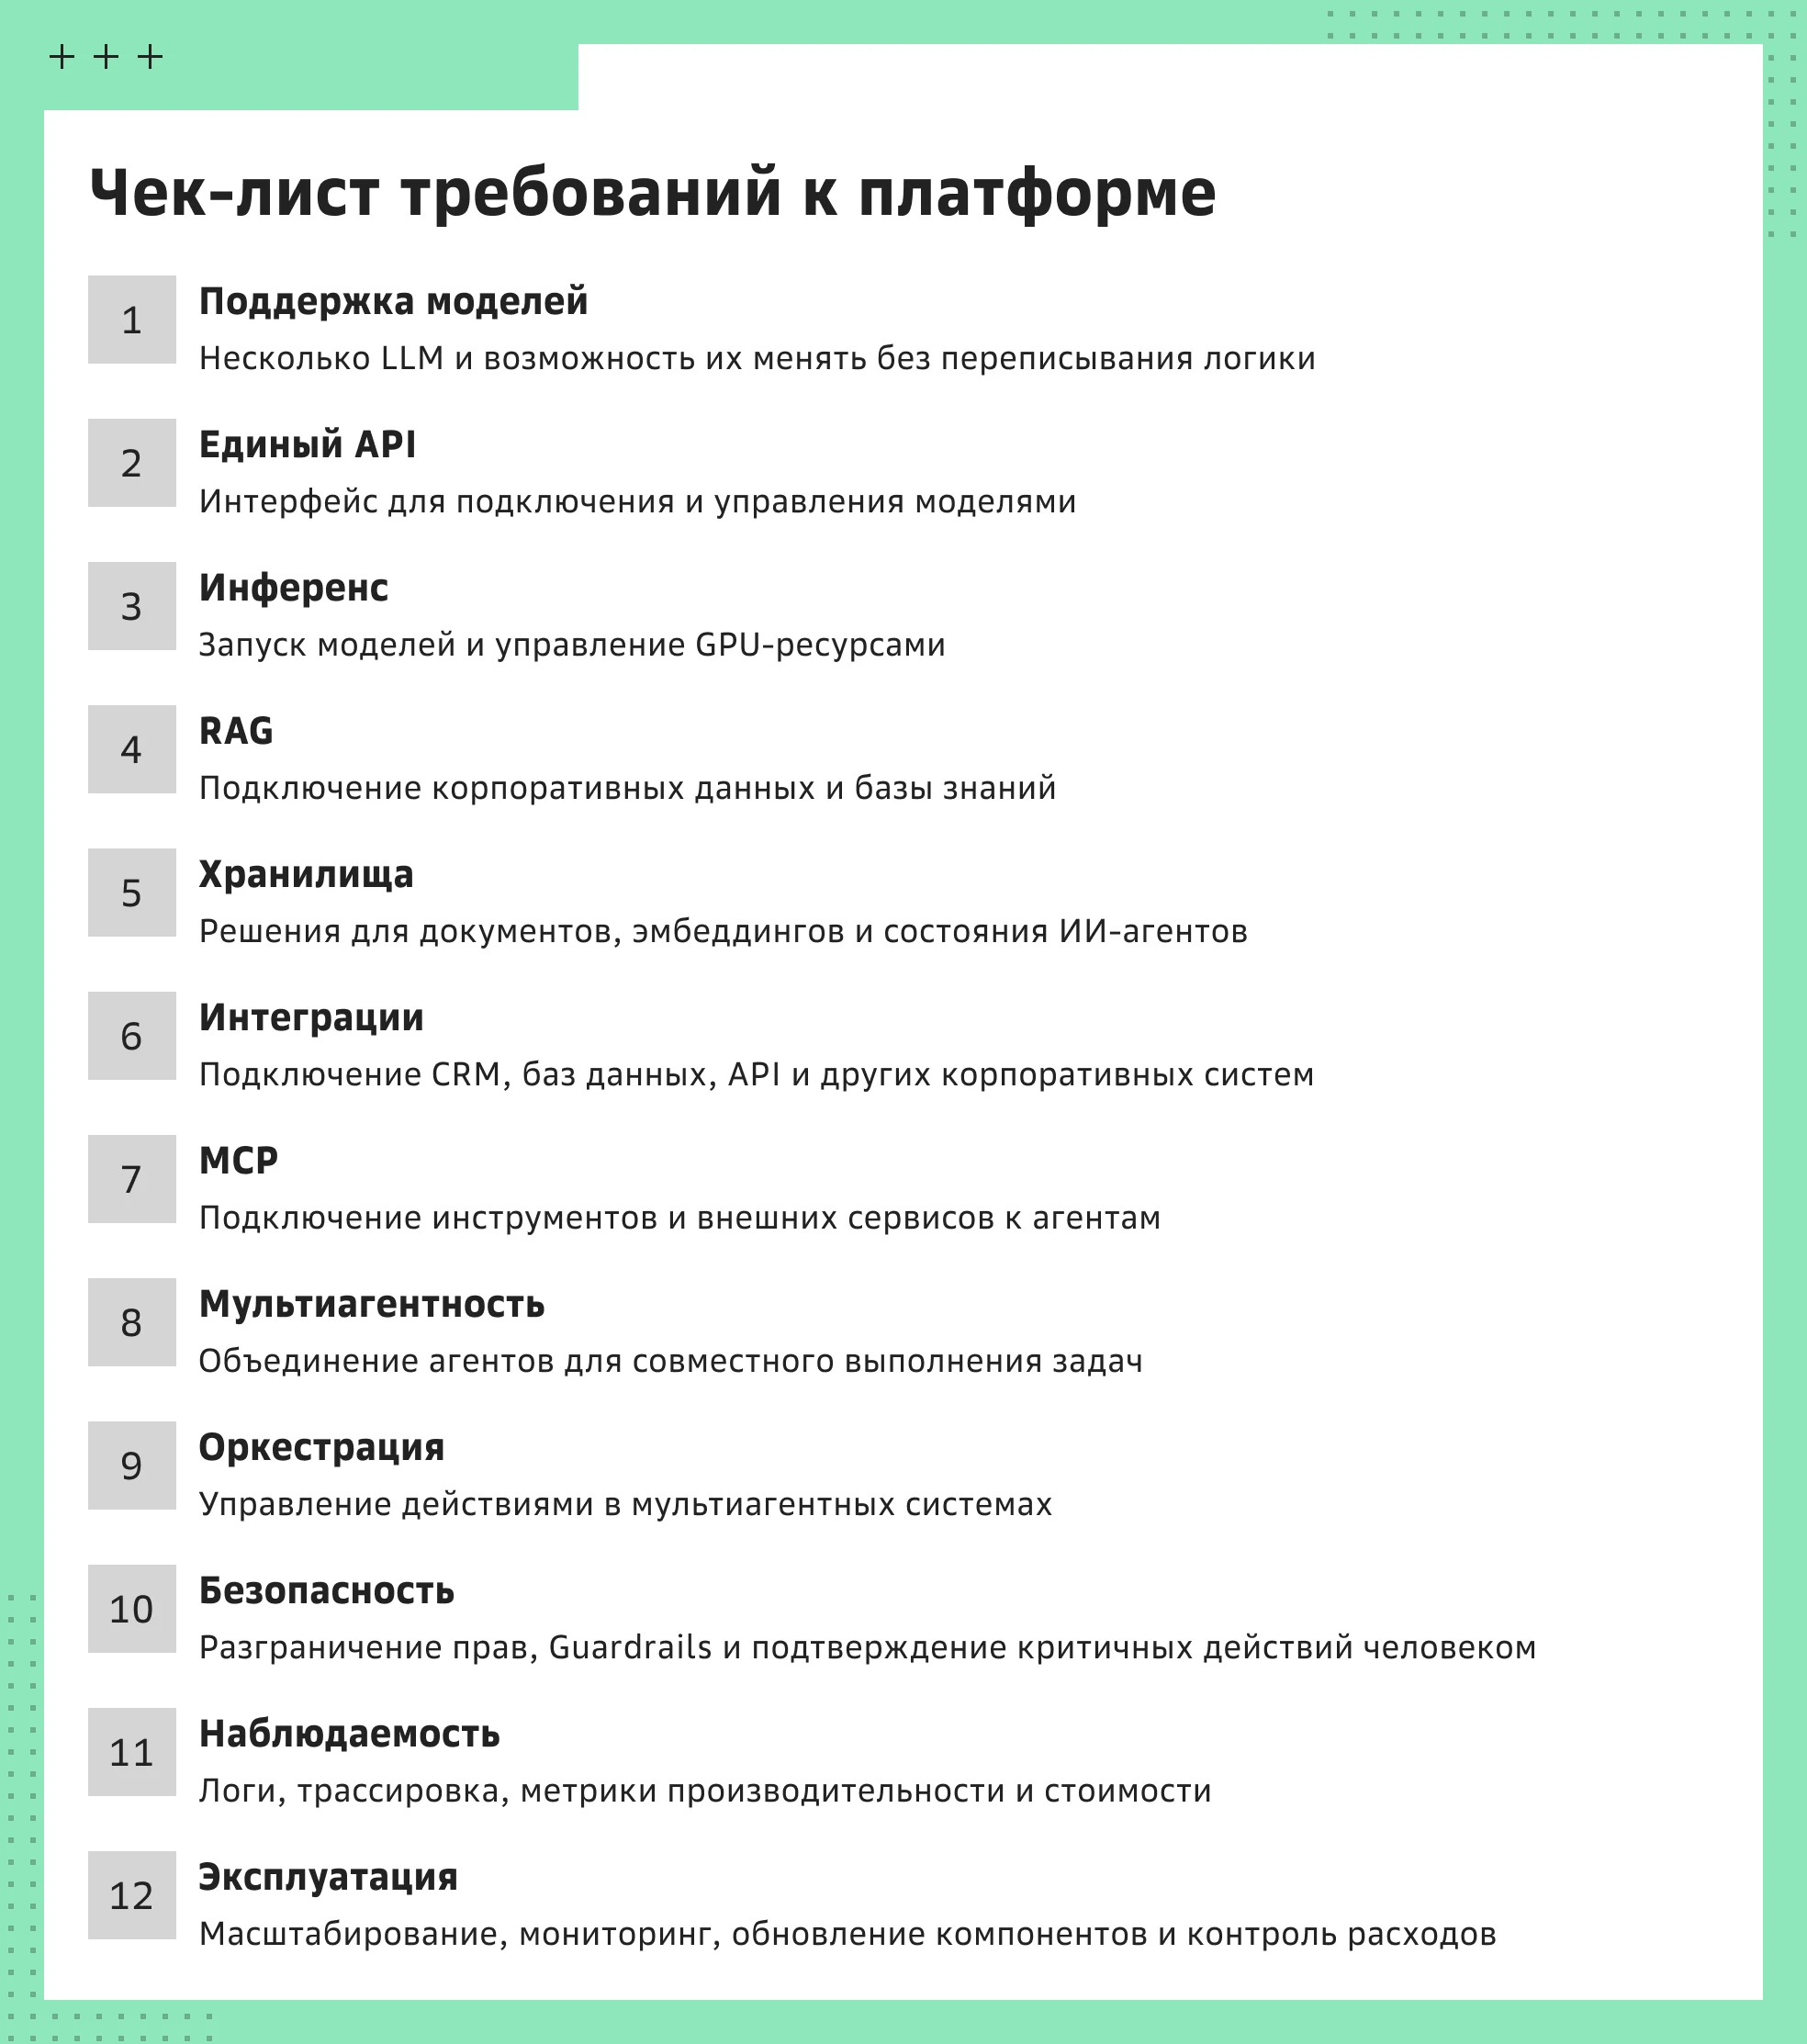
Стоит проверить не только набор функций среды, но и их применимость для эксплуатации. На что смотреть:
Поддержка моделей — несколько LLM и возможность их менять без переписывания логики.
Единый API — интерфейс для подключения и управления моделями.
Инференс — запуск моделей и управление GPU-ресурсами.
RAG — подключение корпоративных данных и базы знаний.
Хранилища — решения для документов, эмбеддингов и состояния ИИ-агентов.
Интеграции — подключение CRM, баз данных, API и других корпоративных систем.
MCP — подключение инструментов и внешних сервисов к агентам.
Мультиагентность — объединение агентов для совместного выполнения задач.
Оркестрация — управление действиями в мультиагентных системах.
Безопасность — разграничение прав, Guardrails и подтверждение чувствительных действий человеком.
Наблюдаемость — логи, трассировка, метрики производительности и стоимости.
Эксплуатация — масштабирование, мониторинг, обновление компонентов и контроль расходов.
 Требования к платформе для развертывания ИИ-агентов
Заключение
Платформа для ИИ-агентов — это не только вычислительные ресурсы. Для промышленной эксплуатации нужны также хранилища данных, инструменты интеграции и оркестрации, механизмы безопасности и мониторинга. Если хотя бы один из этих компонентов не готов к рабочей нагрузке, он может стать ограничением для всей системы.
При проектировании инфраструктуры важно учитывать требования конкретных задач, прогнозируемую нагрузку, безопасность данных и стоимость эксплуатации. Это поможет выбрать подходящую архитектуру, избежать узких мест и подготовить ИИ-агента к работе в промышленной среде.
FAQ
Что такое платформа для ИИ-агентов и чем она отличается от фреймворка?
Платформа для ИИ-агентов объединяет инфраструктуру, модели, хранилища данных, инструменты интеграции и средства мониторинга и управления агентами. Фреймворк — это набор библиотек и инструментов для разработки логики агента: определения его поведения, работы с инструментами и взаимодействия с моделями. Проще говоря, фреймворк помогает создать агента, а платформа — развернуть его и обеспечить работу в промышленной среде.
Сколько GPU нужно для запуска ИИ-агента на LLM?
Зависит от модели, ее размера, числа одновременных запросов и требований к скорости. Для небольших моделей может хватить одного GPU, для высокой нагрузки обычно требуется несколько.
Что такое MCP-сервер и зачем он агенту?
MCP-сервер подключает к внешним сервисам и инструментам. Через него агент может получать данные или выполнять разрешенные действия, например, работать с CRM или тикет-системой.
Что такое мультиагентная система?
Это система, в которой несколько агентов совместно выполняют одну задачу. Оркестратор распределяет работу между ними и управляет последовательностью действий.
Нужна ли векторная база данных для ИИ-агента?
Не всегда. Она нужна, если агент должен искать информацию по документам, например, при использовании RAG.
Можно ли развернуть ИИ-агентов без собственного ML-отдела?
Да. Управляемая платформа берет на себя часть задач по запуску моделей, хранению данных и эксплуатации.
Сколько стоит инфраструктура для ИИ-агентов?
Конкретной стоимости нет. Расходы зависят от выбранных моделей, GPU, объема данных, количества запросов, хранилищ и других компонентов платформы.