MLOps: как разрабатывать, запускать и поддерживать ML-модели
Обучить ML-модель с хорошими метриками — только часть задачи. После запуска в продакшене ее качество может снизиться: данные меняются, распределения смещаются, а модель начинает чаще ошибаться. Без мониторинга, версионирования данных и моделей сложно вовремя заметить проблему, установить ее причину и вернуться к предыдущей стабильной версии.
Решить эти задачи помогают практики MLOps (Machine Learning Operations). Они объединяют процессы разработки, развертывания и сопровождения ML-моделей, помогают автоматизировать переход от эксперимента к рабочему сервису и поддерживать качество моделей после запуска. В зрелых MLOps-процессах этапы от подготовки данных до мониторинга объединены в автоматизированный конвейер. Модели переобучают по расписанию или при обнаружении изменений в данных и качестве предсказаний.
Разберем, что такое MLOps, как устроены такие процессы, какие существуют уровни зрелости и какие инструменты используют для работы с ML-моделями в продакшене.


Что такое MLOps простыми словами
MLOps (Machine Learning Operations) — это подход к разработке и эксплуатации систем машинного обучения, который объединяет практики DevOps и задачи работы с ML-моделями.
Для работы ML-системы недостаточно обучить модель. Нужно также подготовить данные, настроить инфраструктуру, организовать развертывание и следить за качеством прогнозов. Все эти процессы требуют согласованной работы и регулярного контроля.
MLOps помогает объединить их в единый процесс: автоматизировать этапы работы с моделью, управлять версиями данных и моделей, отслеживать изменения и поддерживать стабильную работу в продакшене.
Зачем нужен MLOps: почему модели не доходят до продакшена
Разработку ML-моделей часто начинают в Jupyter Notebook: там удобно проверять гипотезы, экспериментировать с данными и подбирать параметры. Но успешный эксперимент еще не гарантирует, что модель будет стабильно работать в продакшене.
При переносе модели в рабочую среду могут обнаружиться проблемы: часть операций выполнялась вручную, зависимости не были зафиксированы, исходный датасет изменился. В результате сложно воспроизвести эксперимент, повторить обучение или установить причину ошибок.
MLOps помогает решить эти задачи: сохранять версии кода, данных и моделей, автоматизировать повторяемые операции и контролировать качество на всех этапах работы. Благодаря этому переход от эксперимента к рабочему сервису становится более предсказуемым, а риск ошибок при эксплуатации снижается.
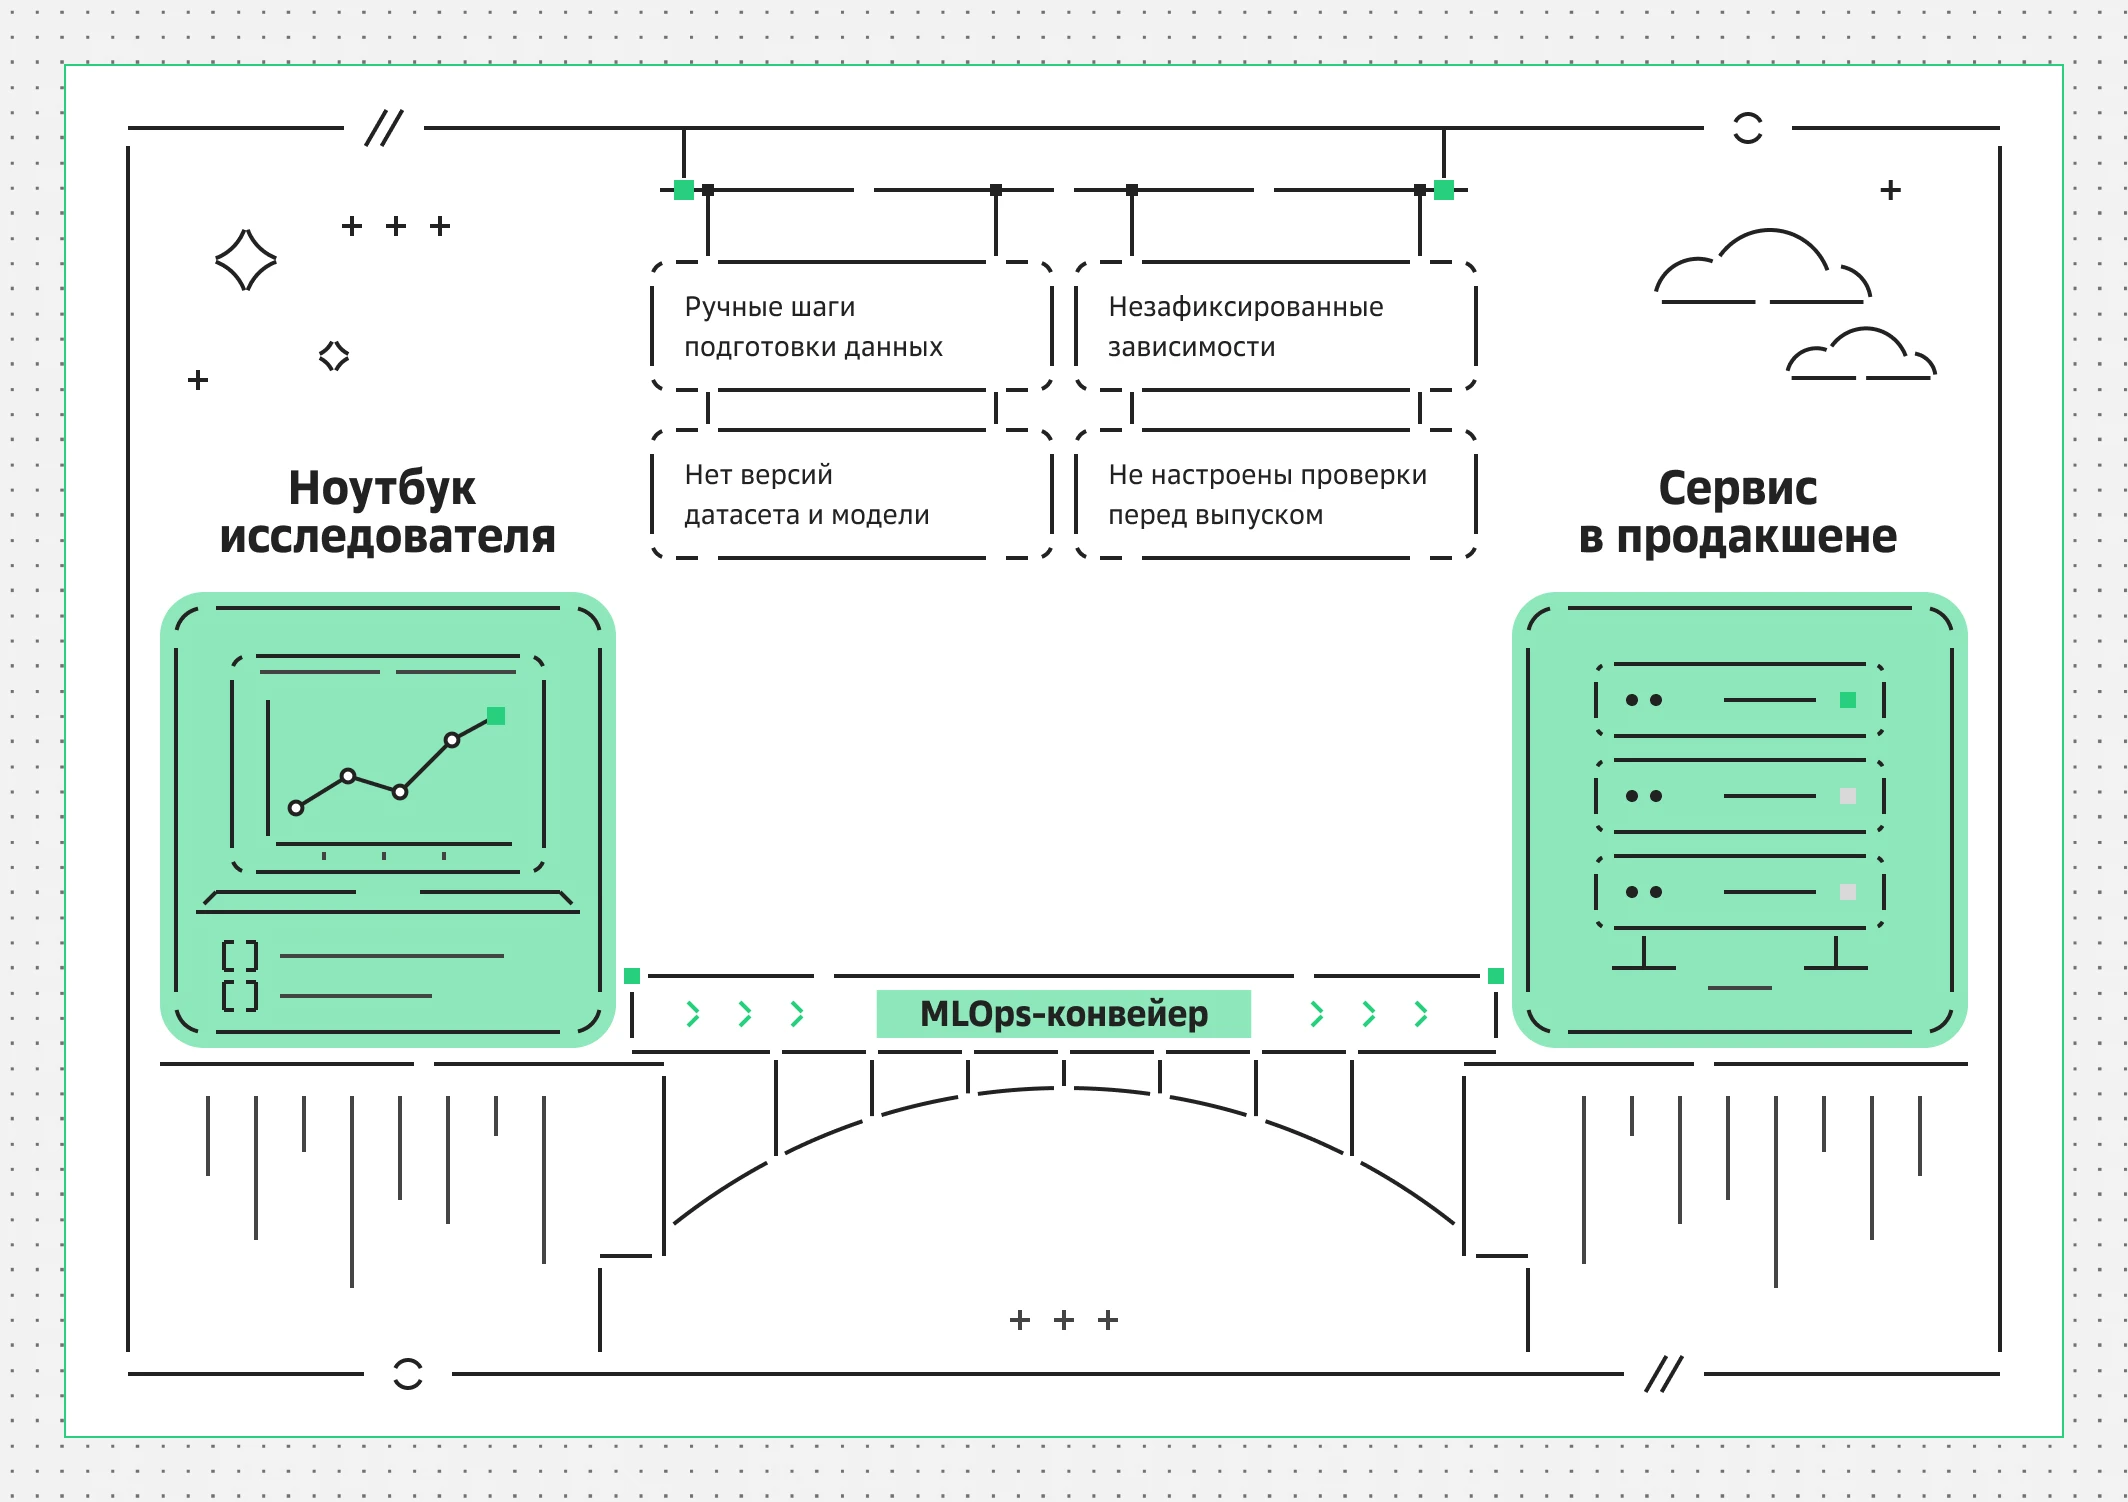 Схема показывает типичные причины задержек при переходе от эксперимента к рабочему сервису
MLOps и DevOps: что общего и в чем разница
DevOps и MLOps используют общие практики: автоматизированную сборку и развертывание, управление конфигурациями и CI/CD (Continuous Integration и Continuous Delivery, непрерывная интеграция и доставка). В ML-системах дополнительно следят за данными, поскольку качество прогнозов может снизиться даже без изменений в коде.
Критерий | DevOps | MLOps |
Что версионируем | Код, конфигурацию, инфраструктуру | Код, данные, признаки, параметры и модели |
Что тестируем | Функции и интеграции | Функции и интеграции, качество данных и метрики модели |
Повод для обновления | Изменения кода или конфигурации | Изменения кода или данных, расписание, результаты мониторинга |
Что мониторим | Доступность, ошибки, латентность | Доступность, ошибки, латентность, входные данные и качество прогнозов |
Основные роли | Разработчики, DevOps-инженеры и инженеры эксплуатации | Дата-сайентисты, дата-инженеры, ML- и MLOps-инженеры |
Жизненный цикл ML-модели: этапы MLOps
Работа с ML-моделью организована как повторяемый цикл. Результаты мониторинга помогают определить, когда нужно проверить качество, обновить данные или переобучить модель. Далее рассмотрим задачи и инструменты каждого этапа.
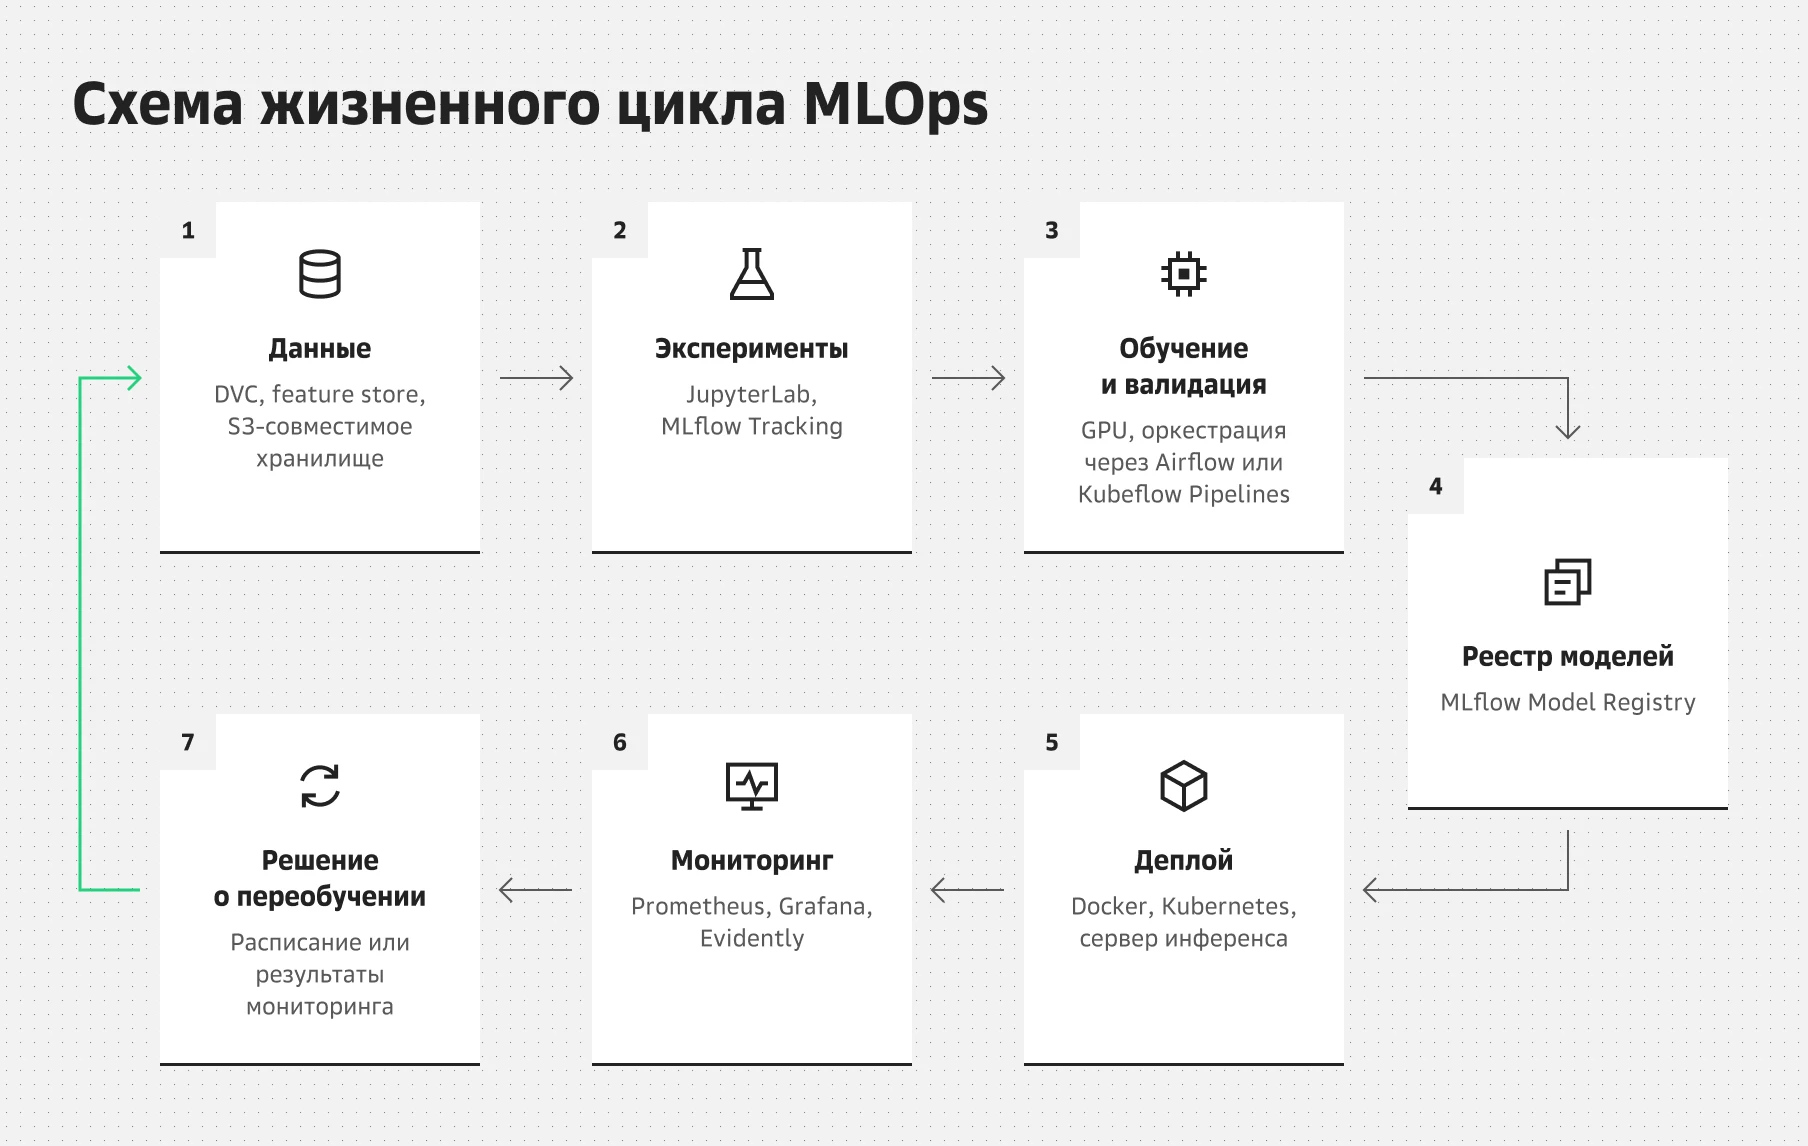 Инструменты приведены для примера. Облачные сервисы могут объединять несколько этапов цикла.
Данные: сбор, подготовка, версионирование и feature store
Данные собирают из рабочих систем, очищают и проверяют на пропуски. Подготовка и версионирование данных помогают воспроизводить эксперименты, а DVC (Data Version Control) фиксирует версии датасетов. При деградации модели история изменений позволяет установить, на каких данных ее обучали. Сами файлы можно хранить в объектном хранилище S3.
Данные также нужно одинаково обрабатывать на этапах обучения и инференса — расчета прогнозов в продакшене. Если признаки вычисляются по разным правилам, их значения могут расходиться. Это приводит к снижению качества прогнозов. Feature store (хранилище признаков) помогает централизованно задавать определения признаков и использовать единые правила их расчета как при обучении модели, так и при инференсе.
Эксперименты: трекинг параметров, метрик и артефактов
При разработке ML-модели дата-сайентист проводит эксперименты: меняет гиперпараметры, пробует разные наборы признаков и сравнивает результаты обучения. Чтобы не потерять удачные настройки и понимать, за счет чего изменилось качество модели, важно фиксировать каждый запуск.
Для этого используют MLflow. Инструмент сохраняет параметры эксперимента, метрики качества, артефакты (например, графики и файлы), а при запуске из Git-репозитория — хеш коммита. Это позволяет сравнивать эксперименты, воспроизводить успешные запуски и выбирать модель для дальнейшего использования.
Обучение и валидация: воспроизводимые ML-пайплайны
Когда подходящие параметры и настройки модели определены, процесс обучения оформляют в ML-пайплайн (ML pipeline). Он объединяет последовательные этапы: подготовку данных, обучение и валидацию модели.
За запуск и порядок выполнения этапов отвечает оркестратор, например Apache Airflow или Kubeflow Pipelines. Чтобы результаты можно было воспроизвести в разных средах, этапы часто запускают в контейнерах с зафиксированными зависимостями.
После обучения модель проверяют на отложенной выборке, которая не использовалась при обучении. Если метрики качества соответствуют заданным порогам, модель можно зарегистрировать в реестре. В противном случае ее не передают на следующий этап.
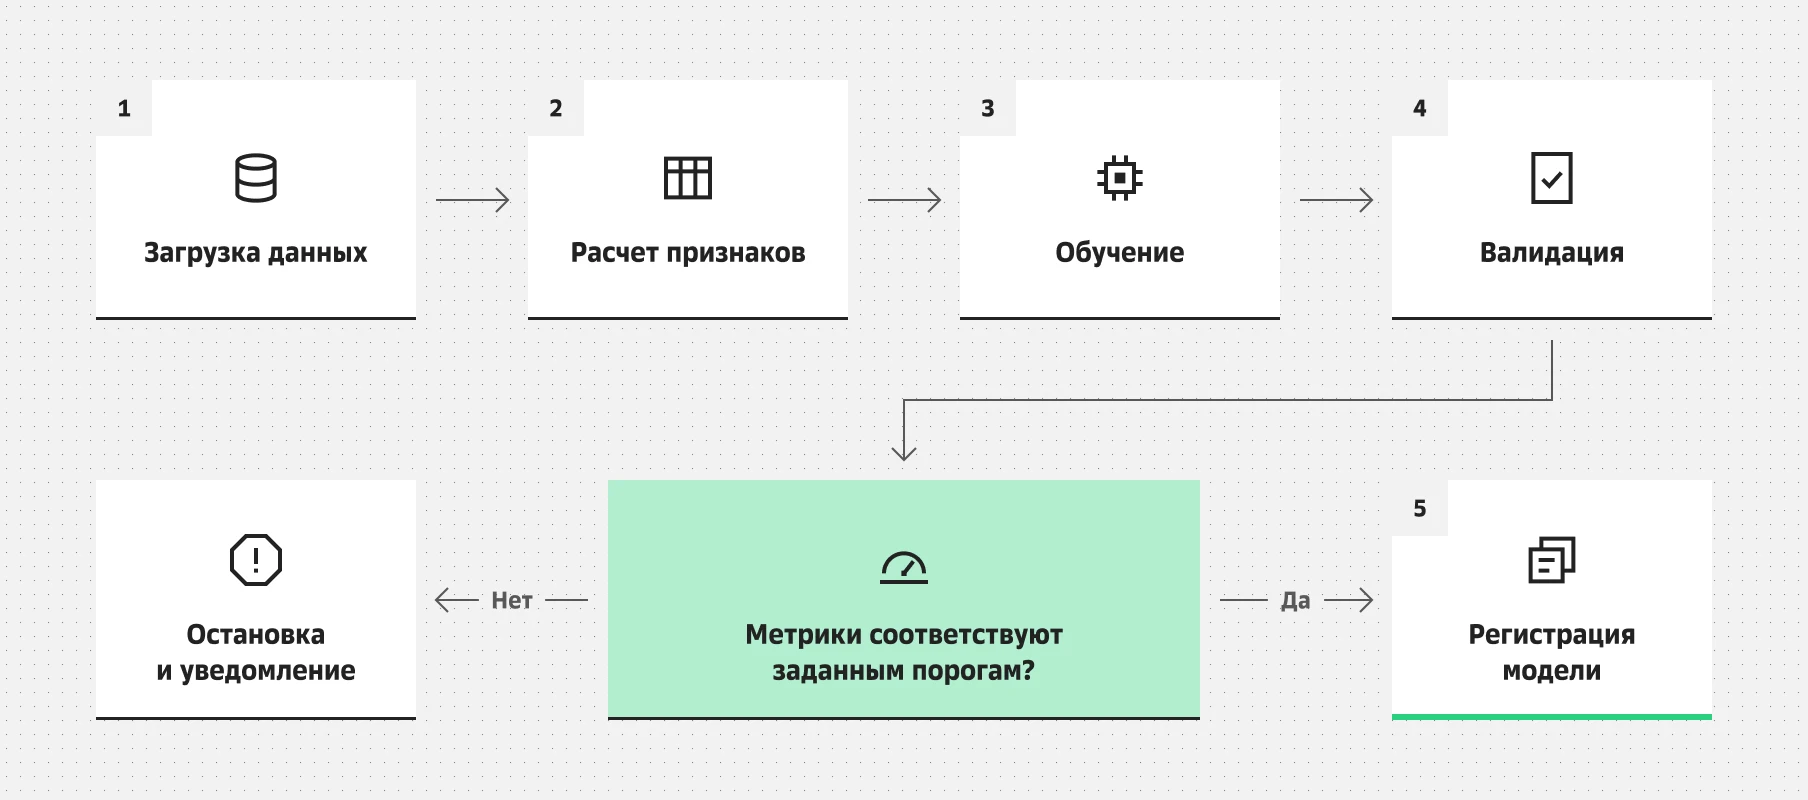 Регистрация модели выполняется только после успешной проверки качества
Model registry: хранение и версионирование моделей
Model registry (реестр моделей) — это централизованное хранилище зарегистрированных ML-моделей и их версий. Для каждой версии сохраняют ссылку на файлы модели и сведения о ее обучении. Если версия связана с запуском эксперимента, в реестре также можно посмотреть его метрики и информацию об использованных данных.
В MLflow версиям моделей можно назначать псевдонимы (aliases), например champion для текущей рабочей версии и challenger для тестируемой. Это упрощает управление развертыванием: чтобы вернуться к предыдущей версии, достаточно переназначить псевдоним champion. Если сервис загружает модель по этому псевдониму, менять код не нужно. Однако потребуется повторно загрузить модель или обновить развертывание, чтобы сервис начал использовать новую версию.
Деплой и инференс: как модель становится сервисом
При развертывании ML-моделей часто используют контейнеризацию: код сервиса и зависимости упаковывают в образ, а файлы модели включают в него или загружают отдельно. Так проще сохранить одинаковое программное окружение при тестировании и в продакшене. После деплоя сервис выполняет инференс онлайн через API или пакетно, например по расписанию.
Перед полной выкаткой новую версию проверяют на реальном трафике. Для этого используют несколько способов:
При A/B-тестировании моделей запросы распределяют между вариантами и сравнивают бизнес-метрики.
При canary-релизе новой версии сначала передают небольшую долю запросов, увеличивая ее после проверки.
В теневом режиме (shadow deployment) новая версия обрабатывает копию трафика, но пользователи получают ответы только от действующей.
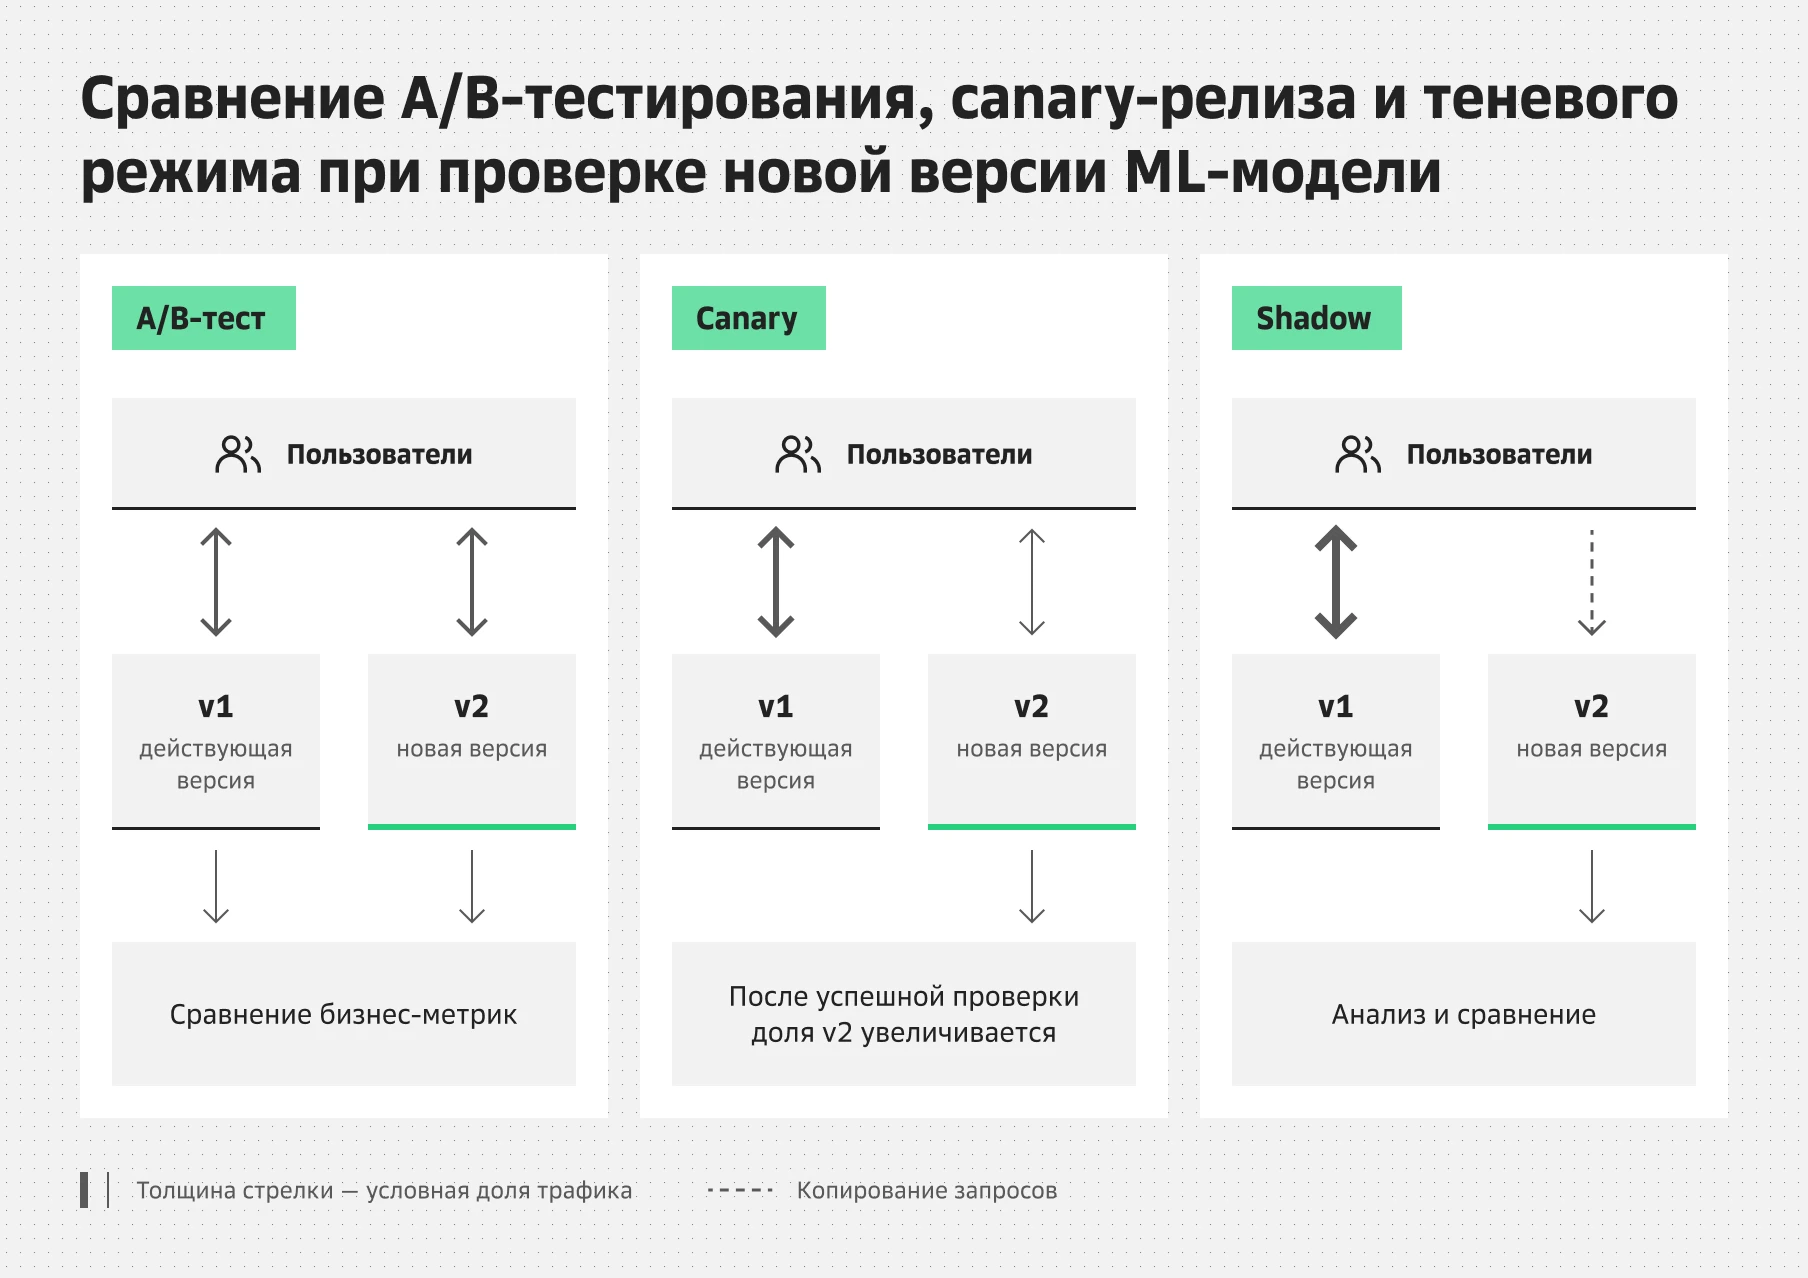 Доли трафика условные. В теневом режиме пользователи получают ответы только от действующей версии.
Мониторинг: дрифт данных, деградация качества и переобучение
После запуска модели в продакшене важно следить не только за ее технической работой, но и за качеством прогнозов. Для этого контролируют время ответа (латентность), количество ошибок и загрузку ресурсов, например GPU. Эти показатели можно отслеживать на дашбордах Grafana.
Отдельно анализируют входные данные и результаты прогнозирования. Один из важных показателей — дрифт данных (data drift), то есть изменение распределения входных признаков по сравнению с обучающей выборкой. При дрифте концепции (concept drift) меняется зависимость между признаками и целевой переменной, которую модель должна предсказывать.
Для обнаружения таких изменений используют, например, Evidently. Библиотека помогает отслеживать дрифт входных данных и прогнозов. Если фактические результаты становятся доступны, можно также оценивать изменения целевой переменной и обнаруживать концептуальный дрифт. Это особенно важно, когда правильность прогнозов нельзя проверить сразу после их получения.
Обнаруженный дрифт — повод проверить качество модели, но не всегда признак того, что она стала хуже работать. Если качество действительно снизилось, запускают переобучение (retraining). Его можно проводить вручную или автоматически по заданным правилам.
Уровни зрелости MLOps
Компании внедряют MLOps постепенно. Одна из распространенных моделей зрелости выделяет три уровня. Они различаются степенью автоматизации ML-процессов.
Уровень 0: ручной процесс
Модель обучают в ноутбуке, а затем передают инженерам для развертывания. Обновления выходят редко, иногда всего несколько раз в год. Регулярный мониторинг качества обычно отсутствует, поэтому снижение точности могут заметить не сразу.
Уровень 1: автоматизированный ML-пайплайн
На первом уровне автоматизируют подготовку данных, обучение, проверку качества и выпуск новых версий. Пайплайн запускается по расписанию, при появлении новых данных или после проверки сигналов мониторинга. Такой подход называют непрерывным обучением (continuous training). Изменения самого пайплайна обычно внедряют вручную.
Уровень 2: CI/CD для ML
На втором уровне к автоматизированному обучению добавляют CI/CD для ML. Изменения в коде пайплайна проходят автоматические тесты, сборку и развертывание. Такой подход полезен, когда команда часто обновляет алгоритмы, признаки или поддерживает много моделей.
Уровень | Как обучают и развертывают | Когда обновляют | Типичная команда | Что улучшать дальше | |
Соответствие редакции VMware Horizon | 0. Ручной процесс | Основные этапы выполняют вручную | Редко, по мере необходимости | Дата-сайентисты и разработчики | Версионирование данных, реестр моделей и автоматизация пайплайна |
1. Автоматизированный пайплайн | Автоматически обучают, проверяют и выпускают новые версии | По расписанию, при поступлении новых данных или по сигналам мониторинга | Дата-сайентисты, дата- и ML-инженеры | Автоматизировать тестирование и развертывание самого пайплайна | |
2. CI/CD для ML | Автоматизированы ML-пайплайн и его CI/CD | Переобучение — по заданным условиям, обновление пайплайна — при изменении кода | ML- и MLOps-инженеры, продуктовые команды | Единые шаблоны и стандарты для команд |
Инструменты MLOps
Для каждого этапа MLOps используют отдельные инструменты или комплексные платформы. Одни решения помогают управлять данными и отслеживать эксперименты, другие — автоматизировать обучение, хранить версии моделей и контролировать их работу в продакшене.
Некоторые платформы объединяют несколько таких функций в единой среде. В других случаях MLOps-процесс собирают из отдельных инструментов, выбирая их под задачи проекта и существующую инфраструктуру.
MLflow: трекинг экспериментов и реестр моделей
MLflow — открытая платформа для управления жизненным циклом ML-моделей, которую компания Databricks представила в 2018 году. Она объединяет несколько инструментов MLOps: трекинг экспериментов, реестр моделей и упаковку моделей в едином формате.
Платформа совместима с разными библиотеками машинного обучения, а артефакты экспериментов и модели можно хранить во внешних хранилищах, в том числе S3-совместимых.
В версиях MLflow 3.x появились возможности для работы с LLM-приложениями: трассировка вызовов и оценка ответов с помощью LLM-судей (LLM-as-a-judge).
DVC и feature store: версионирование данных и признаков
DVC (Data Version Control) — инструмент для версионирования данных и управления ML-пайплайнами. Он помогает сохранять историю изменений датасетов и связывать конкретные версии данных с кодом, чтобы можно было воспроизвести эксперимент или повторить обучение модели.
DVC интегрируется с Git: в репозитории хранятся небольшие файлы-указатели с расширением .dvc, в которых записаны MD5-хеши и метаданные датасетов. Сами данные размещаются отдельно, например в S3-совместимом хранилище. В ноябре 2025 года lakeFS приобрела проект DVC у Iterative.ai и с тех пор отвечает за его развитие и поддержку.
Для централизованного управления признаками используют Feast — открытый feature store. Он предоставляет единый интерфейс для получения признаков на разных этапах работы с моделью: исторические значения из offline store используют для формирования обучающих выборок, а актуальные значения из online store — для инференса с низкой задержкой.
Airflow и Kubeflow: оркестрация пайплайнов
Оркестраторы управляют последовательностью задач в ML-пайплайне: запускают их в нужном порядке, отслеживают выполнение и при сбоях могут повторно запускать задачи.
Apache Airflow — универсальный инструмент для оркестрации рабочих процессов. Сценарии в нем описывают на Python в виде DAG (направленных ациклических графов), которые определяют последовательность задач и зависимости между ними. В Cloud.ru сервис доступен как Evolution Managed Airflow.
Kubeflow ориентирован на задачи машинного обучения в Kubernetes. Компонент Kubeflow Pipelines позволяет создавать и запускать ML-пайплайны, а Kubeflow Trainer — организовывать обучение моделей, в том числе распределенное обучение с использованием GPU.
Инструменты для мониторинга моделей
Для мониторинга ML-систем используют инструменты, которые помогают контролировать как технические показатели сервиса, так и качество работы модели.
Prometheus собирает технические метрики, например время ответа, количество ошибок и загрузку GPU. Grafana позволяет отображать эти показатели на дашбордах и настраивать алерты. Например, если время ответа превышает заданный порог, система отправляет уведомление.
Для контроля качества прогнозов и обнаружения изменений во входных данных используют Evidently. Инструмент помогает отслеживать дрифт данных и оценивать, как меняются распределения признаков по сравнению с обучающей выборкой. Если доступны фактические результаты, с его помощью также можно анализировать качество прогнозов.
LLMOps: чем эксплуатация LLM отличается от классического MLOps
LLMOps применяет практики MLOps к большим языковым моделям (LLM). В прикладных проектах обычно используют готовые LLM: настраивают промпты, дообучают модели под конкретные задачи или подключают к базе знаний через RAG (Retrieval-Augmented Generation, генерацию с поиском по документам). Поскольку изменения промптов влияют на ответы, их версии тоже сохраняют.
У генеративных задач бывает несколько подходящих ответов, поэтому качество проверяют на наборах тестовых вопросов по заданным критериям. Для части проверок используют модель-судью (LLM-as-a-judge). Дополнительно отслеживают расход и стоимость токенов, а также выявленные галлюцинации. Guardrails — проверки входящих запросов и ответов — помогают блокировать нежелательный контент и снижать риск передачи конфиденциальных данных.
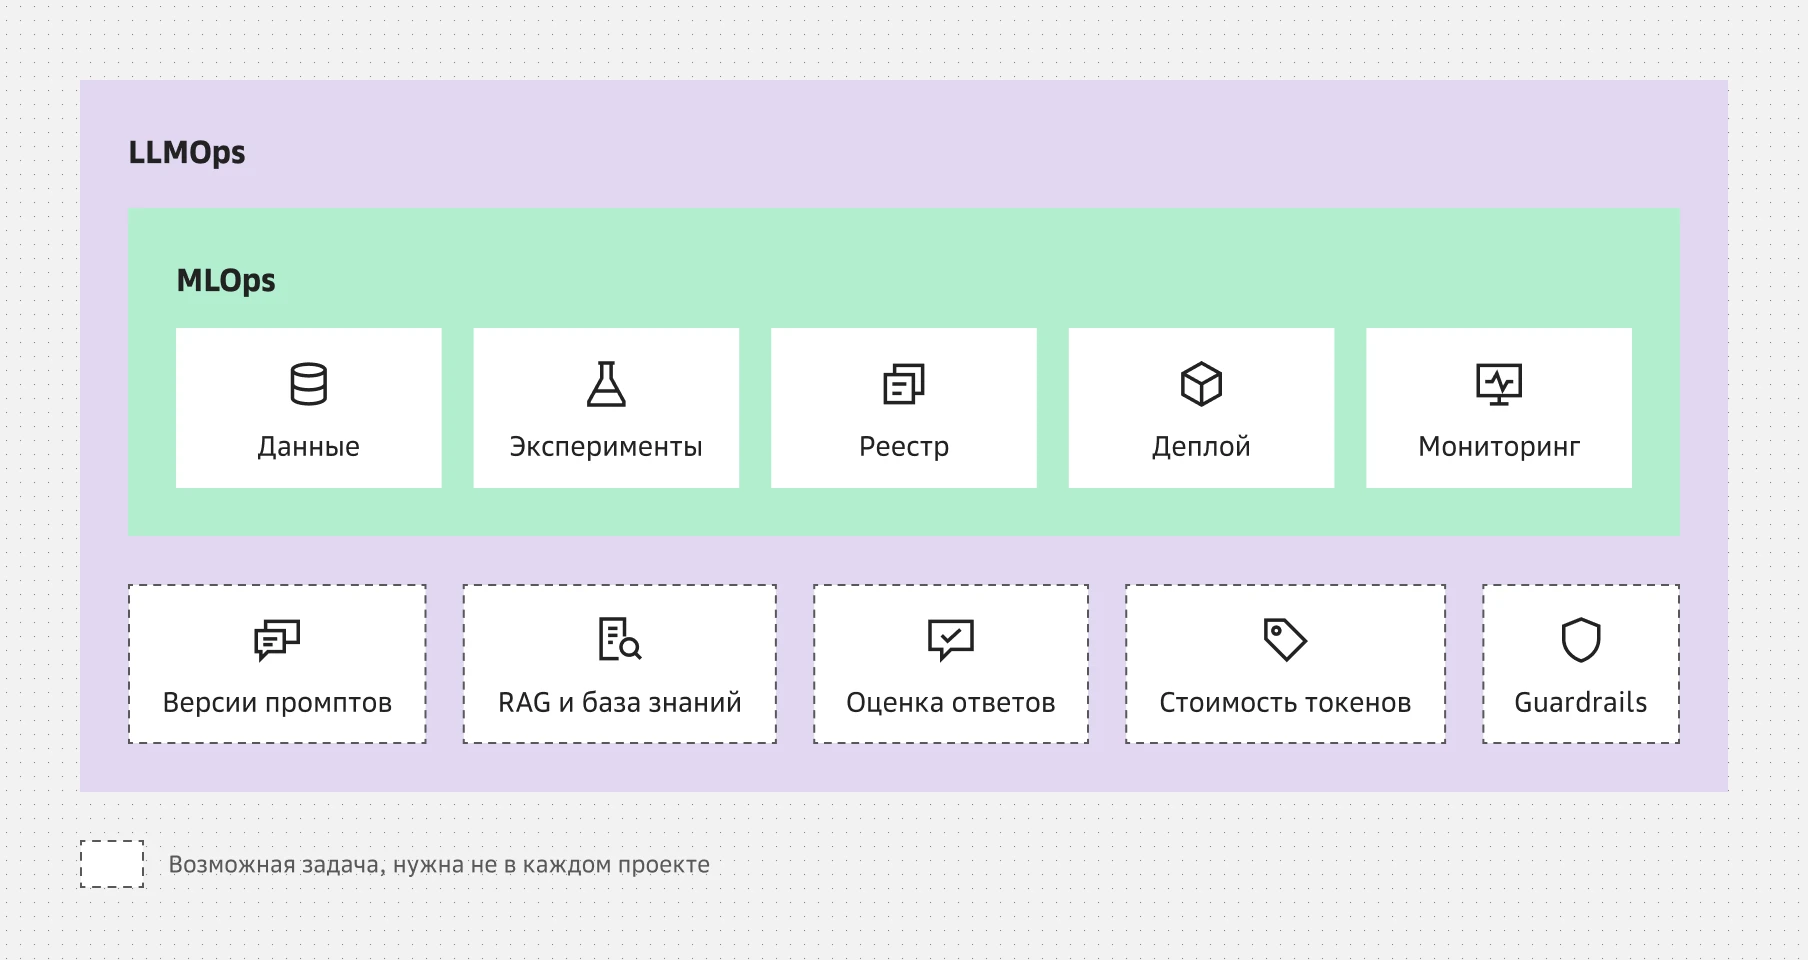 LLMOps опирается на базовые практики MLOps и добавляет задачи, характерные для языковых моделей
MLOps-инженер отвечает за инфраструктуру для обучения и эксплуатации ML-моделей. Он автоматизирует пайплайны, настраивает реестр и мониторинг. В профессию приходят как DevOps-инженеры, освоившие основы машинного обучения, так и ML-инженеры, которым интересна эксплуатация сервисов.
Требования зависят от задач компании, но основные навыки можно разделить на четыре группы:
Для разработки пайплайнов пригодятся Python, Git и навыки тестирования кода.
Для развертывания и обновления сервисов полезны Docker, Kubernetes и CI/CD.
Для работы с дата-сайентистами важно понимать этапы обучения и метрики качества моделей.
Из специализированных инструментов стоит знать MLflow, Airflow, DVC, Prometheus и Grafana.
MLOps в облаке Cloud.ru
Для ресурсоемкого обучения ML-моделей могут потребоваться мощные GPU и отдельная команда для обслуживания инфраструктуры. Облачные сервисы позволяют выделять вычислительные ресурсы под конкретные задачи, а поддержку оборудования берет на себя провайдер. В Cloud.ru инструменты для разработки, обучения и развертывания моделей представлены в решении «Разработка и эксплуатация ML-моделей». Для работы с генеративным ИИ доступна среда AI Factory.
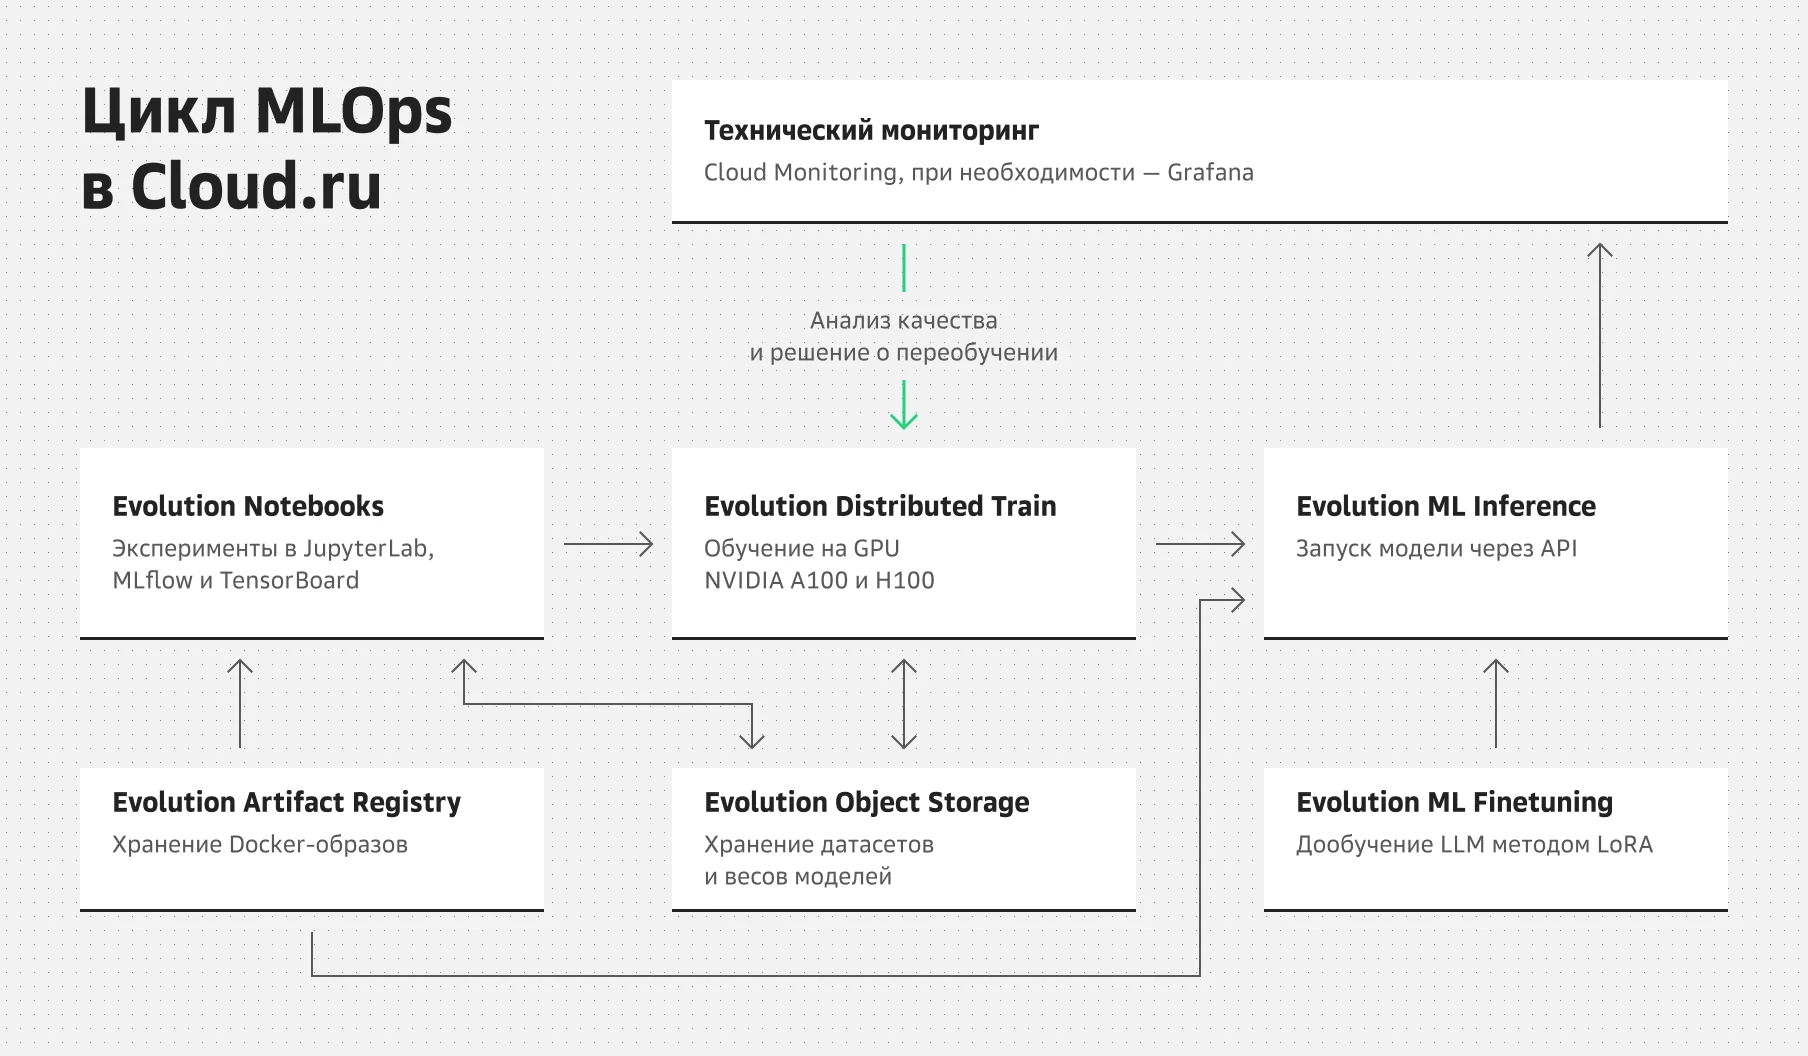
Evolution Notebooks: разработка и эксперименты в готовом окружении
Evolution Notebooks предоставляет готовую среду JupyterLab для ML-экспериментов на облачных CPU и GPU. Можно использовать базовый Docker-образ или загрузить собственный из Evolution Artifact Registry. MLflow помогает сохранять и сравнивать результаты экспериментов, а TensorBoard — отслеживать процесс обучения. Датасеты можно хранить в объектном хранилище Evolution Object Storage.
Evolution Distributed Train: обучение на GPU A100 и H100
Для ресурсоемких задач в Cloud.ru доступен сервис Evolution Distributed Train с GPU A100 на 40 и 80 ГБ и H100 на 80 ГБ. На одном узле можно использовать до восьми ускорителей.
Возможность распределенного обучения на нескольких узлах зависит от сетевой инфраструктуры региона. В регионах без высокоскоростной сети между серверами, например Cloud.Region.HP1 • SR003 и Cloud.Region.HP • SR006, задачи ограничены одним узлом. Для обучения на нескольких узлах доступны конфигурации с сетью InfiniBand и поддержкой RDMA, которая ускоряет обмен данными между серверами. Такие конфигурации представлены в специализированных регионах на базе суперкомпьютеров Christofari, например Christofari.A100.part2 • SR004.
Задачи обучения (Jobs) можно запускать через API или SDK без использования Jupyter Server. Статус выполнения и логи доступны в интерфейсе сервиса, а метрики обучения можно отслеживать с помощью TensorBoard.
Для работы с MLflow потребуется Jupyter Server. Кроме того, в Distributed Train доступен собственный инструмент трекинга экспериментов, совместимый с SDK wandb (Weights & Biases). Сейчас эта возможность предоставляется в режиме предварительного доступа (Preview).
Evolution ML Inference и ML Finetuning: деплой и дообучение моделей
Evolution ML Inference позволяет запускать модели из Hugging Face и собственных Docker-образов. Сервис поддерживает среды исполнения vLLM, TGI, Ollama и другие. Технология Shared GPU позволяет нескольким моделям использовать один ускоритель, а автоматическое масштабирование выделяет дополнительные ресурсы при росте нагрузки. Например, компания Agentic Lab использует Evolution ML Inference для работы языковых моделей ИИ-помощника «Агата». В этом проекте подключение дополнительных GPU при росте нагрузки занимает 5–10 минут.
Evolution ML Finetuning предназначен для дообучения текстовых LLM из Hugging Face методом LoRA (Low-Rank Adaptation). При LoRA исходные веса модели остаются неизменными, а обучается небольшой набор дополнительных параметров. Это снижает требования к вычислительным ресурсам. При объеме датасета около 1 МБ дообучение модели с 32 млрд параметров может занять 15–30 минут. Готовую модель можно развернуть в Evolution ML Inference.
Заключение
MLOps помогает организовать полный жизненный цикл ML-модели: от подготовки данных и экспериментов до развертывания и мониторинга в продакшене. Версионирование данных и моделей, автоматизация обучения и контроль качества делают результаты воспроизводимыми, упрощают обновление моделей и помогают быстрее выявлять проблемы в их работе.
Внедрять MLOps можно постепенно. На первых этапах достаточно наладить версионирование данных, трекинг экспериментов и мониторинг моделей. По мере роста числа ML-моделей и усложнения инфраструктуры можно автоматизировать обучение, тестирование и развертывание. Это сокращает объем ручной работы и помогает поддерживать стабильное качество моделей в продакшене.
FAQ
Чем MLOps отличается от DevOps?
DevOps помогает автоматизировать разработку, тестирование и развертывание ПО. MLOps дополнительно предусматривает версионирование данных и моделей, а также мониторинг качества прогнозов. Модель может начать чаще ошибаться даже без изменений в коде.
С чего начать внедрение MLOps в компании?
Выберите одну модель с понятными метриками качества. Зафиксируйте версии данных и кода, настройте трекинг экспериментов и мониторинг. Затем постепенно автоматизируйте обучение, проверки и развертывание.
Какие инструменты нужны для MLOps на старте?
Для небольшого проекта подойдут Git и DVC для версионирования, MLflow для экспериментов и реестра моделей, Docker для упаковки. Метрики можно собирать через Prometheus и отображать в Grafana. Оркестратор вроде Airflow добавляют по мере необходимости.
Что такое дрифт данных и как его отслеживать?
Дрифт данных — это изменение распределения входных признаков относительно обучающей выборки. Его выявляют с помощью статистических тестов, например в Evidently. При значительных отклонениях проверяют данные и качество прогнозов, после чего решают, требуется ли переобучение.
Нужен ли Kubernetes для MLOps?
На старте можно обойтись без него. Kubernetes полезен для развертывания контейнерных сервисов, распределения нагрузки и масштабирования. Evolution Managed Kubernetes упрощает управление кластерами и сокращает объем работ по их обслуживанию.
Чем занимается MLOps-инженер?
MLOps-инженер создает инфраструктуру для обучения и эксплуатации моделей. Он настраивает ML-пайплайны, CI/CD, реестр моделей, развертывание и мониторинг.
Что такое LLMOps?
LLMOps применяет практики MLOps к большим языковым моделям. Дополнительно учитываются версии промптов, работа с базами знаний через RAG, оценка ответов, стоимость токенов и защитные механизмы (guardrails).