Apache Airflow: что это, как работает DAG и зачем он нужен команде
Когда обработка данных состоит из нескольких последовательных задач, важно не только запустить каждую из них по расписанию, но и контролировать порядок выполнения, отслеживать ошибки и повторять неудачные запуски. Обычного cron — стандартного планировщика задач в Unix-подобных системах — для этого недостаточно: он запускает скрипты в заданное время, но не управляет зависимостями между ними и не контролирует весь процесс.
Для решения этой задачи используют оркестраторы рабочих процессов. Один из самых популярных инструментов с открытым исходным кодом — Apache Airflow. С его помощью можно описывать пайплайны на Python в виде графов задач (DAG, Directed Acyclic Graph, направленный ациклический граф) задавать зависимости между ними, настраивать повторы и отслеживать выполнение через веб-интерфейс.
В статье разберем, как устроен Apache Airflow, что такое DAG, из каких компонентов состоит его архитектура, как установить оркестратор и какие практики помогают создавать надежные пайплайны. Также расскажем, как передать администрирование Airflow управляемому сервису в облаке.


Что такое Apache Airflow и какие задачи он решает
Apache Airflow — открытая платформа для оркестрации пайплайнов данных. Она запускает задачи по расписанию, следит за порядком их выполнения и показывает состояние в веб-интерфейсе. Для Airflow Python служит языком описания пайплайнов, поэтому DAG хранятся в Git и проходят тесты, как обычный код.
Оркестрация данных: зачем нужен отдельный инструмент
Обработка данных часто состоит из нескольких связанных этапов: нужно получить информацию из источников, преобразовать ее, загрузить в хранилище и подготовить к анализу. Важно, чтобы каждый следующий этап запускался только после успешного завершения предыдущего. Если управлять такими процессами с помощью отдельных скриптов и расписаний, становится сложнее отслеживать зависимости, находить ошибки и повторно запускать задачи.
Для этого используют оркестраторы данных. Они управляют последовательностью выполнения задач, учитывают зависимости между ними и помогают контролировать сбои. При этом оркестратор не заменяет инструменты обработки данных, а координирует их работу: например, запускает Spark, SQL-запросы или dbt в нужном порядке.
Один из распространенных сценариев применения оркестрации — построение ETL- и ELT-пайплайнов. Подробнее об этих подходах мы рассказывали в статье про ETL и DWH.
Airflow и cron: в чем разница
Cron запускает команду в заданное время и ничего не знает о ее результате. Airflow видит, что выполнилось, а что «упало»: он хранит зависимости между задачами, повторяет упавшие шаги и дает перезапустить одну задачу из интерфейса. Для одного скрипта в сутки хватит cron, а для десятка связанных шагов уже нужен оркестратор.
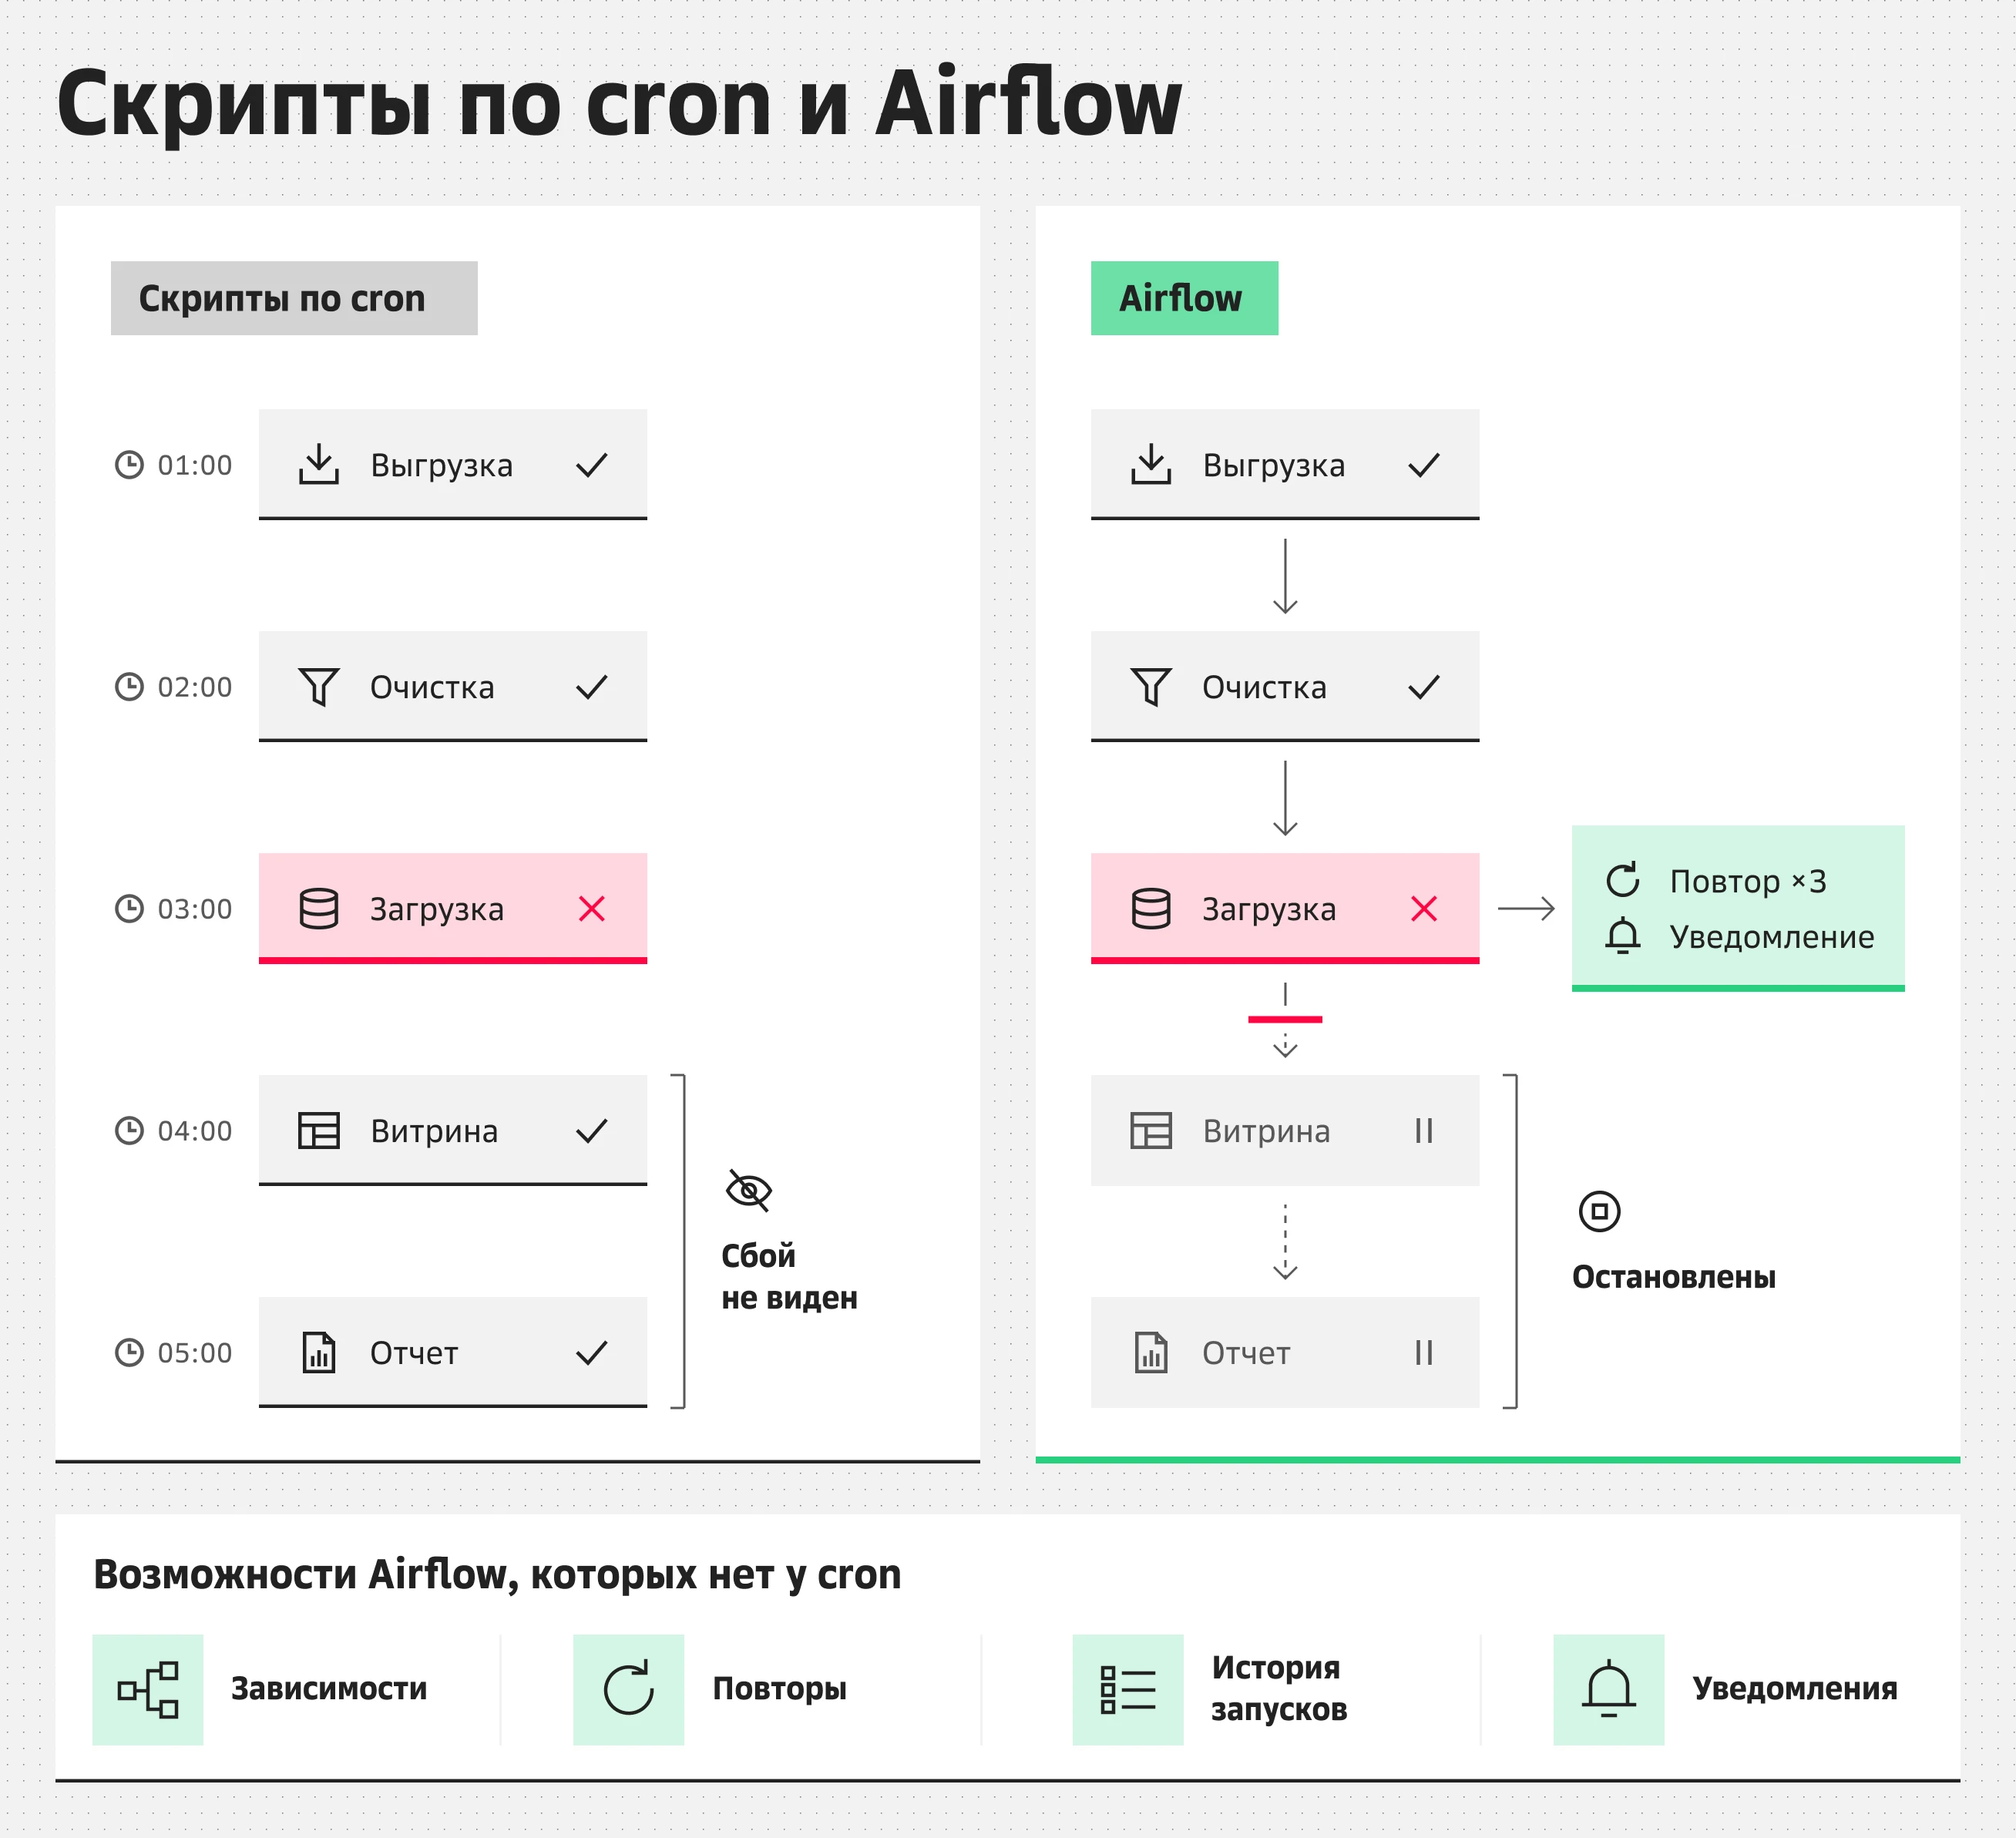 Запуск скриптов по cron и в Airflow: у cron нет зависимостей и сбой не виден, у Airflow есть связи, повторы и уведомления
Что такое DAG в Airflow
DAG (Directed Acyclic Graph, направленный ациклический граф) — главная единица Airflow: файл на Python с задачами, связями между ними и расписанием. Airflow DAG — это карта выполнения: логика живет в самих задачах, а граф лишь задает их порядок.
Задачи, зависимости и расписание
Задача (task) — один шаг пайплайна: запрос к API, загрузка файла, запуск Spark-приложения. Порядок задают оператором >> или передачей результата одной задачи в другую, а расписание — cron-выражением в параметре schedule. Пропущенные интервалы Airflow догоняет по параметру catchup и командой backfill.
Операторы и сенсоры
Операторы (operators) определяют, какое действие выполнит задача в Airflow. Например, BashOperator запускает команду в терминале, PythonOperator выполняет функцию на Python, а SQL-операторы отправляют запросы к базе данных.
Сенсоры (sensors) — особый тип операторов, которые не выполняют действие, а ждут наступления определенного события или выполнения условия. Например, сенсор может ожидать появления файла в объектном хранилище. Если ожидание длительное, можно использовать отложенный режим (deferrable mode): тогда выполнение передается компоненту Triggerer, а рабочий слот воркера освобождается для других задач.
XCom: как задачи передают данные друг другу
XCom (Cross-Communication) — механизм Airflow для обмена небольшими данными между задачами. По умолчанию Airflow сохраняет их в базе метаданных. Например, если функция с декоратором @task возвращает результат, Airflow автоматически передает его следующей задаче через XCom. При необходимости можно настроить собственный бэкенд для хранения XCom, в том числе в объектном хранилище.
Через XCom удобно передавать пути к файлам, идентификаторы и другие небольшие значения. Сами данные, особенно большие датафреймы, лучше хранить отдельно, например в объектном хранилище S3, а через XCom передавать ссылку на них. Так база метаданных не будет перегружаться.
Пример простого DAG на Python
Пример описывает ежедневный ETL из трех задач и написан для Airflow 3. Каждая задача оформлена функцией с декоратором @task.
Декоратор @dag объявляет граф и расписание: запуск каждый день в 6:00 UTC без догона пропущенных дат.
Параметр retries повторяет упавшую задачу до трех раз с паузой в пять минут.
Строка load(transform(extract())) выстраивает цепочку, а пути к данным передаются между задачами через XCom.
Архитектура Airflow
Архитектура Apache Airflow определяет, как задачи попадают в очередь, где выполняются и какие компоненты отвечают за их состояние. Понимание роли каждого из них помогает разобраться в процессе запуска пайплайна, быстрее находить причины сбоев и понимать, какие компоненты нужно администрировать.
Scheduler, workers, веб-сервер и база метаданных
В Airflow несколько компонентов, каждый из которых отвечает за свою часть работы:
Scheduler (планировщик) — создает запуски DAG по расписанию, проверяет зависимости между задачами, управляет backfill и передает готовые к выполнению задачи через Task Execution API.
DAG processor — обрабатывает файлы с описанием DAG и сохраняет структуру графов задач в базе метаданных.
Worker (исполнитель) — запускает задачи и выполняет заданные в них операции.
Triggerer — обслуживает отложенные операторы, которые ожидают наступления события или выполнения условия.
API-сервер — в Airflow 3 предоставляет веб-интерфейс и REST API для взаимодействия с внешними системами.
База метаданных — хранит информацию о запусках DAG, состоянии задач и XCom. Обычно для нее используют PostgreSQL или MySQL.
Что изменилось в Airflow 3
Apache Airflow 3.0 вышел 22 апреля 2025 года. В новой версии обновили архитектуру оркестратора, добавили возможности для управления пайплайнами и изменили работу с API.
Основные изменения:
Новая архитектура взаимодействия. Задачи обращаются к API-серверу через Task Execution API и больше не подключаются к базе метаданных напрямую. Это позволяет запускать workers в отдельных средах.
Версионирование DAG. Теперь можно управлять версиями графов задач.
Обновленный интерфейс и API. В Airflow 3 веб-сервер заменили API-сервером, который предоставляет интерфейс и REST API для внешних систем.
Управление backfill. Запусками для обработки данных за прошлые периоды теперь управляет Scheduler.
Запуск по событиям. Появилась возможность запускать задачи в ответ на события.
Новый способ импорта. Для DAG используют пространство имен airflow.sdk.
Изменения коснулись и уведомлений. В Airflow 3.0 удалили классические SLA. Вместо них в Airflow 3.1 появились Deadline Alerts. В этой версии они поддерживают только асинхронные колбэки AsyncCallback, которые выполняются на Triggerer. Поддержку синхронных колбэков SyncCallback, выполняемых через executor, отложили до версии 3.2.
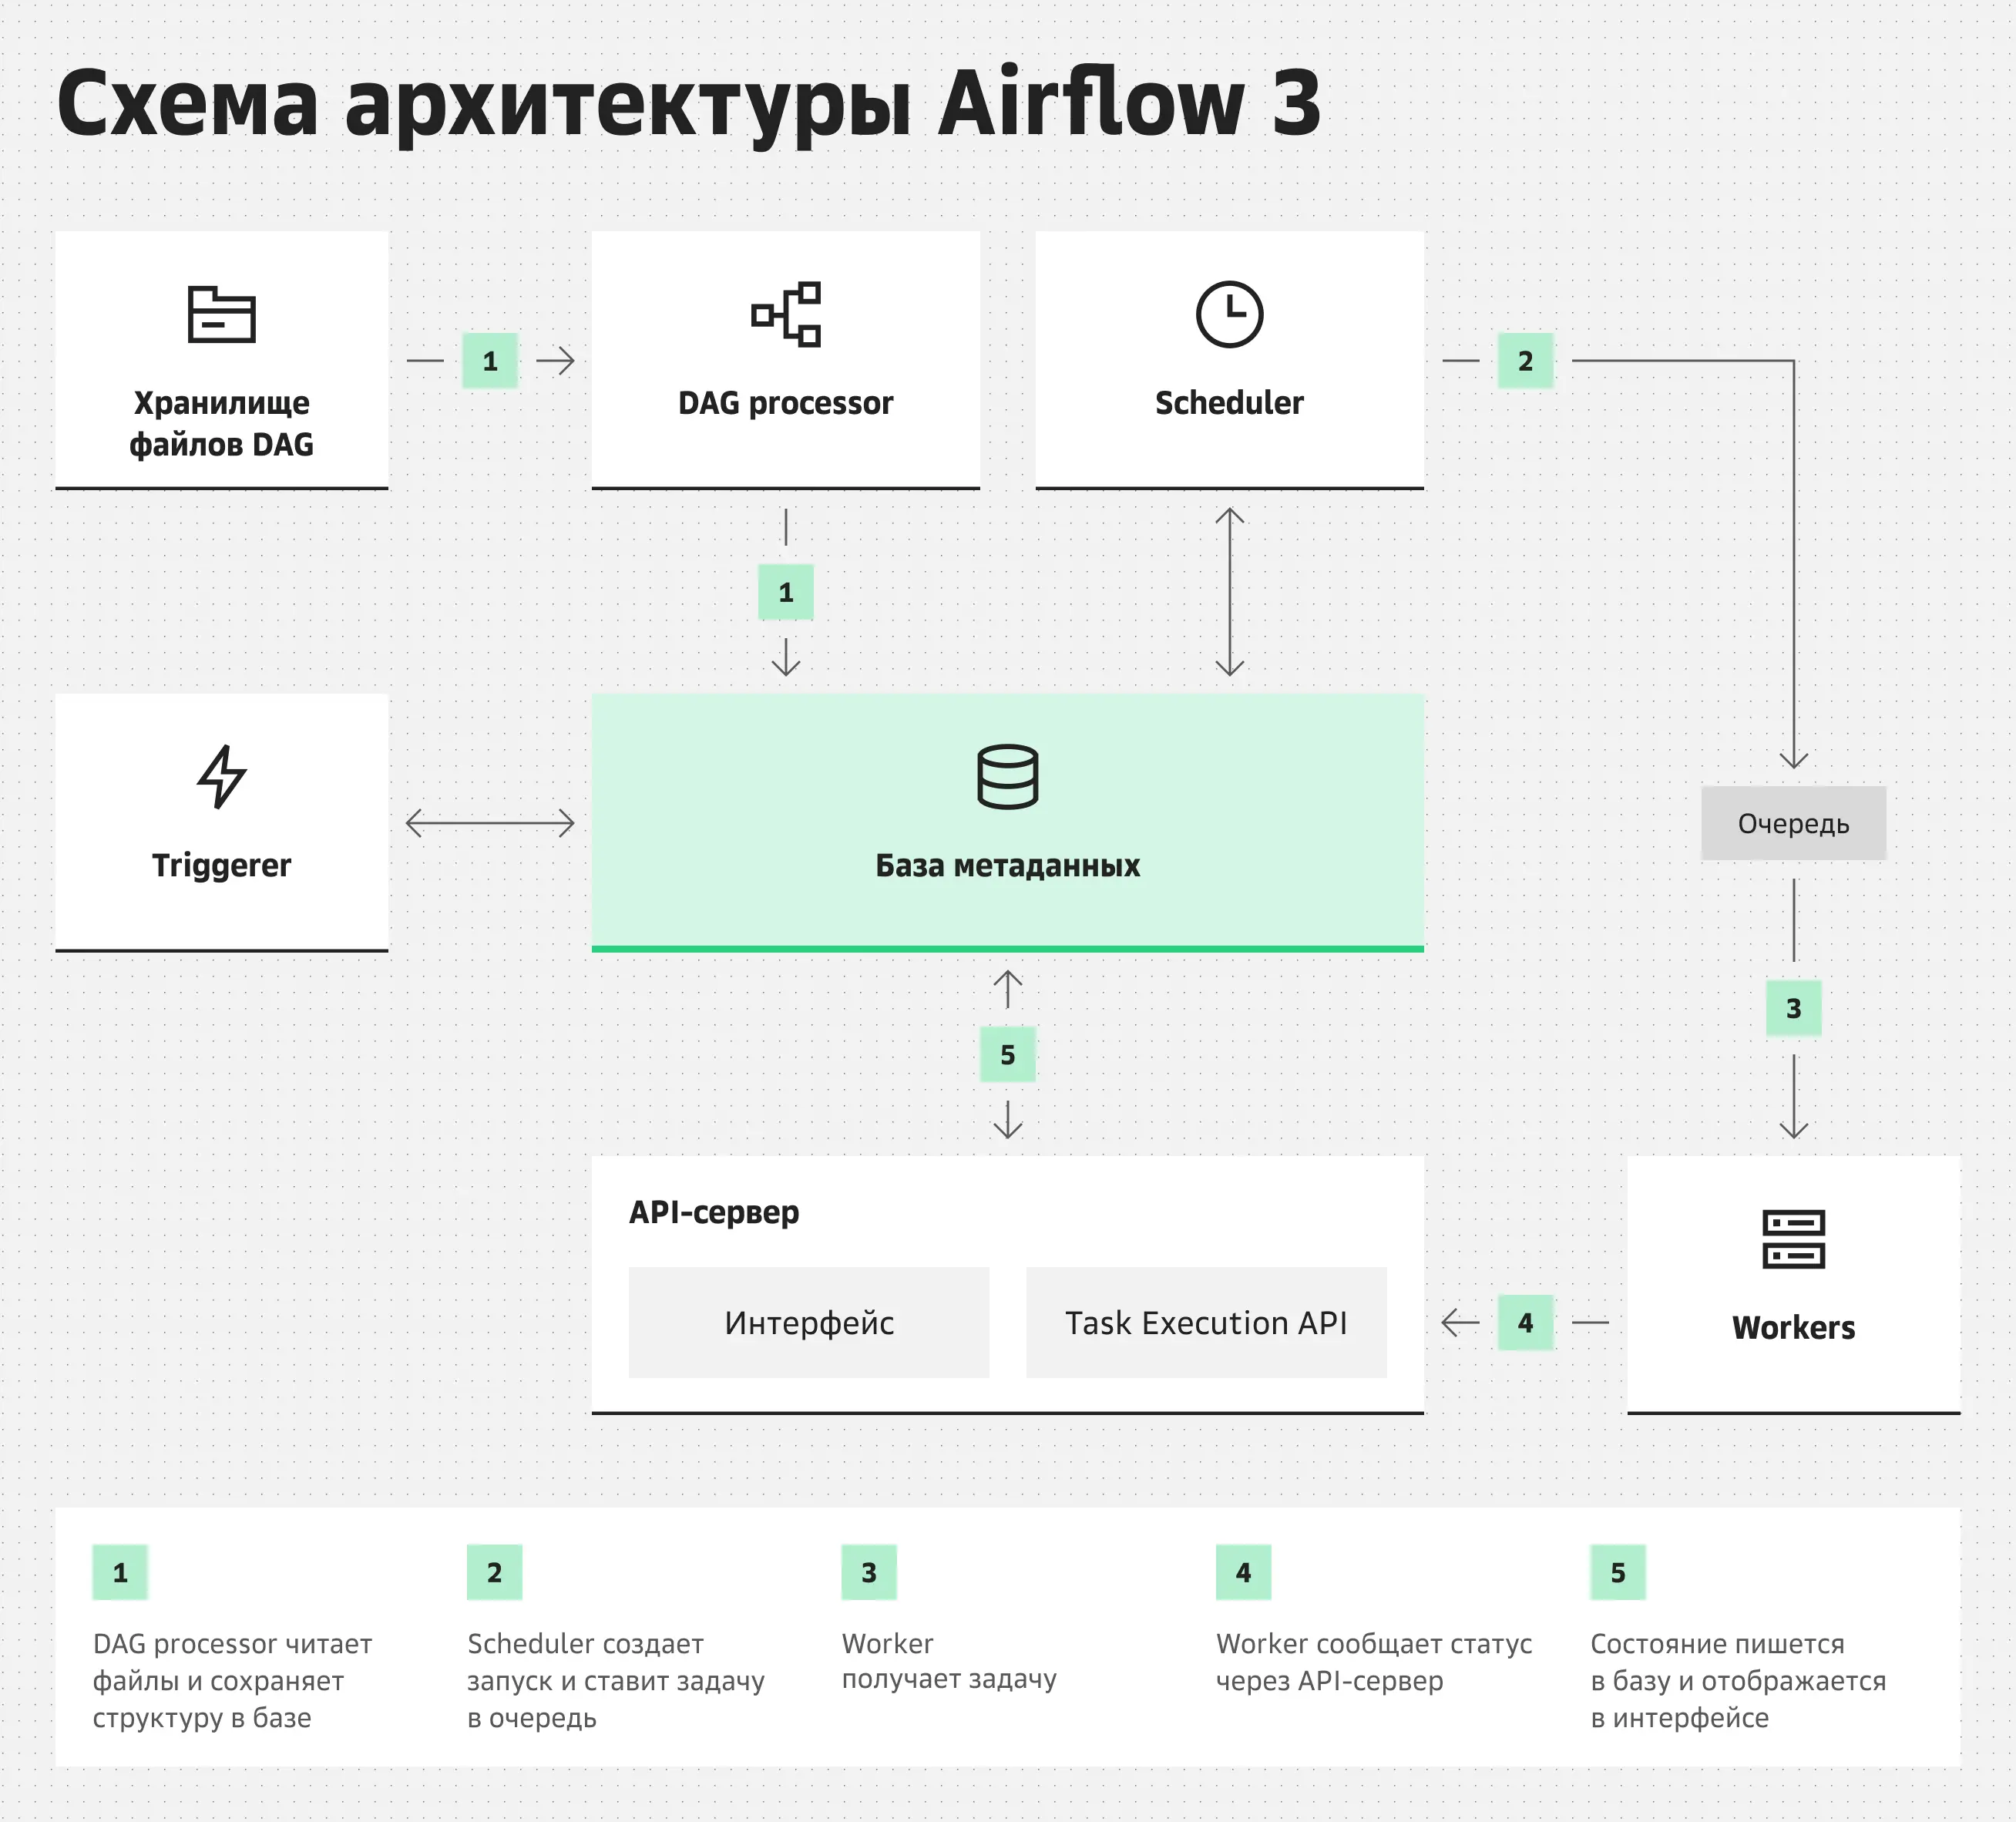 Схема архитектуры Airflow 3: DAG processor, scheduler, triggerer, workers, API-сервер и база метаданных с путем запуска задачи
Как установить Airflow
Установка Airflow — это еще и решение о том, кто будет обновлять версии, следить за базой данных и устранять сбои компонентов. От этого зависит, сколько времени у команды останется на пайплайны, а сколько уйдет на сопровождение платформы.
Docker Compose для локальной разработки
Для знакомства берут официальный Airflow Docker-образ и готовый docker-compose.yaml из документации проекта.
Если контейнеры в новинку, узнайте, чем Docker отличается от Kubernetes.
Порядок действий такой:
Скачать docker-compose.yaml и создать папки dags, logs, plugins и config.
Выполнить docker compose up airflow-init, чтобы инициализировать базу метаданных.
Запустить docker compose up и открыть интерфейс на localhost:8080.
Разработчики проекта рекомендуют такую конфигурацию только для обучения и экспериментов. В продакшене нужен Kubernetes или управляемый сервис.
Airflow в Kubernetes для продакшена
Airflow в Kubernetes запускает воркеры по мере нагрузки: с KubernetesExecutor каждая задача получает отдельный под (в отличие от CeleryExecutor, где воркеры — долгоживущие процессы, обслуживающие много задач), а установку упрощает официальный Helm-чарт.
Managed-сервис: когда администрирование не нужно
Провайдер разворачивает компоненты и следит за ними, а команде остаются DAG. Различия трех вариантов собраны в таблице:
Критерий | Docker Compose | Kubernetes | Managed Airflow |
Время запуска | Около часа | От нескольких дней | Несколько минут |
Версии Airflow | Обновляет команда | Обновляет команда | Актуальную версию дает Cloud.ru |
Масштабирование | Одна машина | Воркеры в подах, настраивает команда | Ресурсы задаются при создании инстанса |
Мониторинг | Интерфейс и логи контейнеров | Собственный стек метрик и логов | Интерфейс и метрики сервиса |
Кому подходит | Разработка и обучение | Командам с выделенным DevOps | Командам без отдельного DevOps |
Как писать надежные DAG: практики эксплуатации Airflow
При проектировании DAG важно учитывать, что задачи могут завершаться с ошибками и требовать повторного запуска. Чтобы сбои не приводили к потере или дублированию данных, нужно предусмотреть безопасные повторы, контролировать нагрузку на источники и настроить уведомления о проблемах.
Идемпотентные задачи и повторы
Идемпотентность — свойство задачи, при котором повторное выполнение не меняет итоговый результат. Например, если задача загружает данные за определенную дату, повторный запуск не должен создавать дубликаты. Для этого можно перезаписывать партицию за нужный день или использовать SQL-операцию MERGE.
Чтобы задача обрабатывала правильный период, дату берут из шаблона {{ ds }}. Это особенно важно при backfill — повторной загрузке данных за прошлые даты.
Если задача завершилась с ошибкой, Airflow может запустить ее повторно. Количество попыток и интервал между ними задают параметры retries и retry_delay. Для нестабильных API можно включить экспоненциальное увеличение паузы между попытками с помощью retry_exponential_backoff.
Пулы, concurrency и приоритеты
Пул (pool) ограничивает число одновременных задач, которые обращаются к одному ресурсу, например к базе-источнику с лимитом подключений. Параметры max_active_tasks и max_active_runs задают параллельность одного DAG. Приоритет priority_weight решает, какая задача получит свободный слот первой.
Обработка ошибок и уведомления
Функции on_failure_callback и on_success_callback вызываются при падении или успехе задачи и, например, отправляют сообщение в мессенджер. Контроль времени выполнения в Airflow 3.1 берут на себя Deadline Alerts вместо SLA задач. Мониторинг выполнения доступен в интерфейсе, а статусы запусков можно забирать через Airflow API.
Где применяют Airflow
Airflow используют для автоматизации процессов, состоящих из нескольких последовательных задач, которые нужно запускать по расписанию или при наступлении определенных событий. Он помогает контролировать выполнение каждого шага, отслеживать ошибки и повторять неудачные запуски.
Помимо обработки данных, Airflow применяют для генерации и отправки отчетов, управления инфраструктурой и организации ML-экспериментов.
ETL и ELT для аналитики
В ETL Airflow выгружает данные из API и баз, преобразует их и загружает в хранилище. В ELT преобразования (например, модели dbt) выполняются уже внутри хранилища. Airflow подходит для обоих сценариев: он умеет ждать готовности источника, повторять шаги и вызывать Spark. В результате витрины в хранилище данных остаются актуальными.
Пайплайны машинного обучения
Airflow автоматизирует регулярное переобучение моделей по свежим данным. Типовой ML-пайплайн состоит из пяти задач:
Выгрузить свежие данные из хранилища.
Подготовить признаки.
Обучить модель.
Сравнить метрики с текущей версией.
Опубликовать модель, если метрики улучшились.
Упавший шаг Airflow повторит, а модель не обновится на неполных данных. История запусков покажет, на каком шаге это произошло.

Evolution Managed Airflow в Cloud.ru
Evolution Managed Airflow — управляемый сервис оркестрации на платформе Cloud.ru Evolution, построенный на открытом Apache Airflow. Оплата идет по модели pay-as-you-go, а доступность сервиса — не менее 99,7%.
Актуальная версия Airflow и запуск за несколько минут
В сервисе доступен Apache Airflow 3.1.8 (на момент публикации в ноябре 2026) — последний патч ветки 3.1 — с версионированием DAG и новым интерфейсом. Развертывание занимает около десяти минут: сначала создают кластер Data Platform, затем в консоли выбирают образ Slim или Standard и задают ресурсы компонентов. Файлы DAG кладут в папку dags объектного хранилища, и они появляются в интерфейсе Airflow.
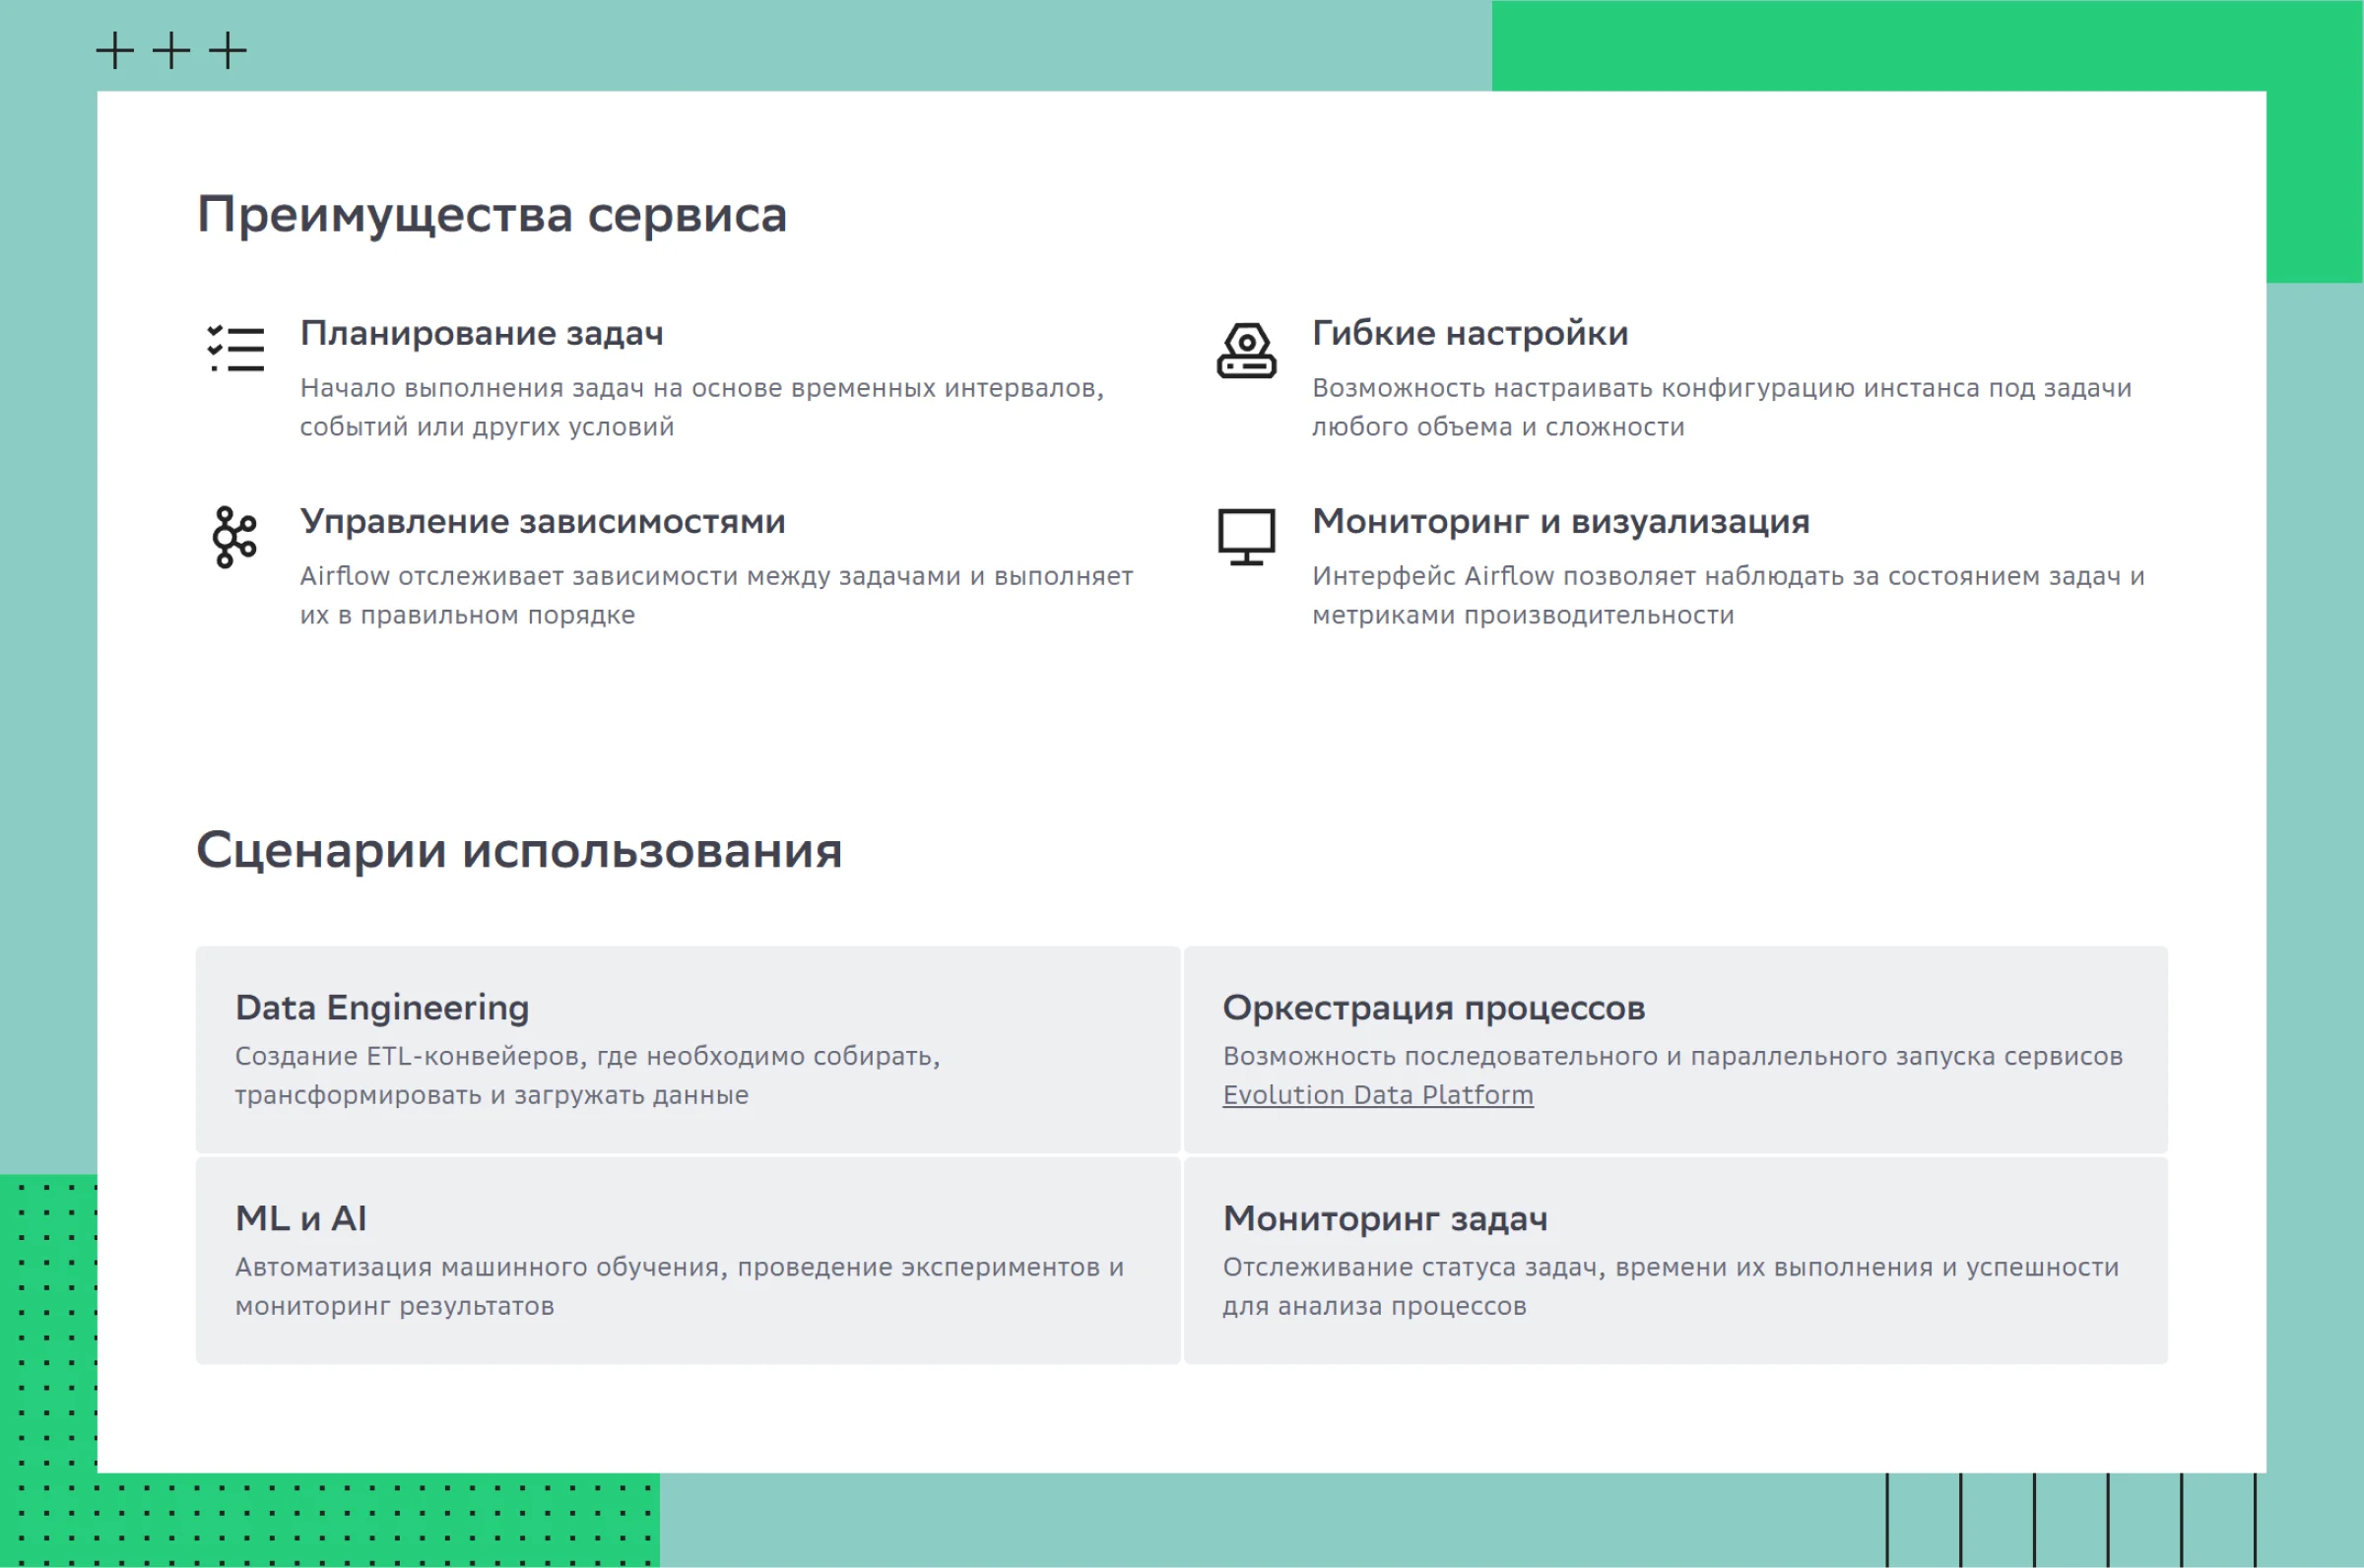 Evolution Managed Airflow: преимущества
Связка с сервисами Evolution Data Platform
Airflow оркестрирует задачи, которые выполняются в сервисах Evolution Data Platform. Потоки данных приходят через Evolution Managed Kafka, обрабатываются в Evolution Managed Spark, SQL-запросы к ним выполняет Evolution Managed Trino, витрины хранятся в Evolution Managed ArenadataDB, а дашборды строит Evolution Managed BI. Airflow связывает эти шаги в единый пайплайн: запускает их в нужном порядке и следит, чтобы сбой на одном этапе не прошел незамеченным.
Заключение
Apache Airflow помогает управлять процессами обработки данных: объединять задачи в пайплайны, задавать зависимости между ними, контролировать выполнение и оперативно реагировать на сбои. Чтобы такие процессы оставались надежными, важно правильно проектировать DAG, предусматривать безопасные повторные запуски и следить за нагрузкой на источники данных.
FAQ
Apache Airflow: что это такое простыми словами?
Открытая платформа, которая запускает задачи с данными по расписанию и в правильном порядке. Пайплайн описывается кодом на Python, а ход выполнения виден в веб-интерфейсе.
Что такое DAG в Airflow?
Направленный ациклический граф: набор задач и связей между ними без циклов.
Чем Airflow отличается от cron?
Cron лишь запускает команду по времени. Airflow добавляет зависимости между задачами, повторы, историю запусков и уведомления о сбоях.
Нужно ли знать Python, чтобы работать с Airflow?
Базовый уровень нужен: DAG пишут как обычный файл с функциями. Остальное делают готовые операторы.
Как установить Airflow в Docker?
Скачайте официальный docker-compose.yaml, выполните docker compose up airflow-init, затем docker compose up. Интерфейс откроется на localhost:8080.
Что нового в Airflow 3?
Версионирование DAG, новый интерфейс, backfill под управлением планировщика и Task Execution API, который отделяет выполнение задач от базы.
Когда выбирать управляемый Airflow вместо своей установки?
Когда у команды нет выделенного DevOps или администрирование отнимает время у пайплайнов. Взять на себя развертывание и мониторинг может Evolution Managed Airflow.