Контекстное окно LLM: что это и на что влияет его размер
Контекстное окно определяет, какой объем информации языковая модель может учитывать при обработке запроса. От его размера зависит, насколько длинные документы и диалоги LLM способна обрабатывать за один раз, сколько деталей удерживает в контексте и как работает с большими объемами данных.
Если контекстного окна не хватает, модель может терять информацию из начала диалога или не учитывать часть документа. А увеличение окна не всегда означает более быстрые ответы. Разберемся, как работает контекстное окно, на что влияет его размер и какую LLM выбрать для своих задач.


- Что такое контекстное окно простыми словами
- Что входит в контекстное окно
- Какой размер контекстного окна у популярных моделей
- Почему большой контекст — не всегда лучше
- Как работать с данными, которые не помещаются в окно
- Как выбрать модель по размеру контекста
- Модели с длинным контекстом в Cloud.ru
- Evolution Managed RAG для больших баз документов
Что такое контекстное окно простыми словами
Контекстное окно — объем текста в токенах, который языковая модель обрабатывает за один раз. Это могут быть история диалога, документы, системные инструкции, собственные ответы. Все, что в окно не помещается, модель не видит.
Контекстное окно связано с архитектурой трансформера — модели, которая обрабатывает данные с помощью механизма внимания (attention). Это помогает LLM учитывать связи между частями текста при формировании ответа.
Некоторые путают размер контекстного окна с объемом текста, который модель может сгенерировать в одном ответе. Это разные понятия. Во втором случае речь о лимите генерации, который отвечает за длину ответа нейросети.
Аналогия с рабочей памятью человека
Представьте, что вы разговариваете по телефону и параллельно читаете документ. Пока информации немного, вы можете следить за ходом беседы, запоминать важные сведения из отчета и сопоставлять их между собой. Но если одновременно подключатся еще несколько собеседников и появятся новые документы, удерживать все детали и связи между ними станет сложнее.
Похожим образом работает контекстное окно LLM: оно ограничивает объем информации, которую модель может учитывать при формировании ответа. Если данных слишком много, часть из них может не попасть в контекст, и модель не сможет использовать их при обработке запроса.
При этом контекстное окно не стоит воспринимать как аналог человеческой памяти. Даже если вся информация помещается в него, это не гарантирует, что модель учтет каждую деталь, правильно свяжет факты и не упустит важные условия. Поэтому при выборе LLM важно оценивать не только размер контекстного окна, но и то, насколько хорошо модель работает с большим объемом информации.

Почему контекст измеряют в токенах, а не в словах
Токены — небольшие единицы текста. Модель разбивает на них все входные данные для удобства обработки. Токены позволяют одинаково измерять объем текста на разных языках и учитывать не только слова, но и числа, знаки, программный код.
Токеном может быть целое слово или его часть, цифра или знак препинания. Например, короткое слово «кот» модель представит одним токеном, а длинное — несколькими. Есть еще нюансы. При этом русские и английские тексты могут содержать одинаковое количество слов, но разное количество токенов. Причина в том, что словари ИИ‑моделей создаются на английском, а для кириллицы места меньше. Именно поэтому нейросети почти всегда собирают русские слова по частям.
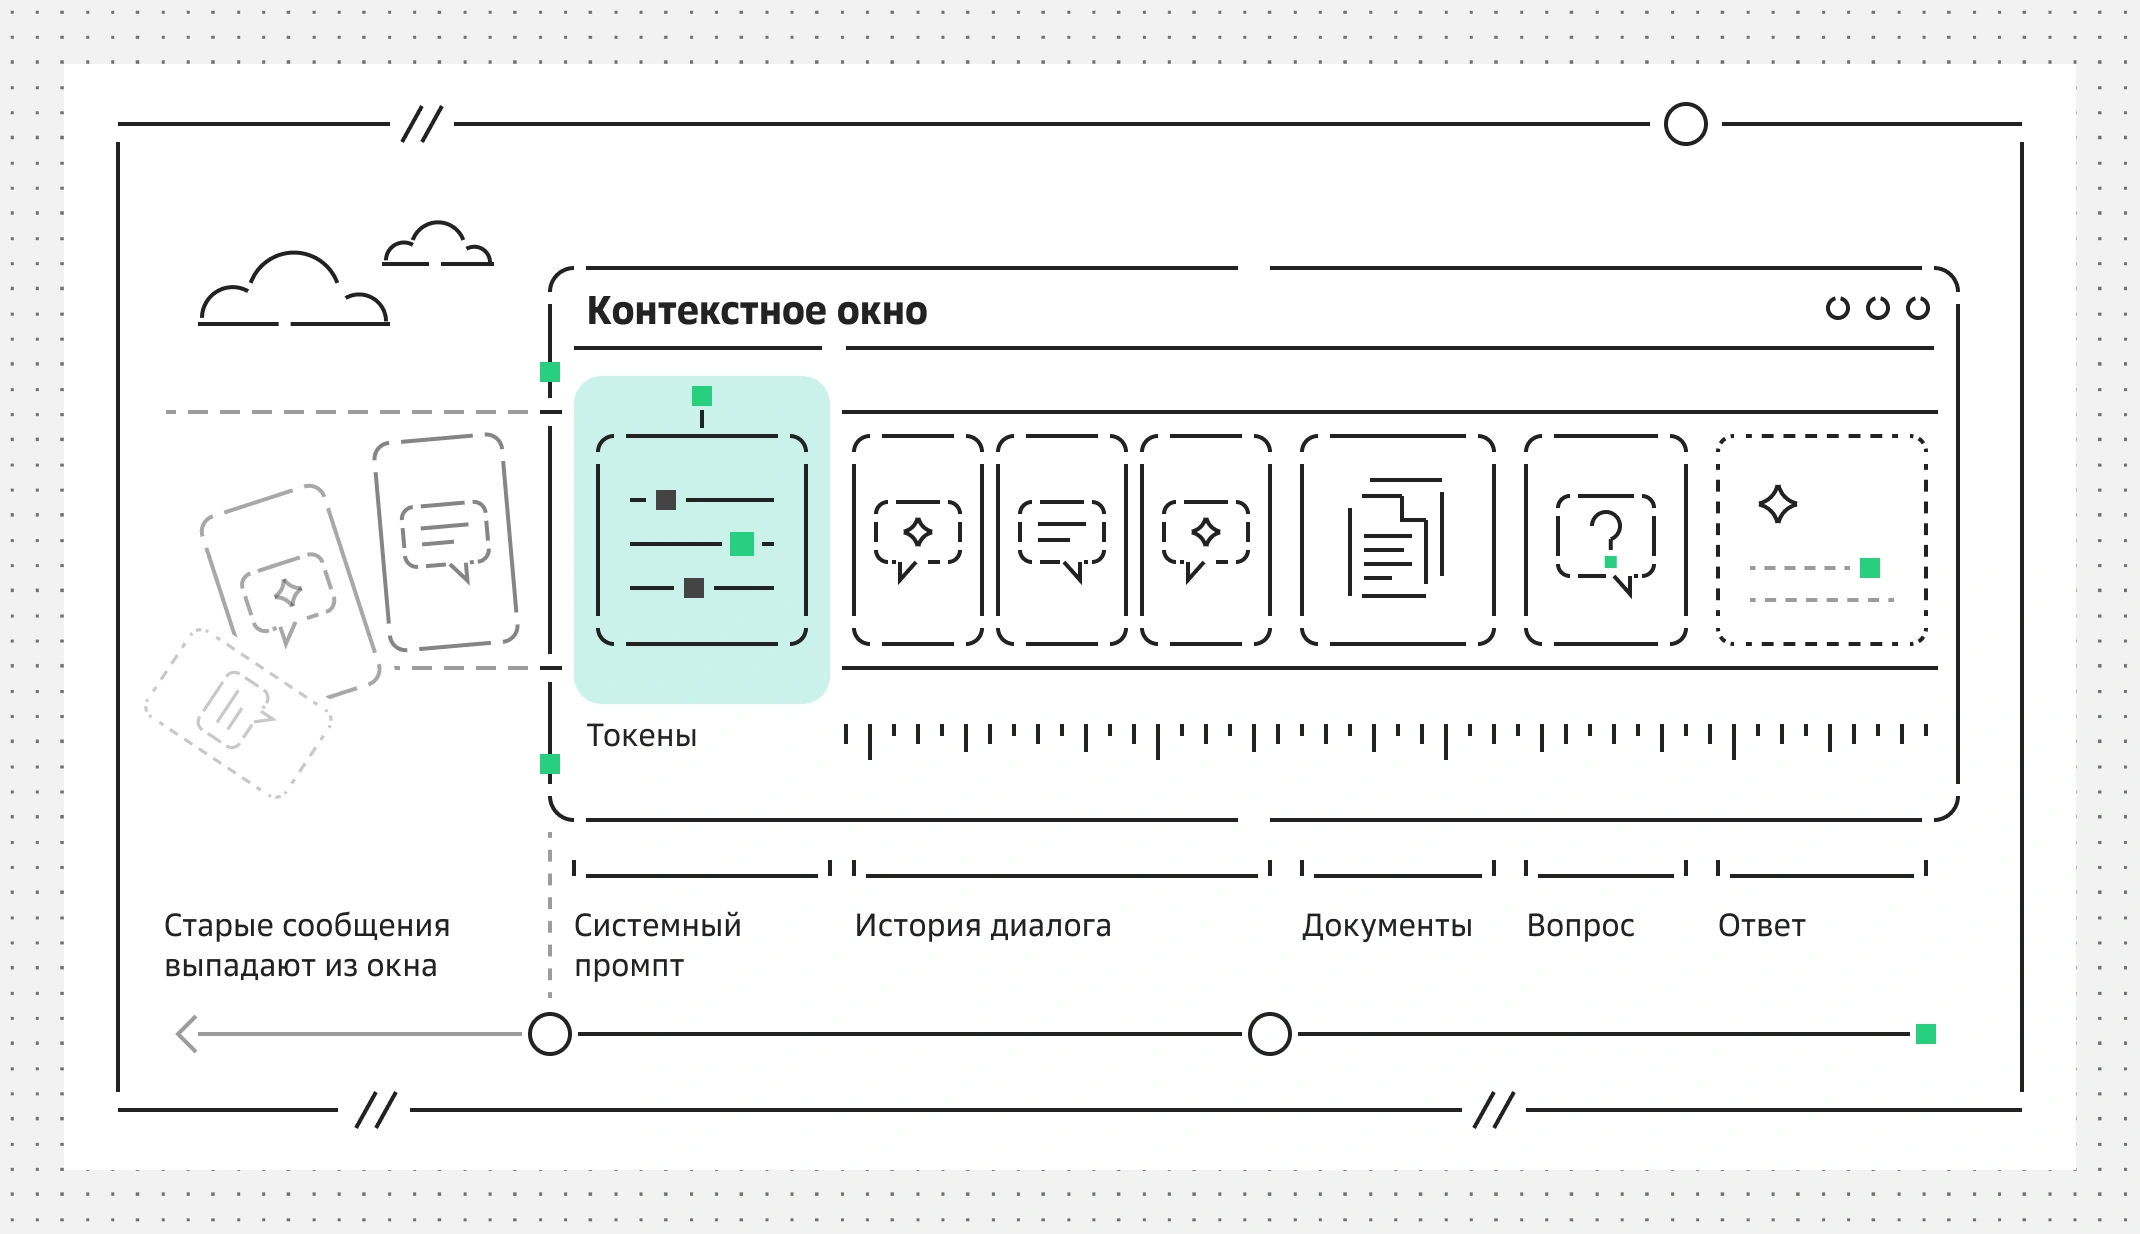 Схема контекстного окна
Что входит в контекстное окно
Контекстное окно включает не только текст, который пользователь отправляет в запросах. Что еще:
Системный промпт — инструкции для работы нейросети. Например, просьба придерживаться определенного стиля или формата ответа, генерировать текст на русском языке.
История диалога — предыдущие запросы пользователей и ответы модели, которые помогают поддерживать разговор в нужном русле. Благодаря истории не приходится каждый раз повторять условия.
Документы и дополнительные данные — содержимое файлов, информация из баз знаний и результаты поиска, которые модель использует для ответа.
Все это помогает модели давать релевантные ответы без уточнений на каждом шаге.
Ответ модели тоже занимает контекст
Модель не только получает данные, но и генерирует новые. Ее ответы тоже входят в доступный объем контекста, если передаются при следующих запросах и сохраняются в истории. Длинные диалоги занимают много места, даже если сообщения пользователя короткие.
Есть ли у нейросети память между диалогами
Контекстное окно само по себе не обеспечивает сохранение информации между диалогами. При обработке нового запроса модель учитывает только те данные, которые переданы ей в текущем контексте. Поэтому сведения из предыдущих разговоров не переносятся в новый автоматически.
Однако приложение может использовать отдельную систему памяти. Она сохраняет важную информацию из прошлых диалогов, файлы и документы, а при необходимости передает их модели вместе с новым запросом. Так LLM может учитывать предыдущий опыт взаимодействия, даже если исходная переписка уже не входит в контекстное окно.
Какой размер контекстного окна у популярных моделей
Параметры зависят от конкретных моделей из семейств. Например, в одной линейке могут быть версии на 128 тысяч, 200 тысяч или миллион токенов. Кроме того, роль играет формат развертывания модели и способ доступа к ней.
Как менялся размер контекста: от тысяч до миллиона токенов
Первые LLM работали с коротким контекстом в несколько тысяч токенов. Этого было достаточно для диалогов с простыми ответами, но мало для анализа больших файлов.
Затем контекстные окна выросли до десятков и сотен тысяч токенов. Это позволило передавать модели большие фрагменты кода, документы, длинные диалоги. В новых поколениях отдельных моделей лимит достиг миллиона токенов.
Сколько страниц текста помещается в окно
Количество страниц зависит от языка, форматирования текста, длины слов, наличия таблиц и специальных символов. Приблизительно на одну страницу простого английского текста приходится около 500 токенов. Таким образом, в контекстное окно на 128 тыс. токенов может поместиться примерно 260 страниц англоязычного текста без сложного форматирования. Однако для русского языка, документов с таблицами, кодом или специальными символами количество токенов на страницу значительно возрастает, поэтому реальное число страниц будет меньше (ориентировочно 200–300 страниц в зависимости от языка и структуры текста).
Контекстное окно популярных моделей
Актуальные параметры для конкретных версий моделей:
Модель | Контекстное окно (токены) | Примерное количество страниц текста |
DeepSeek V4 Pro/ Flash | до 1 млн | до 2000 |
Qwen3 (открытые модели) | до 128 тыс | до 256 |
Kimi K3 | до 1 млн | до 2000 |
GLM-5.2 | 1 млн | до 2000 |
GigaChat 3 Ultra | 128 тыс | до 256 |
Claude Opus 5 / Sonnet 5 | до 1 млн | до 2000 |
Gemini 4 Argon | н/д (лимит вывода — 1 млн токенов) | до 2000 |
Gemini 4 Argon использует объединенное контекстное окно (input + output) размером 1 048 576 токенов. Максимальный объем генерации по умолчанию составляет 65 536 токенов; при использовании режима длинного декодирования (long decode) он может достигать 1M токенов, если входная часть контекста занимает меньшую долю окна.
Для Claude Opus 5 и Sonnet 5 заявленное контекстное окно составляет 1 млн токенов. В веб-интерфейсе claude.ai для Sonnet 5 действует автоматическое сжатие беседы при достижении 500K токенов, тогда как в Claude Code полное окно 1M доступно без дополнительных настроек.
Почему большой контекст — не всегда лучше
Миллион токенов контекстного окна в характеристиках модели впечатляюще выглядит, но на практике не всегда приносит пользу. Важны не только объемы данных, но и умение нейросети с ними работать.
Эффект «lost in the middle» : модель хуже видит середину текста
Нейросети с большим контекстом могут использовать информацию из начала и конца длинного диалога, а про середину «забывают». Часто этот эффект проявляется при работе с документами. Например, в начале многостраничного договора указаны общие условия, в конце — порядок оплаты, в середине — частные случаи расторжения. При генерации ответа модель может не учесть как раз эти случаи, несмотря на то, что весь текст поместился в контекстное окно.
Стоимость и скорость растут вместе с контекстом
Длинный ввод увеличивает время ожидания ответа и требует большого количества вычислительных ресурсов, что влияет на стоимость запроса, особенно если оплата зависит от объема входных и выходных токенов.
Чтобы сократить время ответа и расходы, лучше не передавать каждый раз историю или весь документ целиком. Если используется система RAG (Retrieval-Augmented Generation), она находит релевантные фрагменты и передает модели только их. Также применяется кэширование (KV-кеш) повторяющегося контекста.
Чем заявленный размер отличается от эффективного
Заявленный размер — технический предел нейросети, рассчитанный с учетом ее возможностей. Эффективный показывает, насколько хорошо модель выполняет обработку при допустимом объеме данных. Показатели не всегда совпадают. Например, модель фактически принимает миллион токенов, но работать без «галлюцинаций» и ошибок с ними не может.
Особенно часто проблемы обнаруживаются в задачах, где нужно сопоставить данные из разных частей текста, одновременно учесть несколько условий или найти противоречия.
По возможности перед корпоративным использованием проверьте модель на разноплановых запросах и собственных документах.
Как работать с данными, которые не помещаются в окно
Не обязательно передавать документы, истории диалогов или базы знаний целиком. Можно использовать RAG, отдавать только ключевые факты или обрабатывать файлы частями.
RAG: передача модели только нужных фрагментов, обрезка контекста
RAG (Retrieval-Augmented Generation) — подход, позволяющий модели перед генерацией ответа получать дополнительные сведения из внешних источников. Система находит фрагменты, связанные с пользовательским запросом и добавляет их в контекст, не подгружая всю базу знаний. При генерации модель использует предоставленные данные и при необходимости указывает источники.
Благодаря RAG модель может работать с базами знаний, сильно превышающими контекстное окно. Подход особенно полезен для компаний, где много инструкций, справочников, технической документации. Дополнительно можно использовать гибридный поиск и повторное ранжирование результатов.
Суммаризация истории и долговременная память агента
В длинных диалогах история переписки постепенно занимает все больше места в контекстном окне. Кроме того, повторная передача всех сообщений при каждом запросе увеличивает расход токенов, а значит, и стоимость работы с моделью. Один из способов решить эту проблему — суммаризация. Она позволяет сократить историю до ключевых фактов и текущего состояния задачи.
Например, вместо десятков сообщений о разработке приложения модели можно передать краткое описание его архитектуры, принятых решений и оставшихся ошибок. Так она получит необходимую информацию без повторной обработки всей переписки.
Другой подход — долговременная память агента. Она позволяет хранить информацию между сессиями в отдельном хранилище, не занимая контекстное окно постоянно. Это могут быть предпочтения пользователя, важные факты, текущее состояние задач и история взаимодействий. При новом обращении агент извлекает сведения, которые относятся к запросу, и добавляет их в контекст модели.
Суммаризация помогает сократить историю текущего диалога, а долговременная память — сохранить важные сведения для последующих сессий.
Деление документа на части
Разбиение документа на части (chunking, чанкинг) — работа с небольшими фрагментами текста, которые можно независимо индексировать и передавать модели. Есть несколько стратегий деления:
Разбиение документа на фрагменты фиксированного размера. Это проще всего, но могут быть разорваны связанные мысли и предложения
Рекурсивное разбиение. Разделение текста на крупные фрагменты, а затем при необходимости на отдельные предложения.
Разбиение по структуре. Текст разделяется по главам, разделам, пунктам. Ориентиром обычно служат заголовки. Этот метод удобен для технической документации и инструкций.
Семантическое разбиение. Фрагменты текста формируют по смыслу, объединяя предложения на одну тему. Это сложно, зато точно сохраняются логические связи.
Чтобы связанные данные не оказались далеко друг от друга, можно использовать перекрытие (overlap), когда фрагменты захватывают немного текста из соседних. Также обычно сохраняют название файлов, заголовки и метаданные.

Для сравнения — таблица «длинный контекст vs RAG»:
Критерий | Длинный контекст | RAG |
Объем данных | Большой объем текста в одном запросе | База, из которой извлекаются нужные фрагменты |
Стоимость запроса | Может быть высокой при передаче большого объема текста | Обычно ниже, если не нужно передавать много данных, но есть расходы на поиск и хранение |
Скорость ответа | Зависит от объема контекста и модели | Зависит от скорости поиска и генерации |
Точность на длинных документах | Удобно анализировать связи между разделами, но важные детали можно упустить | Хорошо ищет конкретные сведения, но может пропустить нужный фрагмент |
Обновление данных | Нужно передать актуальный текст в запросе | Достаточно обновить документы в базе и их индекс |
Когда выбирать | Анализ договоров, отчетов или длинной переписки | Вопросы по большой базе знаний, документации или архиву документов |
Как выбрать модель по размеру контекста
При выборе LLM не стоит ориентироваться только на максимальный размер контекстного окна. Важнее учитывать задачи модели, объем информации, с которой ей предстоит работать, и качество обработки длинных запросов. Разберем, какой размер контекста подойдет для разных сценариев.
Чат-бот и поддержка
Для чат-ботов, которые отвечают на типовые вопросы и помогают пользователям решать простые задачи, обычно достаточно небольшого или среднего контекстного окна. Оно позволяет учитывать текущий запрос и историю диалога.
Большое контекстное окно понадобится, если бот должен анализировать длинные переписки, учитывать множество инструкций, правил и дополнительных материалов одновременно.
Эффективный способ предоставить боту доступ к большому объему информации — использовать RAG. В этом случае система находит в базе знаний материалы, релевантные запросу, и передает их модели. Так не нужно загружать всю базу в контекстное окно при каждом обращении.
Анализ договоров и отчетов
При выборе модели для работы с документами важно учитывать несколько параметров:
Объем документов. Если нужно анализировать большие файлы или сопоставлять несколько документов целиком, потребуется модель с достаточно большим контекстным окном.
Сложность анализа. Найти конкретный пункт в договоре проще, чем проверить взаимосвязи между десятками разделов или сопоставить условия нескольких документов. Для таких задач важны не только размер контекста, но и способность модели рассуждать и находить связи между фактами.
Точность извлечения информации. Модель должна не просто обрабатывать большой объем текста, но и корректно находить нужные условия, цифры и формулировки.
Для регулярного анализа финансовой отчетности, технической и юридической документации стоит выбирать модели с большим контекстным окном и проверять качество работы на реальных документах. Сам по себе большой объем контекста еще не гарантирует точности анализа.
Агенты и работа с кодовой базой
ИИ-агенты способны взять на себя часть рутинных бизнес задач. Например, они могут писать код или исправлять ошибки в готовом, участвовать в многошаговых процессах, делать отчеты. Чем сложнее задача, тем больше данных нужно модели для работы.
При выборе LLM учитывайте масштабы проекта, качество работы с инструментами, возможность управления историей, память нейросети. Большое контекстное окно — плюс, если в нем действительно есть необходимость.
Модели с длинным контекстом в Cloud.ru
Для задач, требующих обработки больших объемов текста, в Cloud.ru доступны языковые модели в сервисе Evolution Foundation Models. Если нужно дополнить возможности LLM корпоративными знаниями и документами, можно использовать Evolution Managed RAG. Он помогает организовать поиск релевантной информации в собственной базе знаний и передавать ее модели для формирования ответов.
Модели с контекстом до 1 млн токенов в Evolution Foundation Models
Сервис предоставляет доступ по API к каталогу готовых моделей. Среди вариантов есть модели с контекстным окном около 1 млн токенов, в том числе DeepSeek-V4-Pro и Gemini 2.5 Pro. Актуальный список доступных моделей и их параметры можно проверить в каталоге Evolution Foundation Models.
Evolution Managed RAG для больших баз документов
Evolution Managed RAG — это сервис, который позволяет связывать LLM с внутренними данными и базами знаний без развертывания ИТ-инфраструктуры. Вы загружаете в хранилище документы, а Evolution Managed RAG предоставляет модели сведения для генерации ответов. Пополнять и актуализировать базу можно в один клик.
Заключение
Размер контекстного окна — важная, но не единственная характеристика языковой модели. При выборе LLM стоит учитывать не только заявленный объем контекста, но и эффективность работы с ним: способность удерживать детали, находить связи между фактами и не терять информацию в середине длинного текста. Для задач, где нужно анализировать большие документы или вести длительные диалоги, большой контекст может быть полезен. Однако для динамично обновляемых баз знаний часто эффективнее использовать RAG — он позволяет передавать модели только релевантные фрагменты, снижает стоимость запросов и упрощает обновление данных.
FAQ
Что такое контекстное окно?
Объем текста, который нейросеть может учитывать при обработке одного запроса. Это могут быть документы, инструкции, пользовательские запросы, ответы модели.
Что будет, если текст не поместится в контекстное окно?
Текст придется дробить на фрагменты или использовать поиск, чтобы передать основные данные.
У какой нейросети самое большое контекстное окно?
Лимиты зависят от версии модели и условий доступа. Актуальные показатели лучше проверять в документации конкретного сервиса.
Сколько страниц текста помещается в 128 тыс. токенов?
Ориентировочно 200–300 страниц обычного текста, но объем зависит от языка, форматирования и символов.
Почему нейросеть забывает начало диалога?
Длинная переписка может занимать слишком много места, поэтому нейросети заменяют часть истории кратким пересказом либо обрезают. Кроме того, некоторые модели плохо воспринимают информацию, которая находится далеко от последнего запроса.
Чем длинный контекст отличается от RAG?
Длинный контекст позволяет передать большой объем текста в запросе. RAG ищет нужные данные во внешних источниках и передает только релевантные фрагменты.
Влияет ли размер контекста на стоимость запроса?
Стоимость зависит от количества входных и выходных токенов, тарифов модели. Запрос может обойтись дороже, если нейросеть обрабатывает много текста.