Как развернуть свою LLM: ML-инференс на GPU
Запустить языковую модель на ноутбуке можно за один вечер: скачать веса с Hugging Face, установить Ollama и отправить первый запрос. Но если модель нужно использовать в рабочем сервисе, локального запуска уже недостаточно. Нужно обеспечить доступность эндпоинта, обрабатывать несколько запросов одновременно, учитывать скачки нагрузки и заранее оценить расходы на инфраструктуру.



- Что такое инференс в продакшене и из чего он состоит
- Когда пора выводить LLM в продакшен
- Сколько GPU-памяти нужно модели
- Выбор GPU: V100, A100 и H100
- Среды исполнения: vLLM, SGLang и Ollama
- Как развернуть LLM на Evolution ML Inference
- Автомасштабирование, метрики и экономика
- Evolution Foundation Models или Evolution ML Inference
Разница между пилотом и промышленной эксплуатацией заметна и по статистике. По оценкам «Инфосистемы Джет», представленным на мероприятии State of AI Russia в 2026 году, большие языковые модели (Large Language Models, LLM) используют или пилотируют 86% крупных российских организаций. При этом решения на базе генеративного ИИ вывели в промышленную эксплуатацию только 53%. Почти половина проектов так и не вышла за рамки пилота.
В этой статье разберем, как пройти путь от весов модели до рабочего эндпоинта: рассчитать необходимый объем видеопамяти, выбрать графический процессор (GPU) и среду исполнения, настроить инференс с автомасштабированием и проверить работу сервиса по ключевым метрикам.
Подробнее обсудить инфраструктуру для ИИ и ML можно на GoCloud Tech 2026 15 октября в Москве. В программе — GPU-инфраструктура, производительность, разработка, данные и другие практические задачи, которые возникают при запуске ИИ в продакшене.
Что такое инференс в продакшене и из чего он состоит
Продакшен-инференс — это связка из нескольких компонентов, которые вместе принимают запросы, выполняют вычисления и возвращают результат приложению:
Модель — ее веса, например, из Hugging Face, или собственная дообученная версия.
Среда исполнения (runtime) — vLLM, TGI или Ollama. Она запускает модель и оптимизирует обработку запросов и использование GPU.
GPU — вычислительные ресурсы, которые обеспечивают работу модели под реальной нагрузкой.
API-слой — программный интерфейс, через который приложения отправляют запросы к модели и получают ответы. Часто используют OpenAI-совместимый API.
Когда пора выводить LLM в продакшен
Локальный запуск хорошо подходит для экспериментов и прототипов, но не всегда выдерживает рабочую нагрузку. Переходить к ней стоит, когда к модели появляются требования по доступности, параллельным запросам или масштабированию:
Модели нужна предсказуемая доступность (uptime). Если сервис используется клиентами или работает по внутреннему соглашению об уровне обслуживания (Service Level Agreement, SLA), он должен оставаться доступным независимо от состояния ноутбука или рабочей станции.
К модели обращаются несколько сервисов. При росте числа одновременных запросов нужен инференс-сервис, который эффективно распределяет нагрузку и объединяет запросы в группы для совместной обработки (batching), чтобы GPU не простаивал.
Нагрузка сильно меняется в течение дня. Например, бот поддержки может получать в десятки раз больше запросов днем, чем ночью. Держать постоянный запас GPU под максимальный пик дорого, поэтому важно, чтобы продакшен-инфраструктура могла масштабироваться под нагрузку.
Модель не помещается в доступную видеопамять. Например, модель на 70B параметров в FP16 требует около 140 ГБ памяти только для хранения весов — это минимальная оценка без учета KV-cache и служебных буферов. С запасом +20% для планирования стоит ориентироваться на ~168 ГБ. В таком случае выбирать нужно не только подходящее GPU, но и использовать несколько ускорителей или использовать квантование.
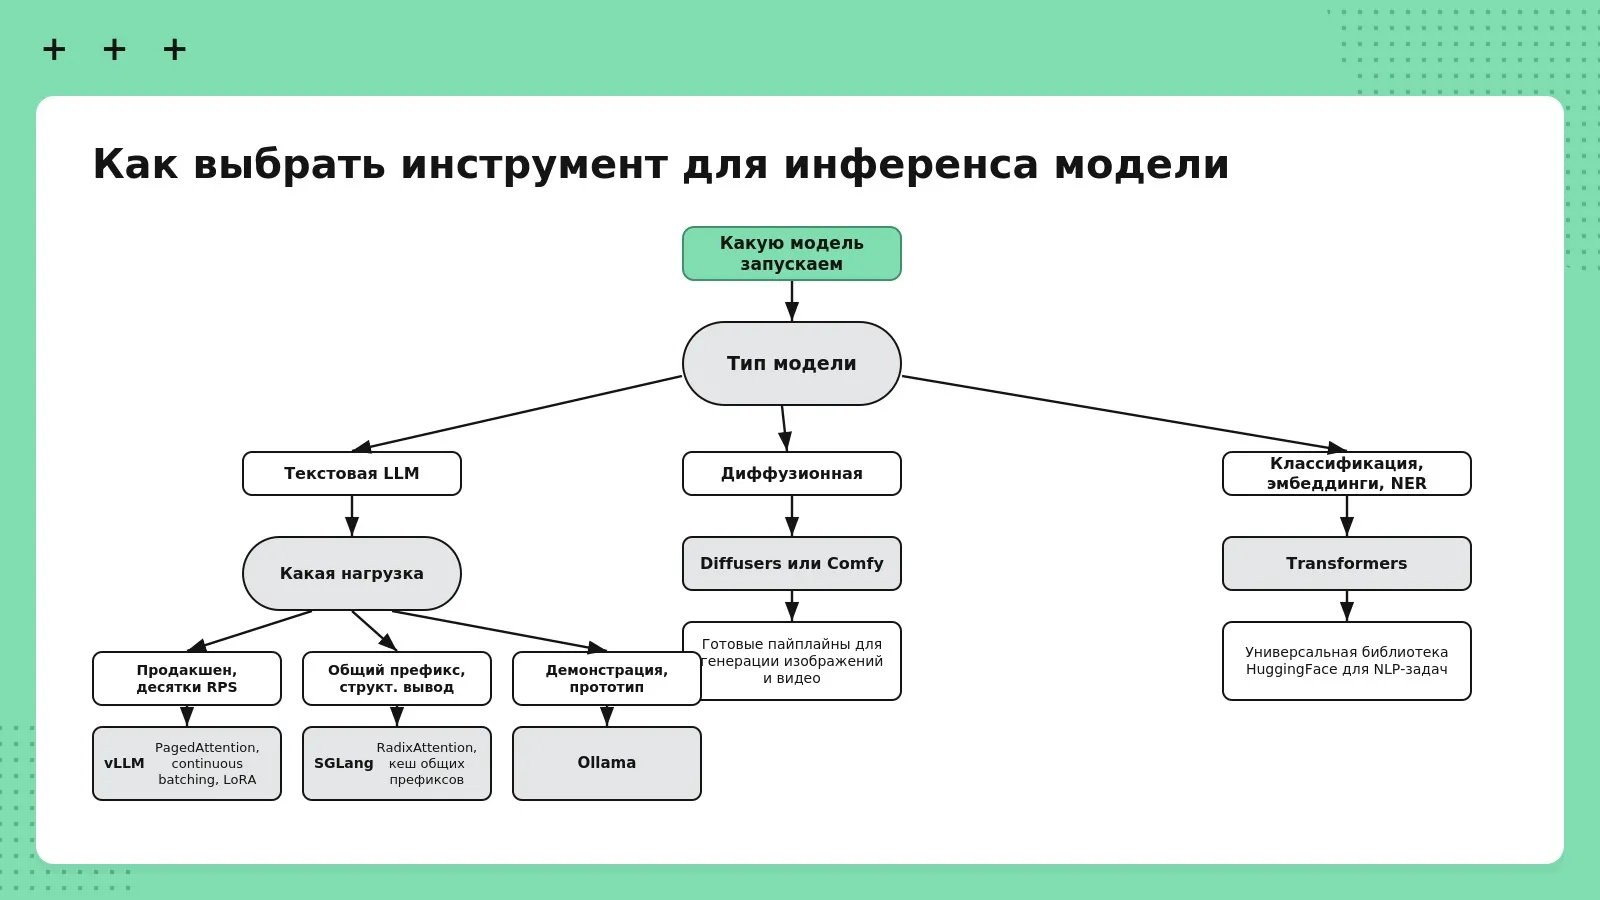 Схема продакшен-инференса
Сколько GPU-памяти нужно модели
Выбор GPU начинается с оценки объема видеопамяти. Для предварительного расчета достаточно умножить количество параметров модели на число байт на один параметр. В FP16 и BF16 это 2 байта, в INT8 — 1 байт, в INT4 — 0,5 байта.
Это только память под веса. В рабочей среде дополнительно нужны память для KV-cache, служебных буферов и самого runtime. Поэтому к базовому расчету можно добавить около 20% как ориентир для предварительной оценки (имейте ввиду, что при реальной нагрузке потребуется дополнительный запас).
Модель | FP16 | INT8 | INT4 | Куда помещается |
7B | около 17 ГБ | около 8 ГБ | около 4 ГБ | V100 32 ГБ с запасом |
13B | около 31 ГБ | около 16 ГБ | около 8 ГБ | V100 впритык, A100 свободно |
32B | около 77 ГБ | около 38 ГБ | около 19 ГБ | A100 или H100 80 ГБ |
70B | около 168 ГБ | около 84 ГБ | около 42 ГБ | 80 ГБ только в INT4, иначе несколько карт |
Отдельно нужно учитывать KV-cache — кеш ключей и значений механизма внимания. Он хранит данные о предыдущих токенах, чтобы модели не приходилось обрабатывать их заново при генерации каждого следующего токена. Поэтому объем KV-cache зависит от длины контекста и числа запросов, которые модель обрабатывает одновременно.
Для оценки памяти KV-cache можно использовать формулу:
2 × число слоев × число KV-голов × размер головы × длина контекста × байт на элемент
Например, для модели уровня 8B с 32 слоями, 8 KV-головами, размером головы 128 и точностью FP16 на один токен требуется около 128 КБ памяти под KV-cache. При контексте в 8000 токенов это около 1 ГБ на один запрос. Если одновременно обрабатывать 10 таких запросов, только на KV-cache потребуется еще около 10 ГБ видеопамяти.
Поэтому того, что веса модели помещаются в видеопамять, недостаточно. При реальной нагрузке GPU должен хранить еще и KV-cache, а также другие рабочие данные. Чем больше одновременных запросов и длиннее их контекст, тем больше видеопамяти потребуется.

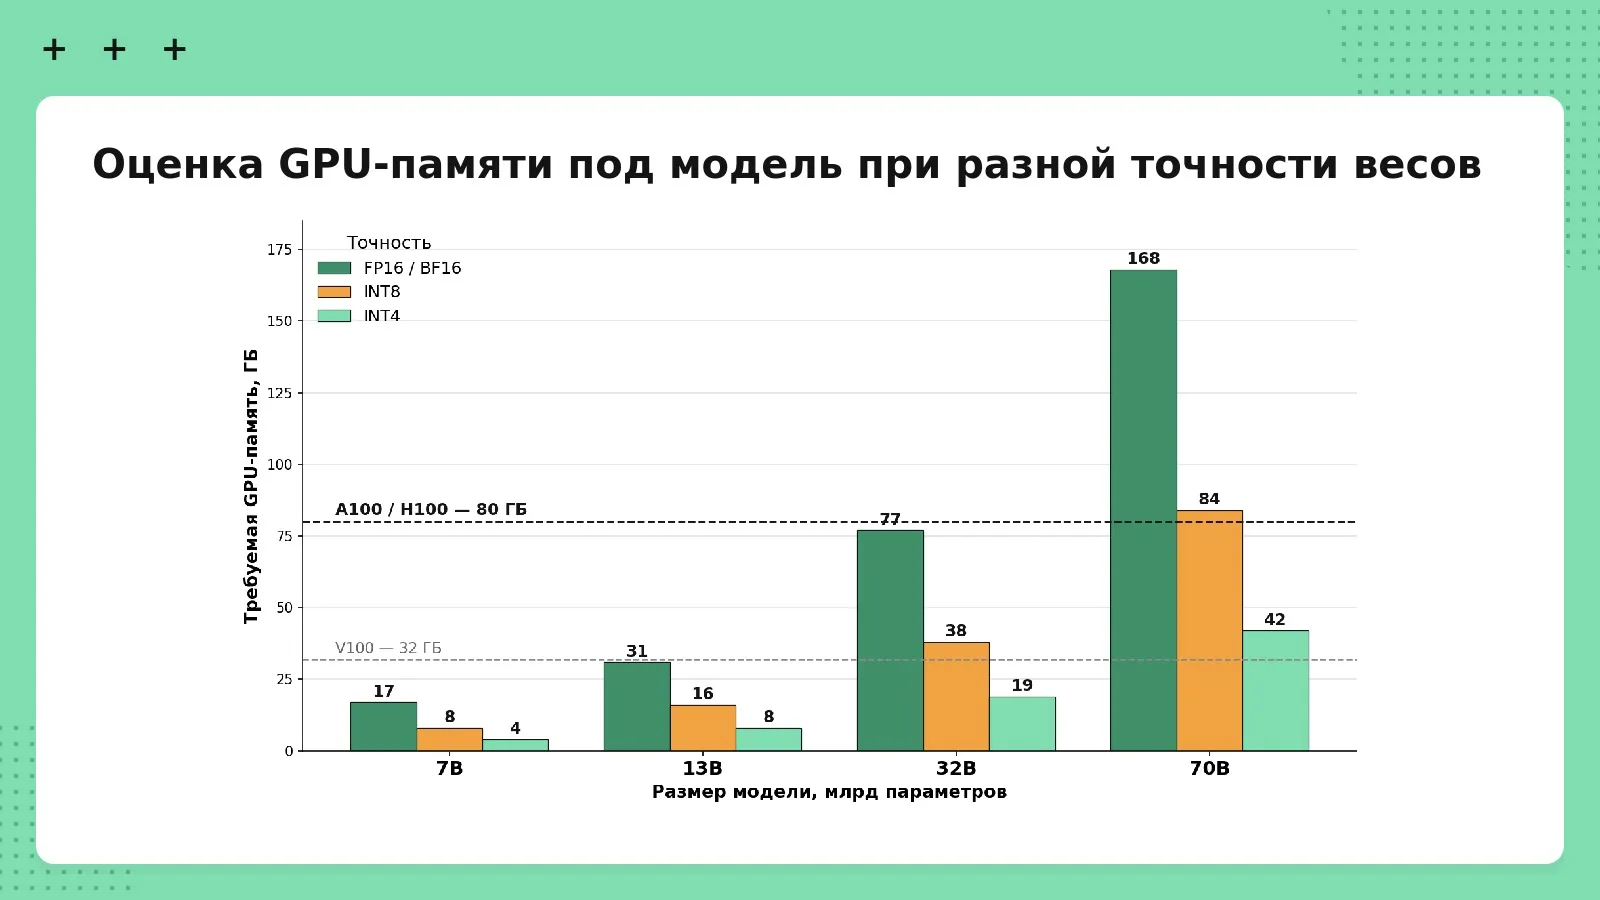 Оценка по формуле: параметры * байт на параметр + 20%, без учета длины контекста
Выбор GPU: V100, A100 и H100
Считать нужно не только память. На стадии генерации токенов инференс упирается не в вычислительную мощность, а в скорость чтения памяти: чтобы выдать один токен, карта прогоняет через себя все веса модели. Поэтому GPU выбирают по двум числам — сколько памяти и как быстро она читается.
В Evolution ML Inference доступны три модели карт.
GPU | Видеопамять | Пропускная способность памяти | Подходит для | Типичный сценарий |
V100 32 ГБ | 32 ГБ HBM2 | около 900 ГБ/с | 7–13B в FP16, до 32B в INT4 | Прототипы и внутренние сервисы |
A100 80 ГБ | 80 ГБ HBM2e | около 2 000 ГБ/с | 32B в FP16, 70B в INT8 | Основная рабочая нагрузка |
H100 80 ГБ | 80 ГБ HBM3 | около 3 350 ГБ/с | 70B и выше, длинный контекст | Высокая нагрузка и жесткий SLA по задержке |
При одинаковом объеме видеопамяти H100 работает быстрее A100 благодаря более высокой пропускной способности памяти: около 3350 ГБ/с против 2000 ГБ/с. Это особенно важно на этапе декодирования, когда инференс активно читает данные из памяти. У H100 пропускная способность примерно в 1,7 раза выше, чем у A100, и в 3,7 раза выше, чем у V100.
На этапе prefill разница между картами может быть меньше, поскольку здесь производительность сильнее зависит от вычислительных ресурсов GPU.
На практике не обязательно сразу выбирать самую мощную карту. Лучше начать с GPU, которого хватает для модели и текущей нагрузки, а затем масштабировать инфраструктуру по мере роста запросов. Это позволяет не платить за неиспользуемый ресурс.
Еще один способ эффективнее использовать GPU — Shared GPU. Он позволяет разделить одну карту между несколькими задачами. Например, если модель 7B занимает 17 ГБ видеопамяти, оставшийся ресурс можно использовать для эмбеддера, реранкера или другой небольшой модели.
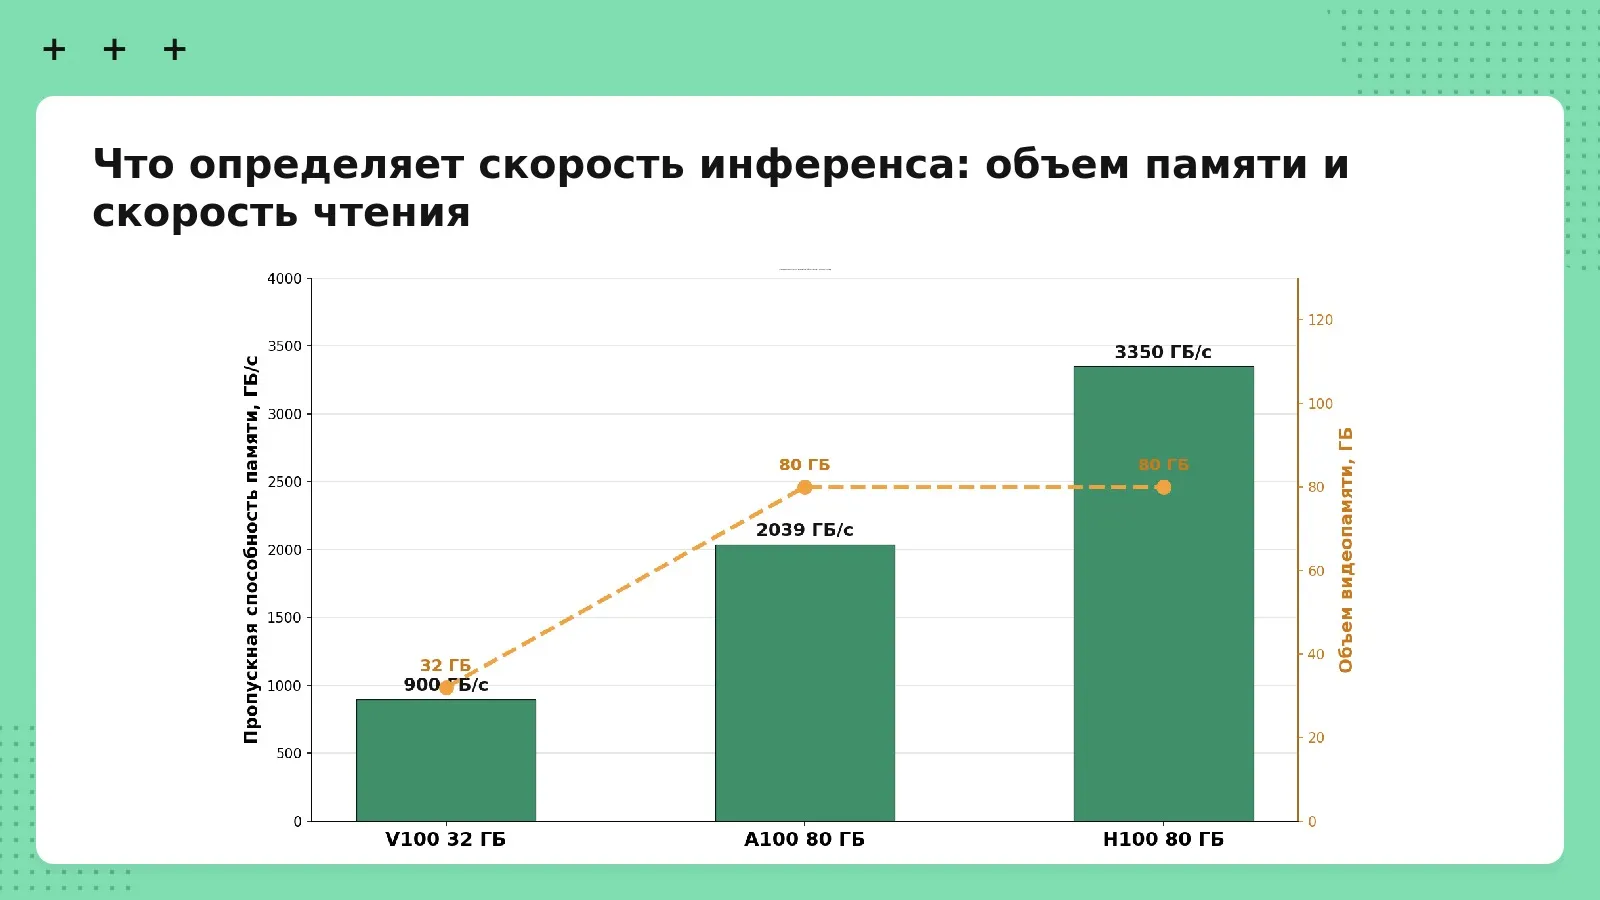 Что определяет скорость инференса
Среды исполнения: vLLM, SGLang и Ollama
Среда исполнения влияет на пропускную способность (throughput) не меньше, чем модель GPU. Разница между наивным запуском через Transformers и специализированным движком измеряется разами, а не процентами.
vLLM — стандарт для нагруженного продакшена. В его основе два механизма:
PagedAttention управляет блоками KV-cache по аналогии с виртуальной памятью операционной системы, поэтому память почти не фрагментируется.
Непрерывная пакетная обработка (continuous batching) добавляет новые запросы в пакет, не дожидаясь, пока завершатся текущие.
Согласно статье авторов PagedAttention, представленной на конференции SOSP в 2023 году, эта связка дает прирост пропускной способности в 2–4 раза при той же задержке по сравнению с FasterTransformer и Orca.
SGLang — второй серьезный движок, который развивается быстрее остальных. Его механизм RadixAttention переиспользует кеш общих префиксов, поэтому движок особенно хорош там, где у запросов совпадает начало: длинный системный промпт, контекст, полученный из внешних источников (Retrieval-Augmented Generation, RAG), набор одинаковых инструкций. Плюс к этому — структурированный вывод, если ответ нужен строго в формате JSON.
Ollama — про быстрый старт. Большая библиотека готовых моделей, запуск одной командой, совместимый с OpenAI API. Для демонстрации и внутреннего прототипа этого достаточно, для нагрузки — нет.
Transformers, Diffusers и Comfy решают другие задачи: единый API к сотням моделей для классификации и эмбеддингов, генерация изображений, сборка пайплайнов.
Стоит упомянуть и про Text Generation Inference (TGI), который до недавнего времени был вторым по популярности движком после vLLM. Hugging Face перевела его в режим поддержки: новые архитектуры моделей и оптимизации в проект не добавляются, а сопровождение сведено к исправлению критических ошибок. В README проекта разработчики рекомендуют переходить на vLLM и SGLang. Если TGI уже стоит в продакшене, он продолжит работать, но поддержки новых архитектур моделей ждать не стоит, поэтому миграцию лучше запланировать заранее.
Среда исполнения | Сильная сторона | Когда выбирать |
vLLM | PagedAttention, continuous batching, LoRA-адаптеры | Нагруженный продакшен с текстовыми моделями |
SGLang | RadixAttention, кеш общих префиксов, структурированный вывод | RAG, длинные системные промпты, ответы в JSON |
Ollama | Простой запуск, большая библиотека моделей | Демонстрации и внутренние прототипы |
Transformers | Единый API к сотням моделей | Классификация, эмбеддинги, распознавание сущностей |
Diffusers, Comfy | Диффузионные модели и пайплайны | Генерация изображений |
TGI | Историческая совместимость | В режиме поддержки, планировать миграцию на vLLM/SGLang |
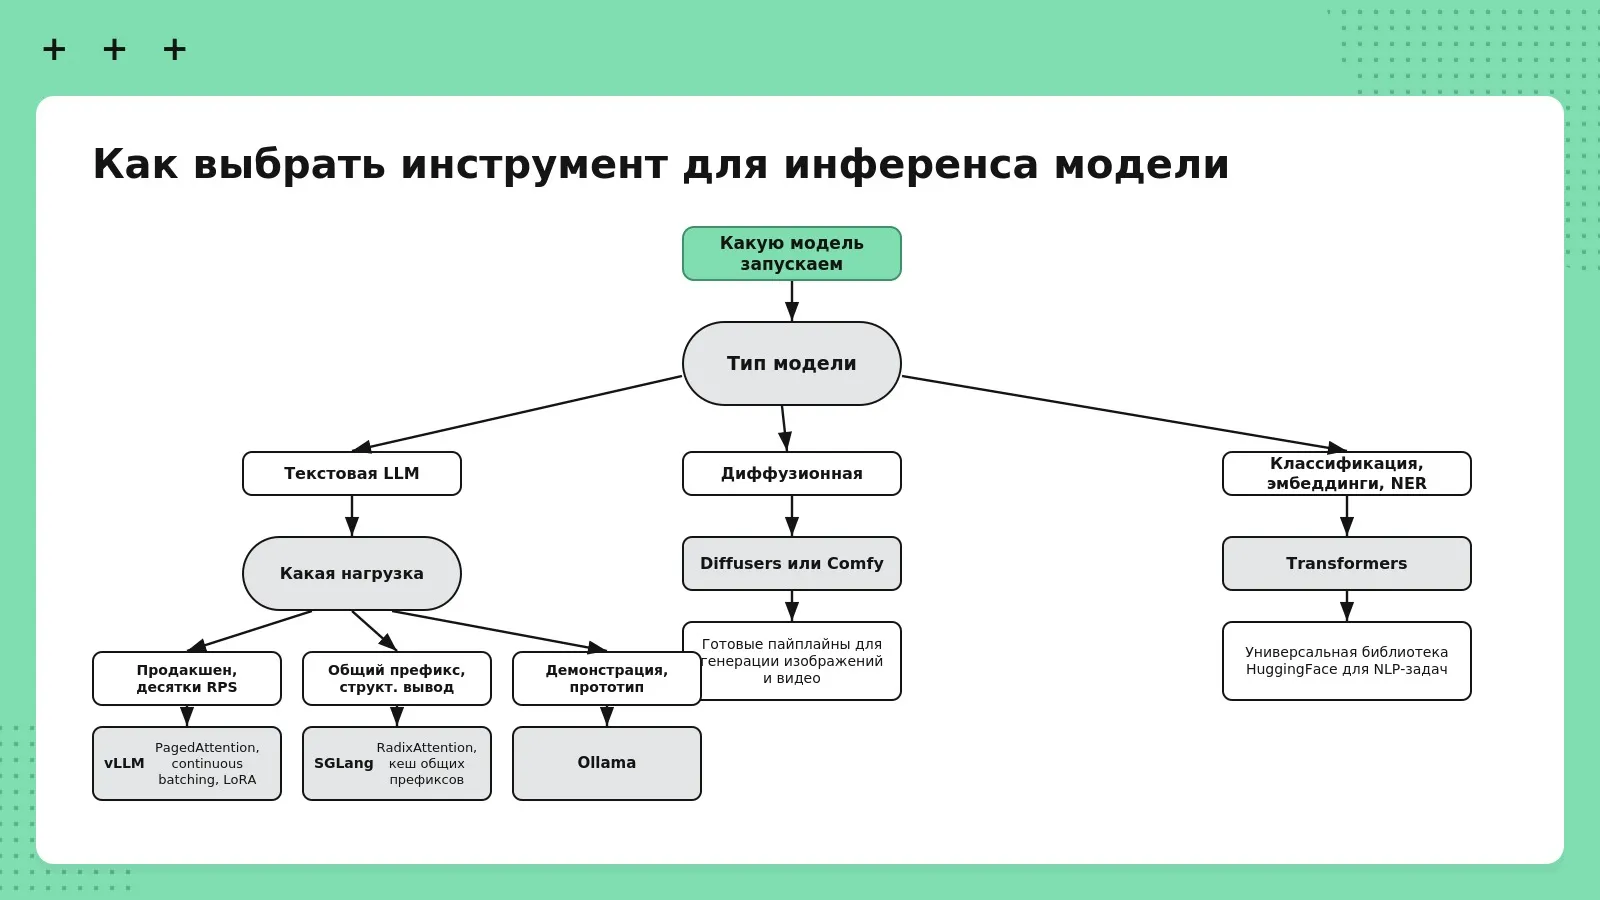 Как выбрать среду исполнения
Как развернуть LLM на Evolution ML Inference
Теперь давайте разберемся, как выглядит последовательность действий при запуске и чем проверить, что эндпоинт отвечает.
Что умеет сервис
Evolution ML Inference — сервис Cloud.ru для запуска ML-моделей на облачных мощностях с GPU. Модель загружается из библиотеки Hugging Face, Ollama или собственного репозитория Model Registry, в том числе в пользовательском Docker-образе. Доступны среды исполнения vLLM, SGLang, Ollama, Transformers, Diffusers и Comfy, а к основной текстовой модели можно подключить до пяти LoRA-адаптеров.
Инфраструктуру сервис берет на себя: драйверы, контейнеры, автомасштабирование и публичный HTTPS-эндпоинт. Также доступны аутентификация по сервисному аккаунту, логирование запросов в выбранную лог-группу, а также межсетевой экран и антивирусная защита платформы Cloud.ru Evolution.
Пошаговый запуск
Набор возможностей понятен, дальше — сама последовательность действий в личном кабинете.
Открыть раздел AI Factory → ML Inference и перейти на вкладку Model RUN.
Нажать «Создать» и при необходимости изменить название инференса, которое подставляется автоматически.
Выбрать Runtime: vLLM для нагруженного текстового сервиса, Ollama для демонстрации, Diffusers для генерации изображений.
Выбрать модель GPU: V100 32 ГБ для моделей 7–13B, A100 или H100 80 ГБ для более крупных.
Указать источник модели — репозиторий Hugging Face, библиотеку Ollama или Model Registry. Токен доступа Hugging Face добавляется через Secret Management.
Указать объем GPU-памяти на экземпляр. Здесь пригодится расчет из раздела про видеопамять.
Задать минимальное и максимальное число экземпляров. Минимум «0» переводит модель в serverless-режим: она отключается при отсутствии запросов и поднимается заново при первом обращении.
Выбрать тип масштабирования — RPS или Concurrency — и задать лимит на экземпляр.
При необходимости включить аутентификацию, логирование запросов и расписание Cron Scheduling.
Нажать «Создать» и дождаться статуса «Запущен». Обычно это занимает несколько минут, после чего у инференса появляется публичный URL.
Как проверить, что все работает
Эндпоинт поднялся, но пока это только строка с адресом. Проверить его можно одной командой, потому что API совместим с OpenAI:
В коде приложения меняется только адрес сервера — остальное остается прежним:
Если ответ пришел, значит инференс в продакшене. Дальше начинается настройка того, сколько он будет стоить.
Автомасштабирование, метрики и экономика
В облаке платят не за модель, а за GPU, поэтому профиль нагрузки важнее прайса. Настроек, которые заметно влияют на счет, всего несколько.
RPS или Concurrency. Первый тип масштабирования считает запросы в секунду на экземпляр и подходит для коротких однотипных ответов. Второй считает одновременно обрабатываемые запросы и точнее описывает генерацию длинных текстов, где один запрос живет десятки секунд.
Ноль экземпляров. Serverless-режим полностью убирает плату за простой, но платой становится холодный старт: первый запрос после паузы ждет, пока веса модели загрузятся в видеопамять. Для внутренних сервисов это приемлемо, для клиентского чата — обычно нет.
Расписание. Cron Scheduling подходит там, где нагрузка предсказуема: например, поднимать экземпляры к началу рабочего дня и опускать вечером.
Sleep Mode в vLLM. Механизм временно выгружает веса модели из видеопамяти в оперативную, освобождая до 90% GPU-памяти, при этом модель просыпается за секунды без полной перезагрузки. Cloud.ru описывает этот и другие способы экономии на инференсе в своем блоге на Хабре.
Проверять результат нужно по метрикам. Смотреть стоит на время до первого токена (Time to first token, TTFT), время генерации одного токена, сквозную задержку по 95-му перцентилю и пропускную способность в токенах в секунду. В ML Inference метрики vLLM экспортируются в формате Prometheus, для них есть готовый дашборд и примеры запросов PromQL в документации.
Метрика | Что показывает | На что влияет |
TTFT | Задержку до первого символа ответа | Ощущение отзывчивости в чате |
Время генерации токена | Скорость выдачи текста | Длительность длинных ответов |
Сквозная задержка p95 | Худший результат из двадцати запросов | Соответствие SLA |
Токенов в секунду | Пропускную способность экземпляра | Стоимость обслуживания запроса |
Глубина очереди | Сколько запросов ждут обработки | Момент, когда пора масштабироваться |
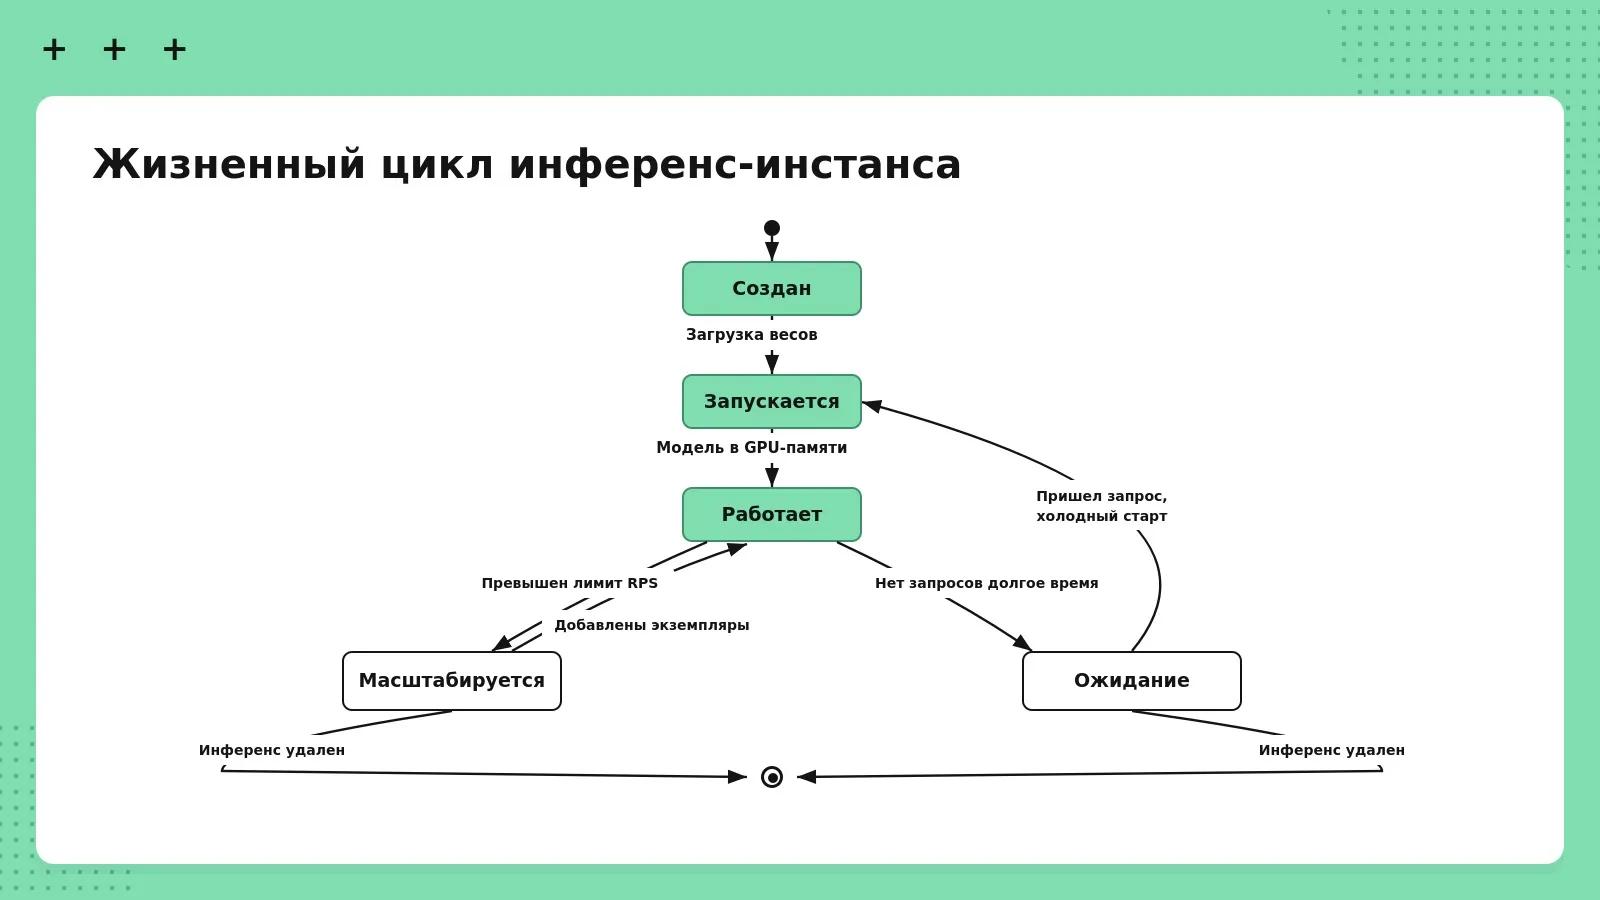 Жизненный цикл экземпляра модели
Evolution Foundation Models или Evolution ML Inference
У Cloud.ru есть два разных сценария работы с языковыми моделями, и выбор между ними определяется одним вопросом: нужна ли собственная или дообученная модель.
Критерий | ||
Модели | Готовый каталог | Любая модель из Hugging Face и собственная |
Дообученные модели | Нет | Да |
Настройка | Минимальная, нужен только API-ключ | Выбор среды исполнения и GPU |
Лимиты | Общие лимиты сервиса | Ограничены выделенным экземпляром |
Когда выбирать | Быстрый старт и проверка гипотез | Продакшен и кастомные модели |
Практический сценарий выглядит так: гипотезу проверяют на Evolution Foundation Models за час, а когда становится понятно, что нужна доменная дообученная модель, переносят ее в ML Inference. Код при этом почти не меняется, потому что оба варианта отдают совместимый с OpenAI эндпоинт.
FAQ
Ниже — короткие ответы на вопросы, которые чаще всего возникают перед первым запуском.
Какой GPU выбрать для запуска LLM?
Что выбрать GPU, важно оценить объем памяти под модель: число параметров, умноженное на число байт на параметр, плюс 20% и запас под KV-cache. Для 7–13B хватит V100 32 ГБ, для 30–70B нужны A100 или H100 80 ГБ. Начинать стоит с менее мощной карты и масштабироваться по мере роста нагрузки.
Можно ли запустить дообученную модель?
Да. Evolution ML Inference запускает любые модели из Hugging Face, в том числе в пользовательских Docker-образах, а к текстовой модели можно подключить до пяти LoRA-адаптеров.
Что такое Shared GPU?
Возможность потреблять ресурс графического ускорителя частично, в пределах его физической памяти. Это позволяет разместить на одной карте несколько небольших моделей и не платить за простаивающую часть видеопамяти.
Какая среда исполнения быстрее?
Для нагруженного продакшена это обычно vLLM за счет PagedAttention и непрерывной пакетной обработки. Если у запросов совпадают длинные префиксы или нужен строгий формат ответа, стоит сравнить с SGLang на своем профиле нагрузки.
В проекте используется TGI, что делать?
TGI переведен в режим поддержки: проект продолжает работать, но новые архитектуры моделей и оптимизации в нем не появляются. Hugging Face рекомендует переходить на vLLM или SGLang — оба движка поддерживаются в Evolution ML Inference, а совместимый с OpenAI API делает миграцию почти незаметной для приложений.