ETL и DWH: как построить хранилище данных для аналитики
Отчеты разных отделов одной компании могут показывать разные цифры по одним и тем же продажам. Финансовый отдел, маркетинг и логистика используют данные из разных систем, по-разному обрабатывают их и считают показатели. Чтобы избежать таких расхождений, компании создают DWH (Data Warehouse) — хранилище, которое объединяет данные из разных источников и приводит их к единому формату для аналитики. Для этого используют процессы ETL и ELT: они помогают собирать, преобразовывать и загружать данные в хранилище.
В статье разберем, как устроено DWH, чем отличаются ETL и ELT и как построить хранилище на управляемых сервисах, не тратя месяцы на настройку инфраструктуры.


Что такое DWH и зачем оно, если есть базы данных
При выборе архитектуры для работы с данными ошибка стоит дорого. Если использовать рабочую базу для тяжелой аналитики, приложение может начать работать медленнее. Если выбрать неподходящий тип хранилища, позже придется переносить терабайты данных и перестраивать архитектуру. Обеих проблем можно избежать, если заранее разобраться, для каких задач нужны базы данных, а для каких — DWH.
Рабочие базы — для транзакций, хранилище — для анализа: почему их нельзя смешивать
Рабочая база интернет-магазина обрабатывает сотни транзакций в секунду: списывает товары со склада, фиксирует оплату и обновляет статусы заказов. Если в этот момент аналитик запускает тяжелый запрос, например для расчета выручки по регионам за полгода, он конкурирует с операциями приложения за вычислительные ресурсы. В результате обработка заказов может замедлиться.
Чтобы избежать этого, используют два класса систем, рассчитанных на разные типы нагрузки:
OLTP (Online Transaction Processing) — системы для обработки транзакций. Они обеспечивают быстрые операции чтения и записи: оформить заказ, провести оплату, обновить остатки на складе. Такие системы оптимизированы для большого количества коротких операций, а не для анализа миллионов строк за один запрос.
OLAP (Online Analytical Processing) — системы для аналитической обработки данных. Они выполняют сложные запросы, агрегируют большие объемы информации и помогают выявлять закономерности. Для этого часто используют DWH, куда данные поступают из рабочих систем. Аналитика выполняется отдельно от основных операций интернет-магазина и не создает дополнительную нагрузку на его рабочую базу.
Разделение снимает конфликт: продакшен-база остается быстрой для клиентов, хранилище — доступным для аналитики без ограничений по времени выполнения запроса. При этом для пользователей и аналитиков ничего не меняется: первые продолжают работать с привычным приложением, вторые получают доступ к тем же данным без риска замедлить продакшен.
DWH, Data Lake, Lakehouse: три подхода к хранению и когда какой нужен
DWH, Data Lake и Lakehouse отличаются тем, как хранят данные, когда определяют их структуру и для каких задач используют. DWH подходит для регулярной отчетности, Data Lake — для хранения данных разных типов и исследовательской аналитики, а Lakehouse объединяет возможности обоих подходов. Разберем, чем они отличаются.
DWH | Data Lake | Lakehouse | |
Схема данных | Заранее определена | Применяется при чтении | Есть, поверх объектного хранилища |
Тип данных | Структурированные | Любые: логи, JSON, медиа | Любые, в открытых форматах |
Лучше всего для | Регулярной отчетности | ML и исследовательской аналитики | Отчетности и ML на одном хранилище |
Для большинства компаний, которые начинают с отчетности, разумной отправной точкой остается DWH: его проще спроектировать и проверить. К Data Lake или Lakehouse имеет смысл переходить позже, когда в компании появляются задачи машинного обучения или источники данных, которые не укладываются в жесткую схему.
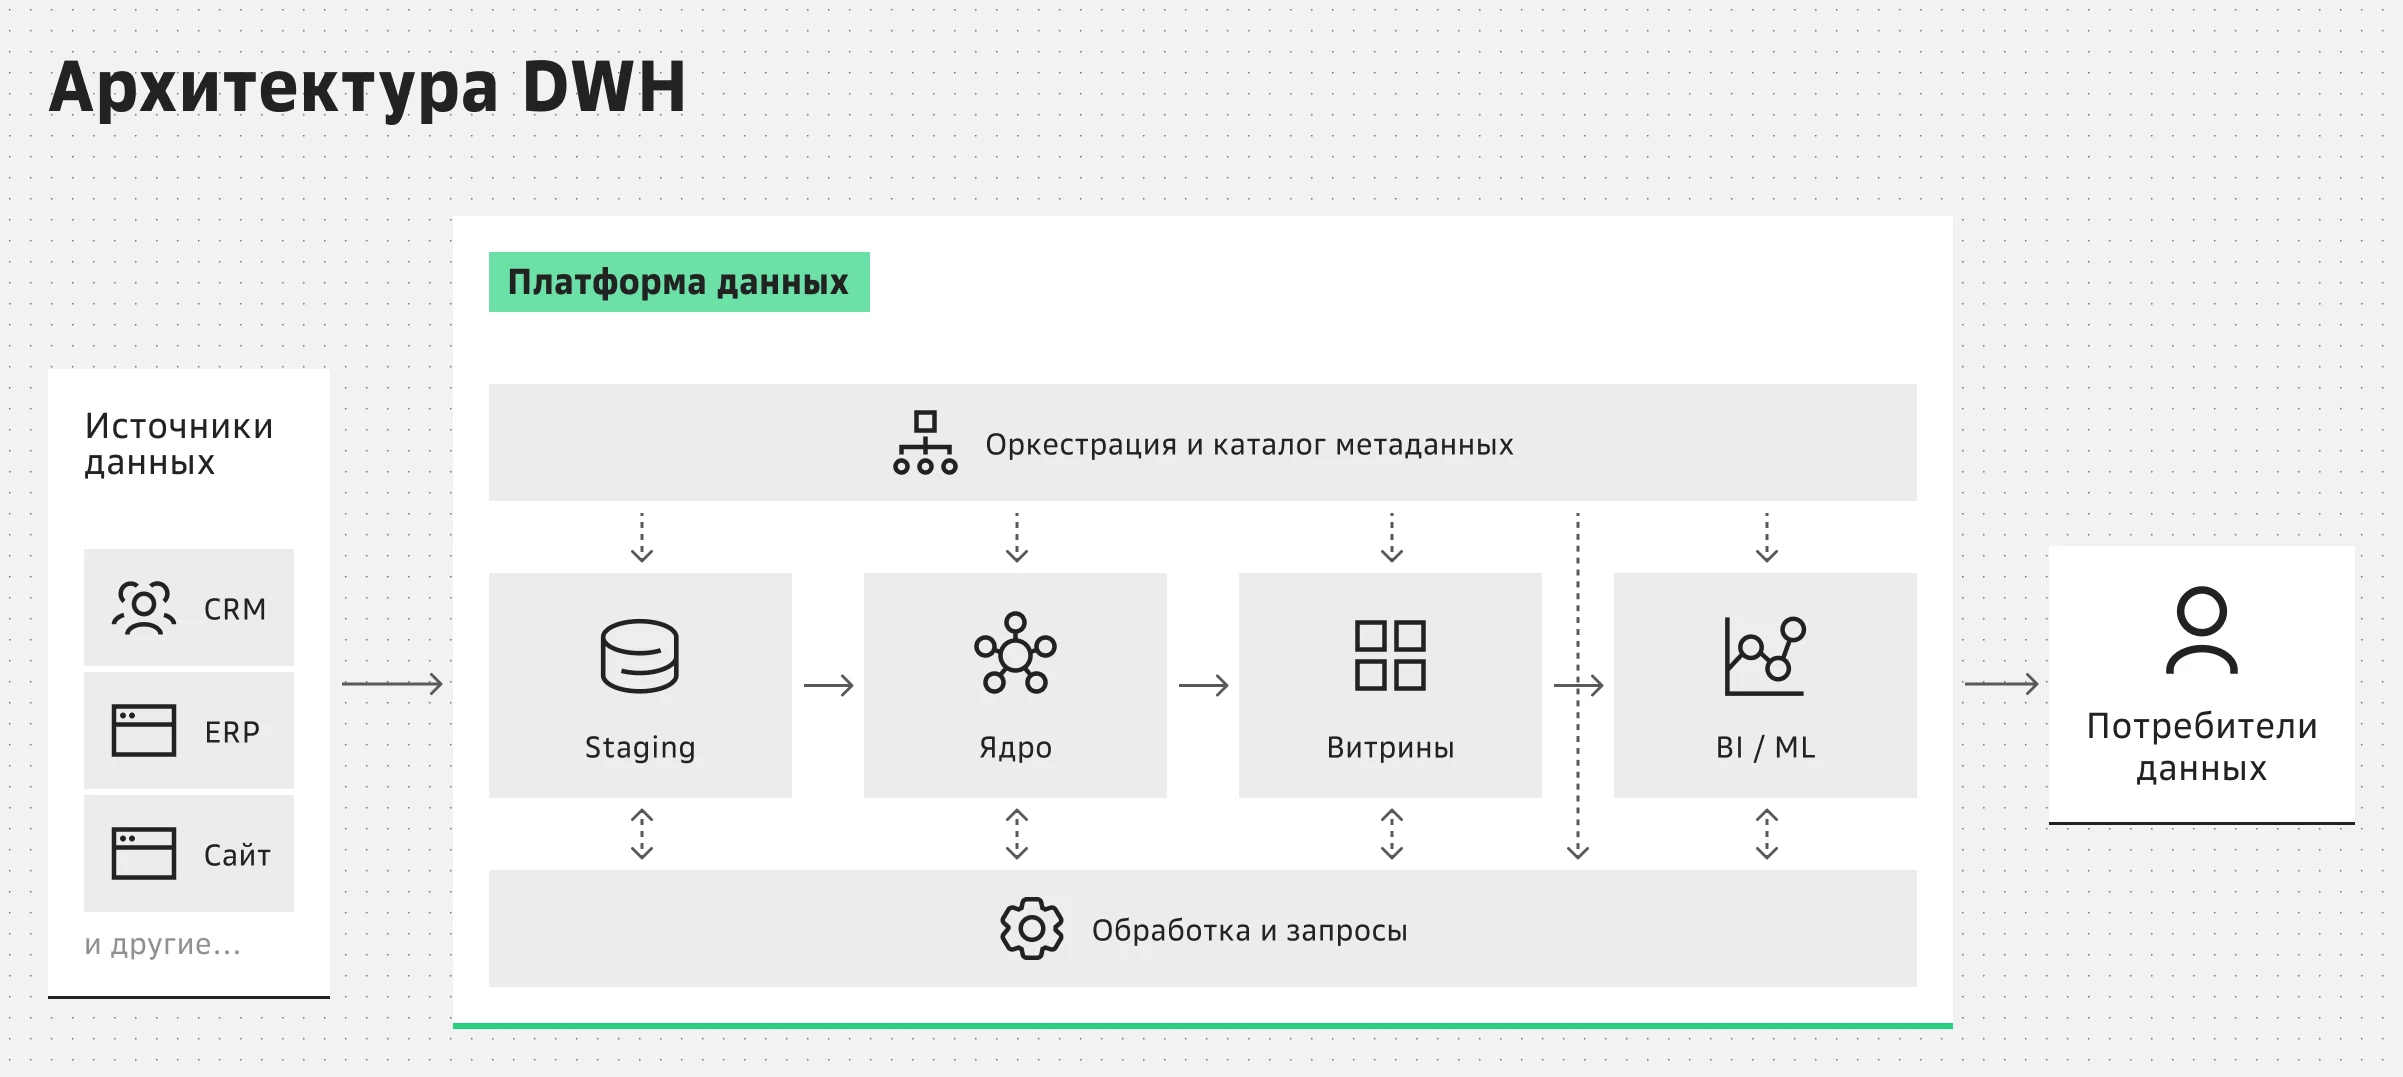 Архитектура Data Warehouse
Архитектура хранилища: слои и модели данных
Архитектура DWH определяет, как данные поступают из источников, проходят обработку и становятся доступными для аналитики. Обычно в ней выделяют несколько слоев, каждый из которых отвечает за свою задачу.
Если не предусмотреть промежуточный слой staging, после сбоя источника может потребоваться повторно загружать всю историю данных. А если модель данных спроектирована только под первые источники, подключение новых может потребовать перестройки существующих таблиц и витрин, от которых зависят отчеты. Поэтому структуру хранилища важно продумать заранее.
Поток: источники → staging → ядро → витрины данных → BI
Система хранилища данных обычно строится из четырех слоев. От этого разделения зависит, где искать проблему, если данные в отчете расходятся.
Staging — данные оказываются почти без изменений; задача слоя зафиксировать, что именно и когда пришло из источника, на случай если загрузку придется повторить.
Ядро (core layer) — данные очищаются, приводятся к единым справочникам и типам: клиент из CRM и клиент из платежной системы получают один и тот же идентификатор.
Витрины данных (data marts) — готовые для использования срезы под конкретные задачи: витрина продаж для коммерческого директора, витрина оттока для команды удержания.
BI — инструменты подключаются к витринам, минуя прямое обращение к ядру; это ограничивает нагрузку и упрощает права доступа.
То есть аналитик отдела продаж не обращается к сырым логам платежной системы. Права на витрины дают аналитикам, права на ядро и staging — только инженерам данных.
Подходы Инмона и Кимбалла, схемы «звезда» и «снежинка», Data Vault — как выбрать модель
Три модели проектирования ядра и витрин решают одну задачу по-разному — насколько сильно нормализовать данные, прежде чем отдать их бизнесу. От выбора зависит, сколько инженерных часов уйдет на запуск первой витрины:
Инмон — сначала создают единую модель данных компании, а уже на ее основе строят отдельные витрины для отчетов и аналитики. Данные организуют в нормализованной форме (обычно 3НФ), чтобы уменьшить дублирование. Такой подход требует тщательного проектирования на старте, но помогает поддерживать единое представление данных в крупной организации.
Кимбалл — сразу проектируют витрины под конкретные аналитические задачи. Основу составляет схема «звезда»: в центре находится таблица фактов, например продаж, а вокруг нее — таблицы измерений, описывающие товары, клиентов и даты. Такая структура упрощает аналитические запросы и делает данные понятнее для бизнеса. Если измерения дополнительно разделяют на связанные таблицы, получается схема «снежинка». Она может уменьшить дублирование, но усложняет запросы, поэтому для большинства витрин предпочтительнее «звезда».
Data Vault — модель, в которой отдельно хранят бизнес-сущности, связи между ними и историю изменений. Например, данные о клиентах находятся в одной структуре, связи клиентов с заказами — в другой, а изменения сведений о клиентах — в третьей. Благодаря такому разделению проще подключать новые источники и сохранять историю, даже если структура исходных систем меняется.
Для пилотного хранилища с одним-двумя источниками схема «звезда» обычно быстрее в реализации, чем полноценный Data Vault. К более сложным моделям стоит переходить, когда число источников и связей между ними растет быстрее, чем команда успевает их поддерживать.
ETL и ELT: как данные попадают в хранилище
Пайплайн, собранный на скорую руку, обычно работает нормально до первого сбоя источника или первого расхождения цифр в отчете, а дальше команда тратит дни на поиск причины вместо часов. Продуманная загрузка данных экономит именно это время: сбои видны сразу, а причина расхождений находится за минуты.
Что выбрать — ETL или ELT
ETL (Extract, Transform, Load) — данные извлекаются из источника, преобразуются во внешнем инструменте и загружаются в хранилище в готовом виде. Подход помогает снизить нагрузку на DWH и очистить или обезличить данные до загрузки.
Когда выбрать ETL: если нужно защитить персональные данные до загрузки, контролировать расходы на вычисления DWH, подготовить данные для операционных систем или преобразовывать их в потоковых пайплайнах.
ELT (Extract, Load, Transform) — сначала данные загружаются в хранилище, а затем преобразуются его средствами. Подход распространен в облачных платформах, таких как Snowflake, BigQuery и Databricks, где вычислительные ресурсы можно масштабировать под нагрузку.
Когда выбрать ELT: когда нужно хранить исходные данные и использовать их для разных аналитических задач.
Критерий | ETL | ELT |
Где выполняется преобразование | Во внешнем инструменте, до загрузки | Внутри хранилища, после загрузки |
Требования к хранилищу | Ниже — хранилище получает готовые данные | Выше — хранилище должно справляться с тяжелыми агрегациями |
Скорость загрузки сырых данных | Медленнее — трансформация блокирует загрузку | Быстрее — сырые данные загружаются сразу |
Гибкость при смене логики отчетности | Ниже — пересчет требует повторного извлечения | Выше — пересчет делается из уже загруженных сырых данных |
Типовые инструменты | Informatica, Talend, классические ETL-серверы | dbt поверх Spark, Trino, колоночных СУБД |
Оркестрация: Airflow, расписания, зависимости, повторные запуски
Пайплайн загрузки данных редко состоит из одного шага: сначала нужно скачать выгрузку из CRM, затем дождаться обновления справочника валют, потом пересчитать витрину продаж. Apache Airflow берет на себя всю эту цепочку:
Описывает шаги как DAG — граф задач с зависимостями, где вторая задача стартует только после успешного завершения первой.
Задает расписание в терминах cron.
При сбое повторяет неудачный шаг заданное число раз, не перезапуская весь пайплайн заново.
Управляемый сервис оркестрации снимает с команды задачу поддержки самого Airflow — обновления, масштабирование воркеров и мониторинг очереди задач ложатся на провайдера, а инженеры данных занимаются только логикой пайплайнов. При самостоятельной поддержке Airflow эти задачи обычно требуют отдельного инженера хотя бы на часть ставки.
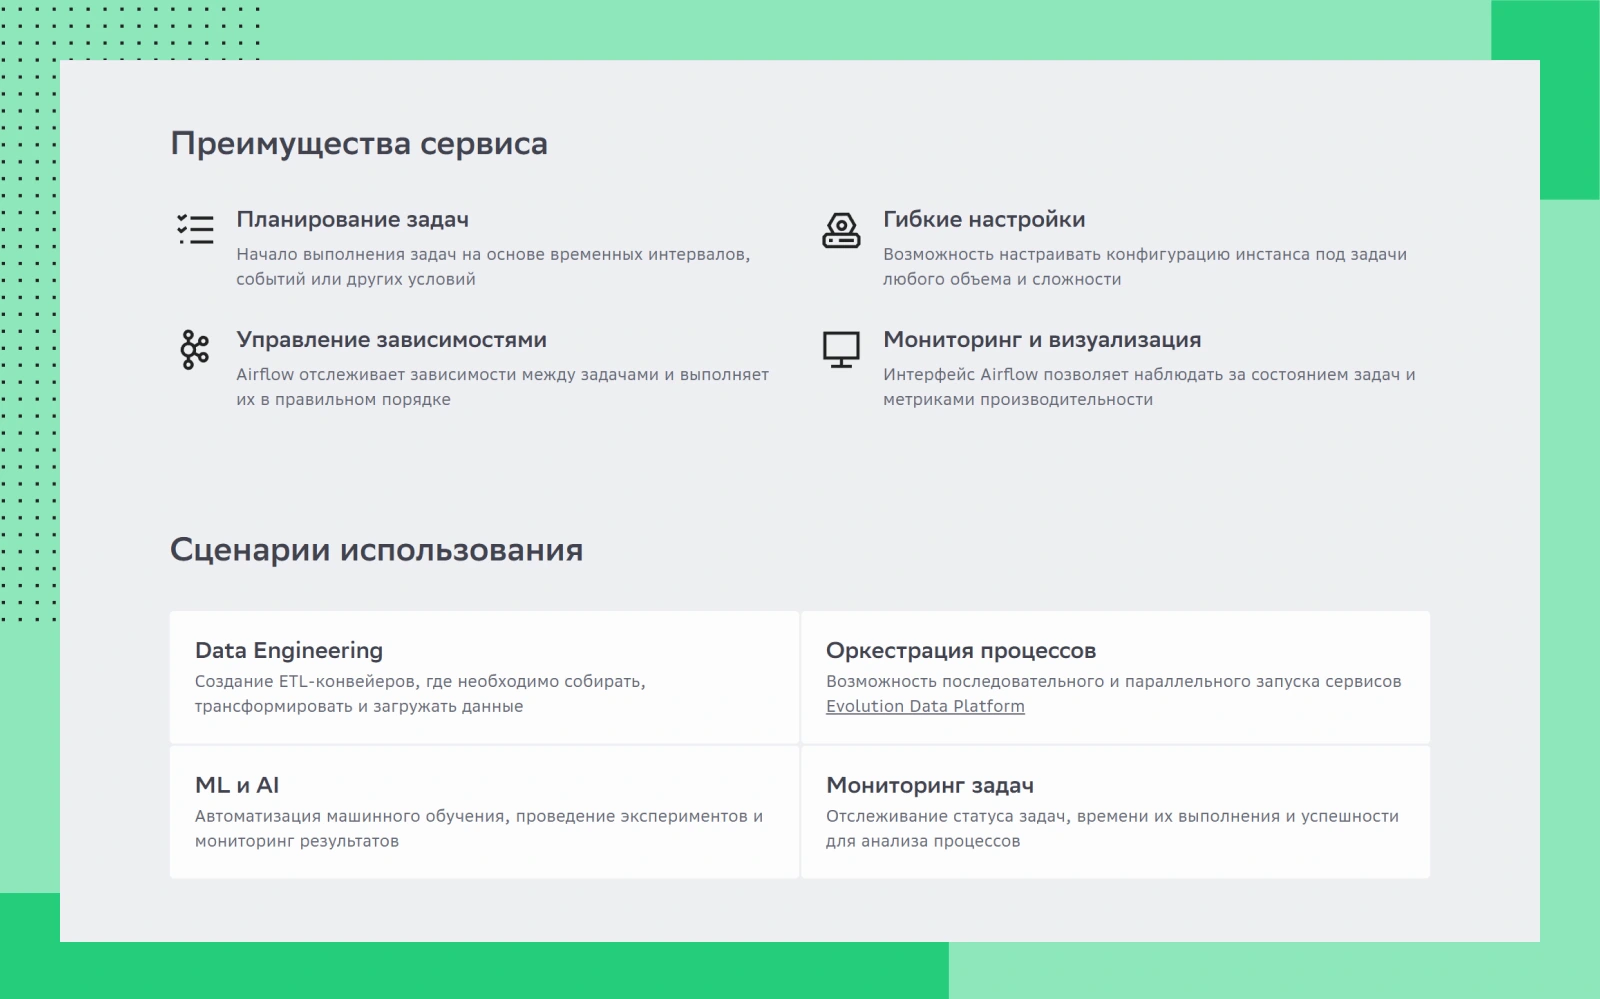 Преимущества сервиса Evolution Managed Airflow
Инкрементальная загрузка, CDC и контроль качества данных
Перезагружать всю таблицу заказов каждую ночь оправдано, пока в ней тысячи строк — с ростом до миллионов полная перезагрузка начинает занимать часы. Три механизма решают это по нарастающей:
Инкрементальная загрузка — пайплайн забирает только новые и измененные записи с момента последней загрузки, ориентируясь на дату обновления или инкрементальный идентификатор.
CDC (Change Data Capture) — читает изменения прямо из журнала транзакций базы-источника, поэтому данные могут попадать в хранилище почти в реальном времени вместо ежесуточной пакетной загрузки. Минимальную задержку дает именно log-based CDC; реализации на триггерах или периодическом опросе таблиц изменений работают медленнее и создают дополнительную нагрузку на источник.
Контроль качества данных — отдельный слой проверок поверх пайплайна: останавливает загрузку и оповещает команду, если в источнике внезапно пропали строки или сумма по витрине разошлась с суммой в источнике на процент выше допустимого.
Инструменты слоя обработки и запросов
Неудачный выбор инструментов на этом слое обычно выражается в одном из двух сценариев: запросы аналитиков выполняются минутами вместо секунд, либо счет за хранение данных растет быстрее самого бизнеса. Продуманная связка вычислений и хранения снимает обе проблемы сразу.
Spark для тяжелых преобразований, Trino для запросов к разным источникам, колоночные СУБД для витрин
Три инструмента закрывают три разных типа нагрузки:
Apache Spark — распределяет вычисления между узлами кластера и справляется с трансформацией, которая не поместилась бы в память одной машины: join таблицы логов на миллиард строк с таблицей клиентов, агрегация за несколько лет истории.
Trino — выполняет SQL-запросы сразу к нескольким источникам (объектному хранилищу, колоночной СУБД, внешней базе) без предварительной загрузки данных в единое хранилище; аналитик получает единую точку входа, даже если данные физически разбросаны по трем разным системам.
ClickHouse — колоночная СУБД, которая хранит значения одного столбца рядом друг с другом, что ускоряет агрегатные запросы вроде «сумма продаж по месяцам» в разы. Аналогичный эффект дает колоночное хранение в MPP-СУБД вроде Greenplum (append-optimized tables), но сама Greenplum — не колоночная, а массивно-параллельная СУБД.
Объектное хранилище S3 как дешевый слой хранения сырых данных
Хранить необработанные выгрузки в дорогой колоночной СУБД экономически не оправдано — сырые данные занимают много места, а обращаются к ним редко, обычно только на этапе пересчета витрин. Объектное хранилище с S3-совместимым API стоит на порядок дешевле блочного хранения и не ограничивает объем заранее: staging-слой и архив исторических выгрузок логично держать именно там.
Формат файла тоже имеет значение: колоночные форматы вроде Parquet хранят данные по столбцам внутри самого файла и поддерживают сжатие, поэтому Spark и Trino читают из них только нужные столбцы, не разбирая файл целиком. ORC решает ту же задачу, но исторически привязан к экосистеме Hive/HDFS и в S3-ориентированных архитектурах встречается реже, чем Parquet.
Витрины и BI: как данные доходят до бизнеса
Хранилище, собранное по всем правилам, все равно может оказаться бесполезным для бизнеса. Данные в нем есть, но добраться до них может только инженер — и финансовый директор неделю ждет отчет вместо того, чтобы открыть цифры сам. Очередь из похожих запросов растет быстрее, чем команда успевает ее разбирать. Ценность архитектуры на этом этапе определяется числом людей, которые получают данные без посредников. Витрины и BI — тот слой, через который бизнес получает то, ради чего строилось все остальное.
Витрины под задачи отделов, SLA на обновление, дашборды и самообслуживание аналитиков
Одна витрина редко закрывает потребности всей компании. Финансовому директору нужна выручка с разбивкой по юрлицам. Маркетингу — стоимость привлечения по каналам. Свести оба расчета в одну широкую таблицу не получится: поля и права доступа для одного отдела мешают другому. Команда данных решает это так:
Проектирует витрины под конкретные роли и фиксирует SLA на их обновление — например, витрина продаж пересчитывается каждый час, а витрина для совета директоров обновляется раз в сутки после закрытия всех источников.
Дает аналитикам самообслуживание через BI-инструмент поверх витрины: вместо запроса к инженеру данных на новый отчет аналитик собирает дашборд сам, перетаскивая уже подготовленные и проверенные поля.
Документирует витрины — без описания полей и логики расчета аналитик рискует посчитать одну и ту же метрику двумя разными способами в двух разных отчетах.
Витрины, собранные в DWH, служат источником данных для обычных отчетов и для предиктивной аналитики — прогноза оттока клиентов или рекомендательных моделей, которые опираются на те же очищенные данные, что и дашборд. Дублировать логику очистки отдельно для ML не нужно: модель и BI-отчет берут данные из одного и того же места.
Сборка DWH на Evolution Data Platform
Сервисы Evolution Data Platform помогают развернуть облачное хранилище данных (DWH) без закупки собственного оборудования. Решение подходит как для аналитики в среднем бизнесе, так и для обработки больших объемов данных.
При самостоятельном развертывании Spark, Trino и Airflow команде нужно обновлять компоненты, масштабировать кластеры и контролировать их работу. Управляемые сервисы позволяют сократить эту нагрузку на инженеров.
Сервис | Слой архитектуры | Что закрывает |
Обработка | Тяжелые ETL- и ELT-трансформации | |
Обработка | Федеративные SQL-запросы к разным источникам без предварительной загрузки в единое хранилище | |
Оркестрация | DAG-пайплайны, расписания, повторные запуски при сбоях | |
Метаданные | Единый каталог схем и таблиц для Spark и Trino | |
Хранение витрин | Аналитическая MPP-СУБД с поддержкой колоночного хранения — под витрины данных | |
Визуализация | Дашборды поверх готовых витрин без настройки коннекторов | |
Хранение (staging) | Дешевый S3-совместимый слой для сырых данных и архива | |
Потоковые данные | Загрузка событий и логов почти в реальном времени |
Все сервисы работают в единой экосистеме, что упрощает масштабирование: под пиковую нагрузку кластер добавляет ресурсы автоматически, без отдельной заявки в поддержку. Сервисы запускаются через консоль, а оплата рассчитывается по фактическому использованию ресурсов — команда не платит за простаивающий кластер в период низкой нагрузки.
Интеграция с AI Factory для ML-сценариев; сервисы аналитики и управления данными прошли оценку по ГОСТ Р 57580
AI Factory подключается к витринам напрямую, поэтому команде не нужно строить отдельный пайплайн подготовки данных для ML в обход уже существующего хранилища. Управление хранилищами данных в регулируемых отраслях — банках, страховых, финансовых организациях — требует отдельной оценки по ГОСТ Р 57580: сервисы аналитики и управления данными на платформе прошли эту оценку, что снимает часть вопросов на этапе согласования архитектуры с безопасностью.
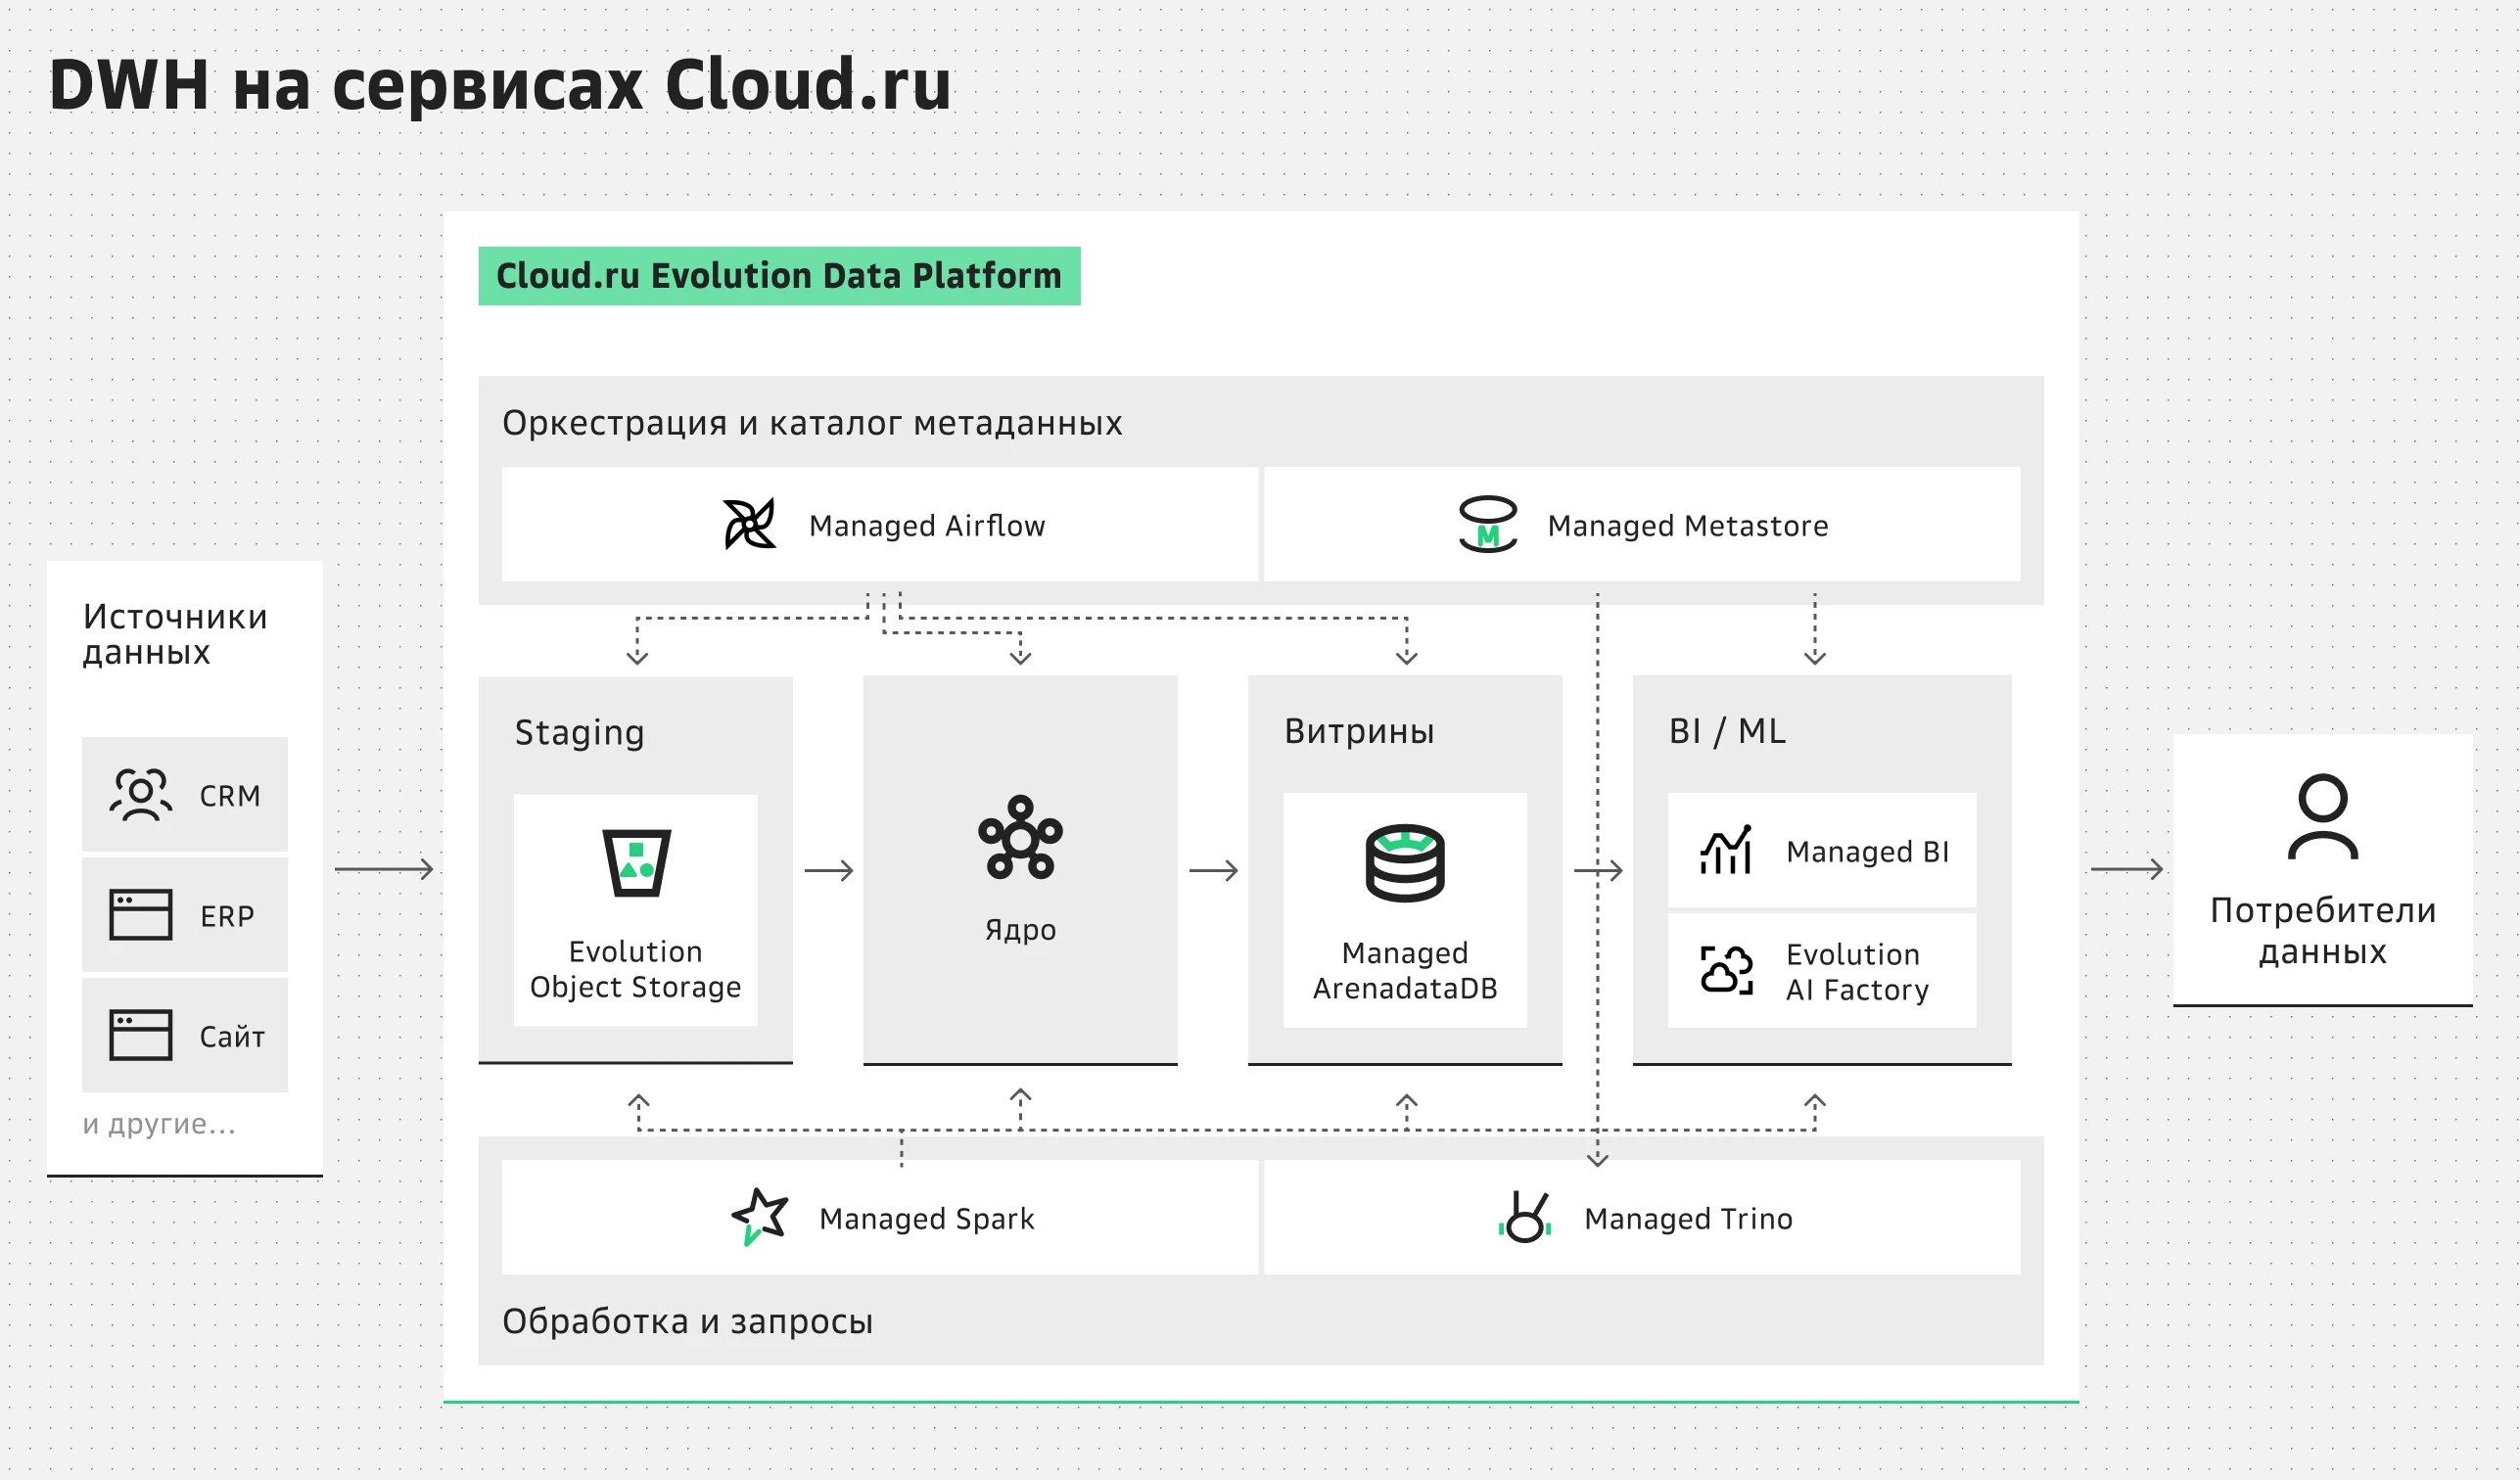 Data Warehouse на сервисах Cloud.ru
План запуска: пилотное хранилище за месяц
Начинать построение DWH сразу со всех источников компании — типичная ошибка, которая растягивает первый релиз на полгода и не дает команде обратной связи от бизнеса. По неделям пилот выглядит так:
Неделя 1 — выбор одного бизнес-домена с понятной метрикой успеха. Чаще всего это продажи или маркетинг, где выгода от единой витрины видна сразу.
Неделя 2–3 — технический слой: подключение одного-двух источников через ELT-пайплайн, настройка оркестрации в Airflow и модель витрины по схеме «звезда».
Неделя 4 — подключение BI поверх готовой витрины и проверка цифр вместе с отделом, для которого она строилась. Расхождение с текущими ручными отчетами на этом этапе выявляется быстрее, чем через месяц эксплуатации.
Второй домен после первого успешного цикла обычно подключается быстрее первого: команда уже прошла настройку пайплайна и оркестрации один раз и повторяет тот же путь для новой задачи. Часть решений — модель «звезда», структура staging, правила инкрементальной загрузки — переносится на новый домен почти без изменений.
Заключение
DWH не ограничивается хранением данных. Это система, в которой нужно организовать загрузку и обработку данных, настроить витрины для разных задач и поддерживать работу всех компонентов.
Чтобы проверить архитектуру до масштабирования, начните с пилота: выберите один источник данных, конкретную задачу и команду, которая будет использовать результат. Так вы сможете оценить выбранную модель и выявить проблемы до того, как они повлияют на весь проект.
FAQ
Что такое DWH простыми словами?
DWH — это хранилище данных, куда информация из разных систем компании попадает в едином формате и используется для отчетности и аналитики компании.
Чем ETL отличается от ELT?
В ETL данные преобразуются до загрузки в хранилище, во внешнем инструменте. В ELT сырые данные сначала загружаются, а преобразование выполняется уже внутри хранилища средствами самого DWH.
Чем DWH отличается от Data Lake?
DWH хранит данные в заранее заданной схеме и подходит для регулярной отчетности. Data Lake хранит данные в исходном виде без строгой схемы и лучше подходит для машинного обучения и исследовательской аналитики.
Что такое витрина данных?
Витрина данных — это готовый для использования срез хранилища под конкретную задачу отдела, например продажи по регионам или отток клиентов, к которому подключается BI-инструмент.
Какие инструменты нужны для построения DWH?
Понадобится оркестратор пайплайнов (Airflow), инструмент обработки данных (Spark, Trino), аналитическая СУБД для витрин и объектное хранилище для сырых данных на этапе staging.
Сколько времени занимает построение хранилища данных?
Пилотное хранилище с одним бизнес-доменом и парой витрин на управляемых сервисах можно собрать за месяц. Полноценное хранилище со всеми источниками компании строится поэтапно, по мере подключения новых доменов.
Можно ли построить DWH без своей инфраструктуры?
Да, управляемые сервисы вроде Evolution Data Platform закрывают слой обработки, оркестрации и хранения без необходимости разворачивать и поддерживать кластеры вручную.