Эмбеддинги простыми словами: что это и как нейросеть превращает текст в векторы
В корпоративных базах могут храниться тысячи документов, но найти нужный не всегда просто. Поиск по ключевым словам не учитывает смысл запроса: пользователь может описать задачу одними словами, а в документе нужная информация будет сформулирована иначе.
Решить эту проблему помогает семантический поиск. Он позволяет находить документы не только по совпадению слов, но и по смыслу. Для этого тексты преобразуют в числовые векторы — эмбеддинги — и хранят их в векторной базе данных. Разберемся, что такое эмбеддинги, как нейросети превращают текст в векторы и как это работает на практике.


Что такое эмбеддинг в нейронных сетях ИИ простыми словами
Эмбеддинг — это набор чисел (вектор), которым нейросеть описывает смысл слова, фразы или документа. Близкие по смыслу тексты получают близкие векторы, поэтому их легко найти, даже если пользователи по-разному формируют запросы.
Например, пользователь хочет найти документы об оптимизации затрат на ИТ-инфраструктуру. Он может спросить «как снизить расходы на серверы» или «как эффективнее использовать серверные мощности». Система обнаружит смысловую связь и в обоих случаях предложит подходящие документы.
Именно эмбеддинги лежат в основе семантического поиска, рекомендаций и подхода RAG (Retrieval-Augmented Generation), когда нейросеть обогащает сгенерированный ответ данными из внешних источников.
Аналогия с координатами на карте
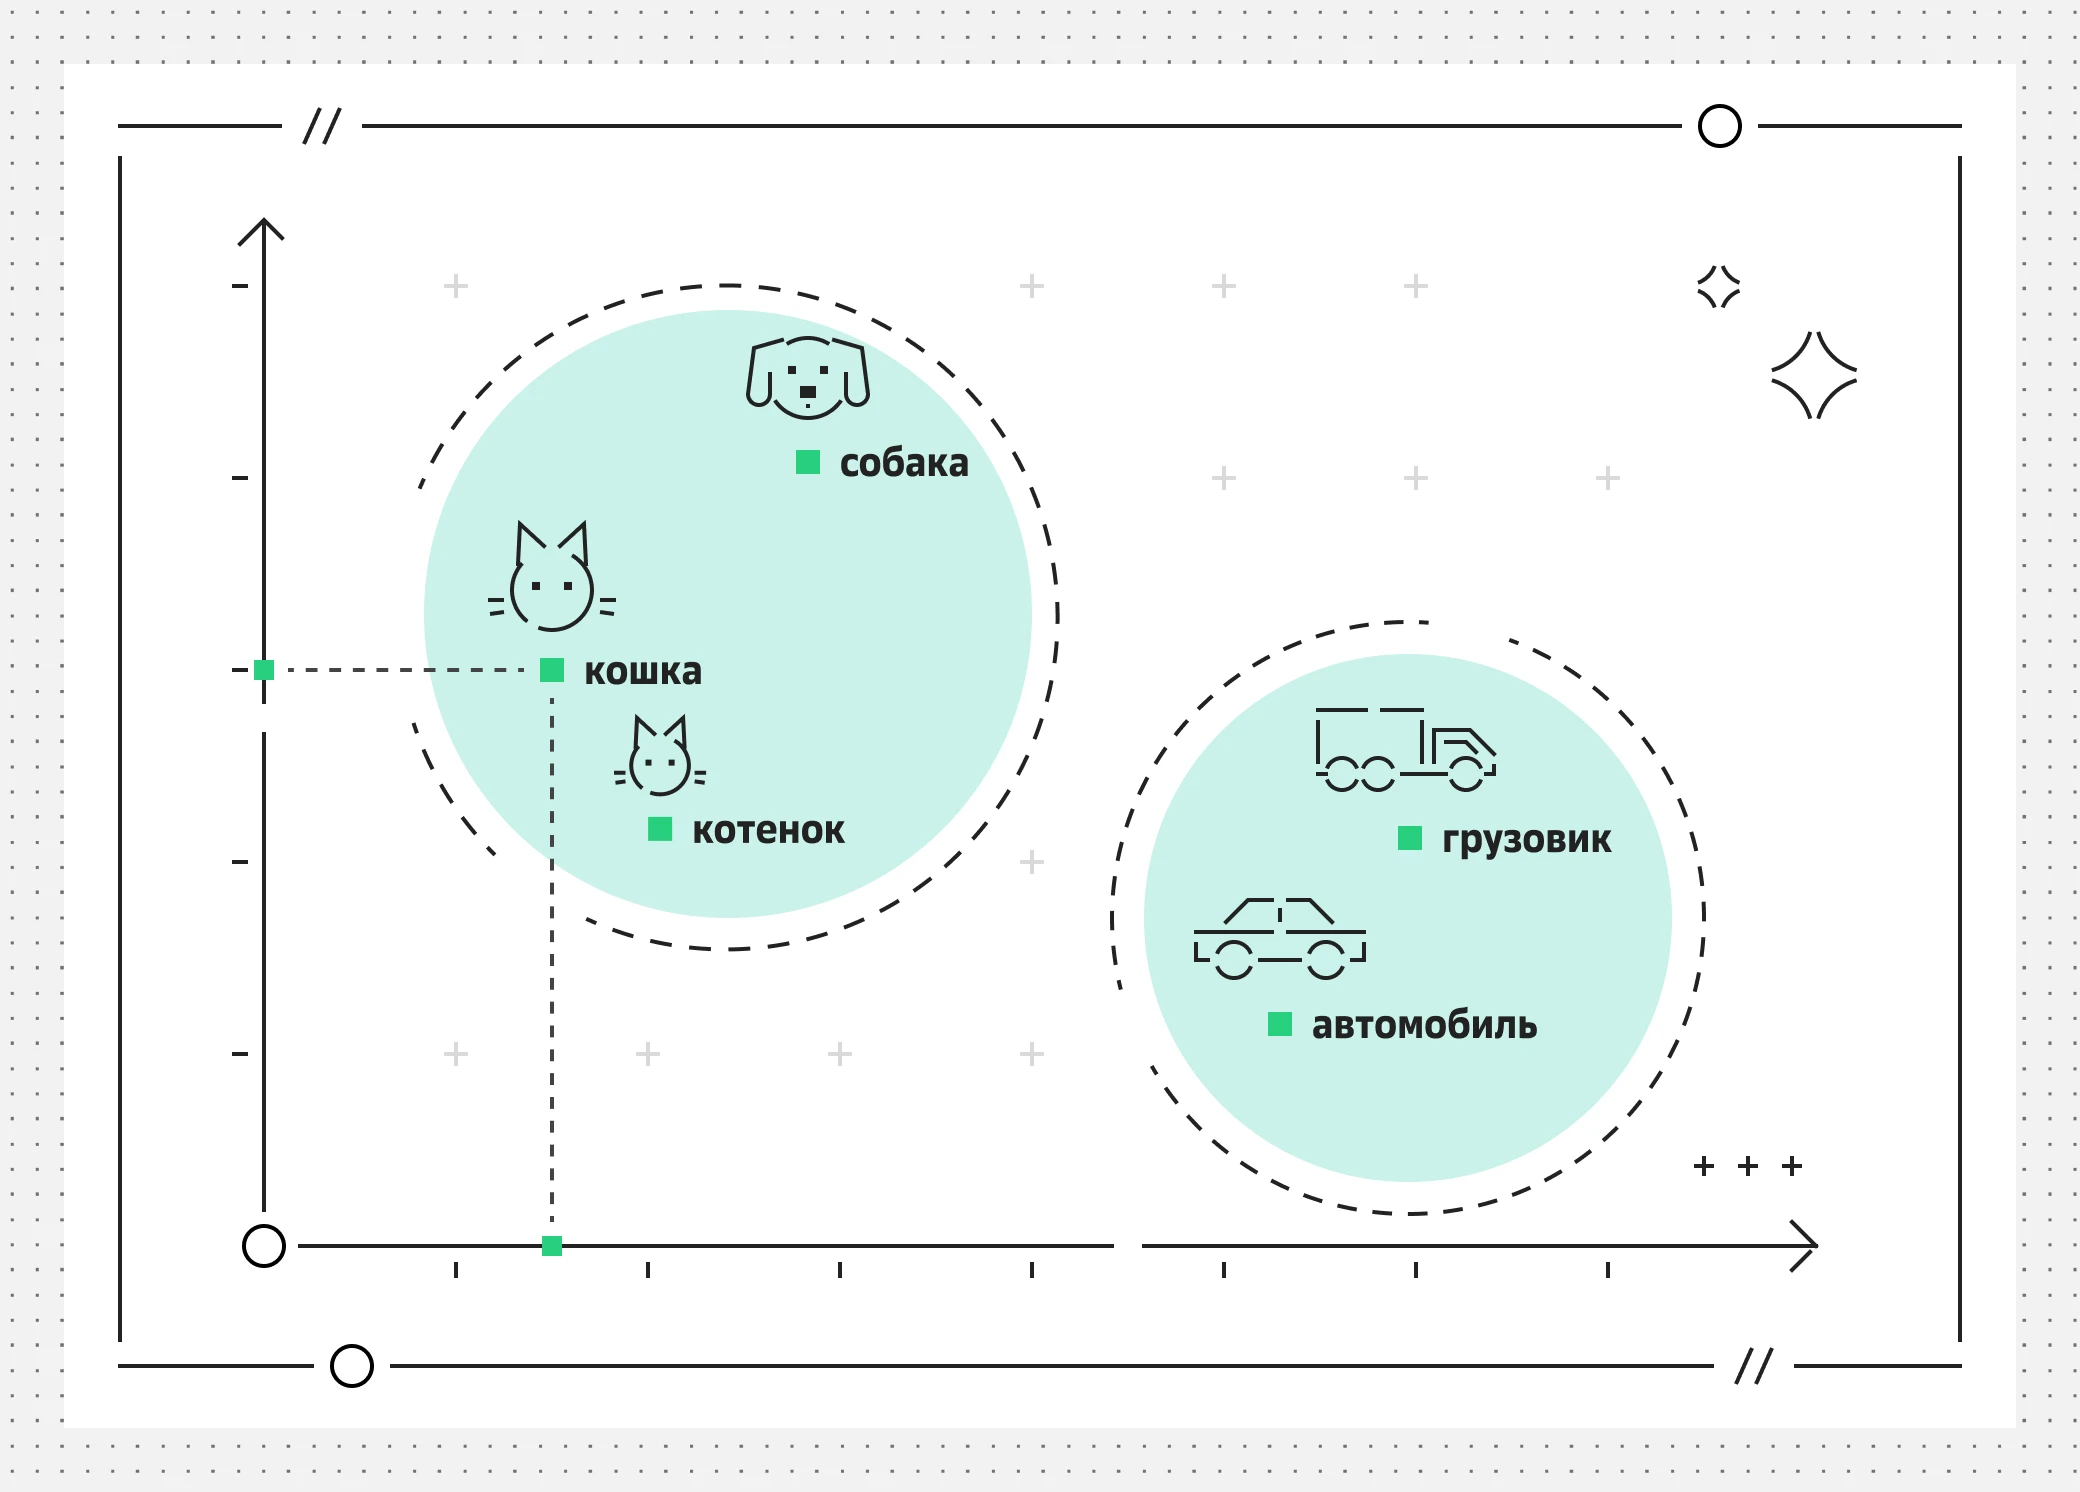
Чтобы разобраться, как работают эмбеддинги, представим географическую карту. У каждого объекта на ней есть координаты: широта и долгота. По ним можно определить, где находится город и как далеко он расположен от другого города.
Примерно так же устроены эмбеддинги, только вместо положения на карте они показывают смысл текста. Нейросеть преобразует текст в набор чисел — вектор. Чем ближе значения векторов друг к другу в многомерном пространстве, тем больше общего в смысле у соответствующих текстов.
Например, документы о покупке автомобиля и приобретении машины могут содержать разные слова, но иметь близкие векторы. Поэтому при поиске нейросеть сможет найти оба документа, даже если запрос пользователя не совпадает с формулировками в тексте.
Эмбеддинг слова, предложения и документа
Эмбеддинги можно создать для текстов разного размера. Примеры:
Эмбеддинг слова — числовое представление отдельного слова. Например, слова «врач» и «доктор» означают одно и то же, поэтому будут иметь близкие векторы.
Эмбеддинг предложения — вектор, отражающий смысл фразы. Например, запросы «как снизить расходы на серверы?» и «как сократить затраты на ИТ-инфраструктуру?» по-разному сформулированы, но одинаковы по смыслу.
Эмбеддинг документа — числовое представление отчета, инструкции, статьи. Оно помогает находить материалы по схожим темам. Однако большие документы с многообразным содержанием часто разбивают на фрагменты с отдельными эмбеддингами, чтобы было проще искать нужную информацию.

Формат эмбеддингов зависит от задач. Векторы слов используются для сопоставления отдельных понятий, предложений — для поиска похожих запросов, документов — для легкого ориентирования в обширных темах.
 Двумерная «карта смыслов»
Как нейросеть создает эмбеддинги
Для преобразования текста в числовые векторы нейросеть сначала разбивает его на части (токены), затем обрабатывает с помощью математической модели и пропускает через свои слои.
От токенов к векторам
Чтобы дать векторное представление текста, модель разбивает отдельные слова или фразы на токены и ищет для них сопоставимые базовые идентификаторы. На следующем этапе математическая модель обрабатывает числовые представления и формирует эмбеддинги.
Но откуда нейросеть знает, какие числа присвоить каждому тексту? Она не берет их случайным образом и не использует готовый справочник значений. Во время обучения модель анализирует большие объемы текстов, учится находить связи между словами, учитывать контекст и улавливать смысловые закономерности. На их основе она формирует векторы.
В результате тексты со схожим смыслом оказываются ближе друг к другу в многомерном пространстве. При поиске система сравнивает векторы с помощью математических методов и находит материалы, которые лучше всего соответствуют запросу, даже если в них используются другие слова.
Word2vec: первые эмбеддинги слов
Word2vec — алгоритм создания эмбеддингов, предложенный исследовательской группой Google под руководством Томаша Миколова в 2013 году. Он позволяет представлять слова в виде векторов, учитывая похожие контексты. Например, в текстах слова «сервер» и «компьютер» могут встречаться рядом с «оборудование» и «процессор». Алгоритм анализирует такие закономерности, связывает их и отражает эти связи в векторах.
Word2vec обучается по одному из двух механизмов:
CBOW (Continuous Bag of Words) — пытается угадать пропущенное в тексте слово по контексту. Например, есть фраза «сервер хранит ___ и обрабатывает запросы». Нейросеть предскажет слово «данные».
Skip-gram — решает обратную задачу, пытаясь по одному слову угадать соседние. Например, есть «сервер». Алгоритм предсказывает слова «компьютер», «оборудование», «данные» и т.д.
У метода есть серьезное ограничение — у слова будет один и тот же вектор независимо от контекста. Например, слово «ключ» как инструмент и «ключ» как источник воды будут в числовом значении представлены одинаково. Чтобы обойти это ограничение, сейчас используют контекстные модели, в частности, трансформеры.
Трансформеры: эмбеддинги с учетом контекста
Трансформеры (например, BERT, bge-m3, Qwen3-Embedding, Giga-Embeddings) создают динамические эмбеддинги, где цифровое представление слов может меняться в зависимости от контекста.
Один из ключевых механизмов — принцип внимания (Attention), который позволяет модели учитывать связи слов в разных предложениях и определять контекст. Например, возьмем фразы «слесарь взял ключ и открыл дверь» и «из-под земли бил ключ с чистой водой». Здесь есть общее слово в разных значениях. Трансформер проанализирует окружение и правильно определит контекст каждой фразы. В результате слово «ключ» получит разные векторы согласно значению. В этом и есть главное отличие от Word2vec, где вектор будет один.
Как сравнивают эмбеддинги
Чтобы обнаруживать близкие по смыслу тексты, алгоритмы сравнивают векторы с помощью разных математических методов.
Косинусное сходство на простом примере
Косинусное сходство показывает близость направлений двух векторов в векторном пространстве. Значение лежит в диапазоне от -1 до 1:
1 — угол 0°, векторы смотрят в одну сторону. Это означает полное сходство.
0 — угол 90°, векторы направлены перпендикулярно. Между объектами нет сходства.
-1 — угол 180°, векторы смотрят в разные стороны. Объекты противоположны.
Можно вычислить сходство с помощью формулы. Сравним два запроса: «аренда сервера» и «стоимость аренды сервера». В первом случае нейросеть дает вектор [2, 1] (много хостинга, мало денег), во втором — [2, 4] (много хостинга, много денег).
Алгоритм сначала перемножает свойства:
(2х2) + (1х4) = 4+4 = 8
Потом ищет знаменатель, перемножая длины векторов. Длина первого — √5, второго — √20. Получается:
√5 × √20 = √100 = 10
Затем делит верх на низ:
8/10 = 0,8
Получается значение, близкое к единице, а значит, сходство между фразами высокое, несмотря на то, что в запросе про аренду не было ничего про стоимость. Благодаря косинусному сходству нейросеть может выдать прайс-листы и страницы с тарифами.
Другой способ сравнения — евклидово расстояние. С его помощью измеряется расстояние между концами векторов. Чем оно меньше, тем ближе векторы друг к другу. Чтобы было проще измерять, алгоритм использует нормализацию — приводит векторы к одной длине.
Размерность вектора: на что она влияет
Размерность — это количество чисел в векторе. Чем она выше, тем больше вычислительных ресурсов нужно для работы с векторами.
Большая размерность не гарантирует точного поиска. Все зависит от используемой модели и типа данных, на которых она была обучена. Оптимальную размерность определяют на практике путем сравнения качества поиска на тестовых запросах. Также нужно оценить затраты на хранение и обработку векторов.
Где применяют векторные эмбеддинги
Векторное представление текста помогает искать нужную информацию по смыслу, генерировать ответы, автоматически обрабатывать документы. Оно используется в разных сценариях, например:
RAG (Retrieval-Augmented Generation, генерация, дополненная поиском) — поиск релевантных фрагментов документов и передача их LLM для создания более точных ответов.
Семантический поиск — обнаружение запрашиваемых документов по смыслу запроса, даже если в тексте отличаются формулировки.
Рекомендательные системы — подбор товаров, контента, статей и других материалов под запросы пользователей или на основе пользовательского опыта.
Кластеризация текстов — объедение документов, сообщений, писем, отзывов в группы по близкому смыслу.
Поиск дубликатов — выявление одинаковых или похожих по смыслу текстов.
Классификация обращений — распределение пользовательских сообщений по категориям, например, технические проблемы, доставка, оплата, жалобы и т.д.
В зависимости от задач, требований к точности поиска и объема данных можно выбрать подходящую embedding model и настроить способ сравнения векторов.
Если вы только внедряете модель, убедитесь, что она справляется с реальными запросами.
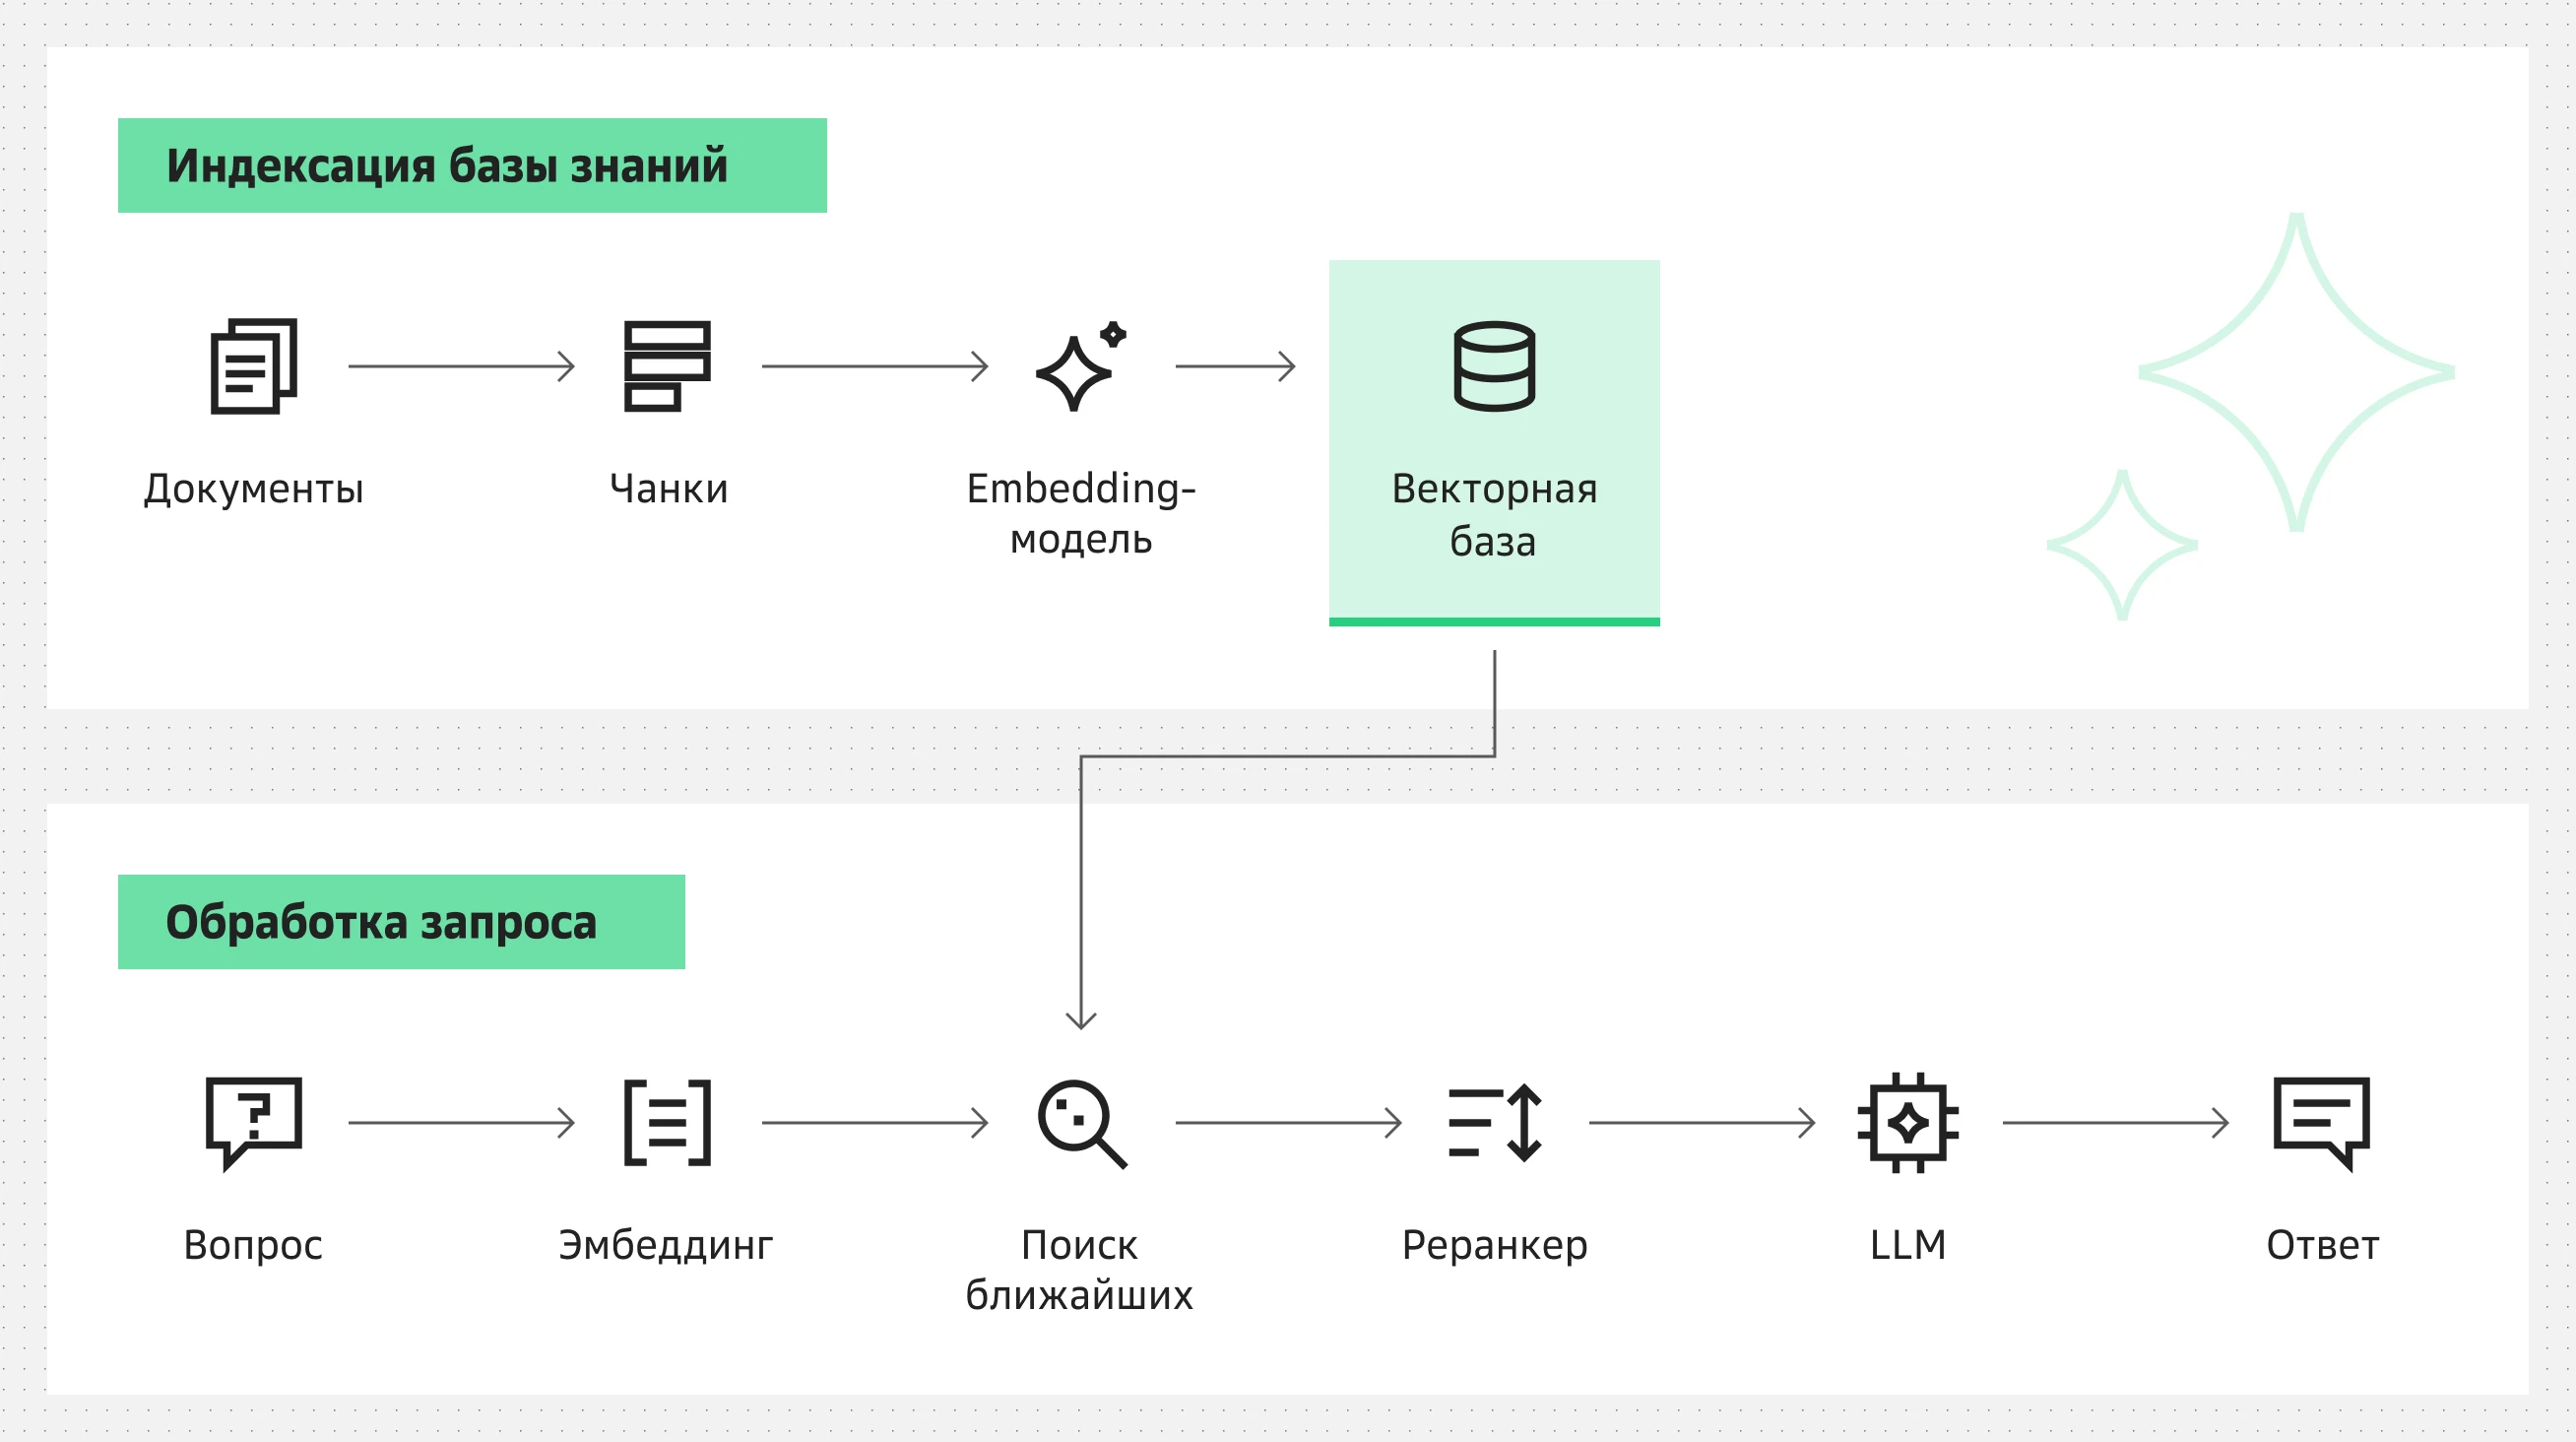 Схема работы RAG
Как выбрать модель эмбеддингов
При выборе модели нужно учитывать требования к поиску, количество данных, стоимость обработки запросов.
Качество на русском языке
Поддержка русского языка еще не гарантирует, что модель будет хорошо справляться с поиском. Важно, насколько точно она понимает разные формулировки, распознает синонимы и сокращения, учитывает профессиональную лексику и особенности контекста.
Поэтому тестируйте модели на собственных данных. Подготовьте набор реальных пользовательских запросов и документов, которые нужно найти. Сравните результаты и оцените, какая модель точнее находит нужную информацию в вашей русскоязычной базе и лучше подходит для конкретных задач.
Размерность, длина контекста и цена
Расшифруем каждый параметр:
Размерность вектора — количество числовых значений в эмбеддинге. Чем их больше, тем выше требования к объему памяти для хранения векторов и вычислений.
Длина контекста (контекстное окно) — максимальный объем текста, который модель может обработать за один раз. Если документ больше, применяется чанкинг (chunking) — разбиение на фрагменты.
Цена — стоимость создания эмбеддингов и обработки запросов. У облачных моделей она часто зависит от количества токенов. При локальном развертывании учитываются расходы на оборудование и вычислительные ресурсы.
При выборе модели сравнивайте не отдельные характеристики, а их соотношение. Например, модель с высокой размерностью не всегда обеспечивает точный поиск, зато требует больше ресурсов для хранения и обработки векторов. Ищите оптимальный вариант в зависимости от объема своей базы знаний, сложности и частоты обращений, требований к скорости ответов.
Мультимодальные эмбеддинги для текста и изображений
Обычные модели эмбеддингов работают только с текстом. Мультимодальные умеют создавать векторные представления данных нескольких типов, включая изображения. Это позволяет точно сопоставлять информацию, даже если искомые объекты являются разными сущностями.
Например, пользователь спрашивает про конкретный товар. Система ищет в каталоге подходящие изображения и текстовое описание. При этом данные преобразуются в векторы, которые модель сравнивает в общем пространстве представлений.
Есть смысл использовать мультимодальные модели только в том случае, если поиск ведется по разным форматам. Иначе вы будете переплачивать за избыточные возможности.
Зачем нужен реранкер (Reranker)
Векторный поиск по эмбеддингам работает быстро, но не всегда точно ранжирует результаты. Модель может найти подходящие варианты, но не поставить самые полезные документы на первые позиции. На помощь придет реранкер — инструмент для уточнения и изменения порядка результатов поиска, чтобы сделать его релевантным пользовательскому запросу.
Например, по запросу «как снизить расходы на серверы» модель может найти 50 документов. Реранкер проанализирует их совместно с запросом и выдаст пользователю самые точные. Он особенно полезен в RAG-системах, где качество ответа зависит от того, какие фрагменты документов попадут в контекст LLM.
Реранкер добавляет вычислительную нагрузку, поэтому его обычно применяют не ко всей базе, а только на узкой выборке.
Эмбеддинги в облаке Cloud.ru
У Cloud.ru есть два решения для работы с эмбеддингами и реранкерами — Evolution Foundation Models и Evolution Managed RAG.
Embedding-модели и реранкеры в Evolution Foundation Models
Evolution Foundation Models предоставляет готовые ИИ-модели, в том числе для создания эмбеддингов. В каталоге доступны embedding-модели BGE-M3 и Qwen3-Embedding-0.6B, а также реранкеры BGE-Reranker-v2-M3, Qwen3-Reranker-0.6B и другие. К выбранным моделям можно обращаться через API.
Модели эмбеддингов в Evolution Foundation Models:
Модель | Разработчик | Контекст | Мультимодальность | Цена за 1 млн токенов | Когда выбирать |
bge-m3 | BAAI | 8K | Нет | 0,61 ₽ | Для семантического поиска |
Qwen3-Embedding-0.6B | Qwen | 32K | Нет | 0,854 ₽ | Для работы с длинными текстами |
Giga-Embeddings-instruct-480M | ai-sage | 8K | Нет | ~ 3,32 ₽ | Для поиска по текстам |
Giga-Embeddings-instruct-3B | ai-sage | 8K | Нет | 32,22 ₽ | Когда нужна крупная модель |
Qwen3-VL-Embedding-2B | Qwen | 32K | Да | 2–8 ₽ | Для поиска по текстам и визуальным материалам |
*Цены указаны по состоянию на ноябрь 2026 г. и могут меняться. Актуальные тарифы — в калькуляторе и документации Cloud.ru.
Evolution Managed RAG: поиск по документам без разработки
Evolution Managed RAG позволяет создавать базу данных на основе собственных документов, которые можно добавлять и актуализировать в один клик. Базу можно подключить к выбранной языковой модели. Сервис будет автоматически обрабатывать файлы и готовить данные для семантического поиска.
Заключение
Эмбеддинги превращают текст в числовые векторы, которые помогают нейросетям находить смысловые связи между данными. На их основе работают семантический поиск, рекомендательные системы и RAG.
Качество таких решений зависит не только от алгоритмов, но и от выбранной модели. При ее выборе важно учитывать длину контекста, качество работы с русским языком и специфику данных. А если нужно повысить точность поисковой выдачи, можно дополнительно использовать реранкер, который оценивает релевантность найденных материалов и помогает расположить их в нужном порядке.
FAQ
Что такое эмбеддинг простыми словами?
Это числовое представление текста или изображения, отражающее смысловые особенности. Оно позволяет нейросетям искать объекты не только по ключевым словам, но и по содержанию.
Чем эмбеддинг отличается от токена?
Токен — это единица текста, которую обрабатывает модель. Эмбеддинг — вектор, отражающий смысл токена в многомерном пространстве.
Как измеряют сходство эмбеддингов?
Для этого часто используют косинусное сходство, которое показывает близость направлений двух векторов. Чем значение ближе к единице, тем больше сходства.
Какие модели эмбеддингов хорошо работают с русским языком?
BGE-M3, семейство Qwen3-Embedding и Giga-Embeddings. Выбор зависит от особенностей вашей базы и текущих задач.
Где хранят эмбеддинги?
Обычно в векторных базах, которые оптимизированы для больших массивов чисел. К тому же, специальная структура данных (индекс ANN) позволяет моментально находить похожие эмбеддинги даже среди миллионов векторов.
Зачем нужны эмбеддинги в RAG?
Они помогают находить в базе знаний документы, релевантные пользовательским запросам, даже если формулировки в обращениях отличаются.
Что такое реранкер и когда он нужен?
Это модель, которая заново ранжирует результаты поиска. Она полезна, если похожих материалов много, поскольку не всегда на первые позиции попадают самые подходящие.