Высоконагруженные системы: как проектировать отказоустойчивость
Высокая нагрузка — это не только большое количество пользователей. Для системы это режим, в котором растет число запросов, объем данных и нагрузка на инфраструктуру. Если архитектура не рассчитана на такие условия, очередной пик — рекламная кампания, горячий сезон или распродажа — может привести к сбоям.


- Что такое высоконагруженная система и когда пора проектировать highload-архитектуру
- Принцип 1. Ни одной единой точки отказа
- Принцип 2. Горизонтальное масштабирование и stateless-сервисы
- Слой данных: реплики, шардирование, кеш, очереди
- Зоны доступности и георезервирование
- Деградация вместо падения
- Нагрузочное тестирование: проверка до продакшена
- Строительные блоки в Cloud.ru
- Чек-лист: 10 проверок перед пиковым сезоном
Особенно уязвимы отдельные компоненты системы. Например, если база данных (БД) не справится с потоком запросов, проблемы могут распространиться на все приложение. В результате команда тратит время на поиск узкого места, а бизнес — деньги на простой и потерянные операции.
Поэтому отказоустойчивость высоконагруженной системы важно закладывать еще на этапе проектирования. Рассказываем, какие архитектурные паттерны помогают распределять нагрузку, устранять единичные точки отказа и сохранять работоспособность системы даже при сбоях отдельных компонентов.
Что такое высоконагруженная система и когда пора проектировать highload-архитектуру
Высоконагруженная система (Highload) — это система, которая способна стабильно работать при большом и постоянно меняющемся объеме запросов и данных. Один из ключевых показателей здесь — RPS (Requests Per Second), то есть количество запросов, которые система обрабатывает за секунду. Но одного RPS недостаточно: важно учитывать сложность операций, объем данных, требования к скорости ответа и то, как система ведет себя при пиковых нагрузках.
Highload начинается там, где стандартной архитектуры уже недостаточно и систему нужно специально проектировать с учетом масштабирования, производительности и отказоустойчивости.
Как понять, что системе нужна highload-архитектура
Нет единого порога RPS, после которого систему можно назвать высоконагруженной. Один сервис без проблем обрабатывает несколько тысяч запросов в секунду, а другой при такой нагрузке начинает терять производительность и доступность. Поэтому Highload определяют не только по RPS, но и по тому, как система справляется с ростом трафика без заметного увеличения задержек и сбоев.
Вот признаки, которые указывают, что система работает на пределе возможностей:
Покупка более мощного сервера не решает проблему задержек.
Не хватает ресурсов процессора, оперативной памяти, пропускной способности сети.
Растут очереди запросов: увеличивается время ответа, а часть запросов завершается по таймауту.
Происходит деградация функциональности, появляются ошибки.
Отказ высоконагруженного сервиса может дорого обойтись бизнесу: недоступность приводит к потере заказов и выручки, а частые сбои — к снижению доверия пользователей. Поэтому при прогнозируемом росте нагрузки важно заранее продумать масштабирование. Увеличение мощности одного сервера может временно решить проблему, но со временем узкими местами становятся другие компоненты системы: базы данных, хранилища, сети или очереди. Горизонтальное масштабирование позволяет распределять нагрузку между несколькими экземплярами и снижать зависимость от одного ресурса.
Метрики, которыми описывается высоконагруженная система
В итоге оцениваются четыре показателя:
RPS (Requests Per Second) — фактическое количество запросов, которое система обрабатывает за секунду. Различают средний и пиковый RPS: средний показывает штатную пропускную способность, пиковый — максимальную нагрузку, которую система выдерживает без деградации. Нужно смотреть не только на средние значения, но и на пиковые.
Латентность (Latency, задержка) — время обработки запроса. Вместо среднего значения обычно используют перцентили (Percentiles). Например, p95 означает, что 95% запросов обрабатываются с задержкой не выше указанного значения, а оставшиеся 5% — с большей задержкой.
Доступность — период, когда сервис исправно работает. Его часто выражают в девятках, например, 99,9%, 99,99%, 99,999%.
Допустимый простой — период, когда сервис может не работать без особого ущерба для бизнеса. Целевому уровню доступности 99,9% (три девятки) соответствует допустимый простой в не более 8,76 часа в год (8 часов 46 минут).
Показатели нужно рассматривать комплексно. Например, у системы высокий RPS, но она выдерживает нагрузку с нормальной латентностью и не «падает». Значит, скорее всего, нагрузка для нее штатная. Если показатели ухудшаются — предельная.
Эти метрики помогают понять, как система ведет себя под нагрузкой и в какой момент начинает деградировать. Но одной оценки производительности недостаточно: важно заранее предусмотреть, что произойдет при отказе отдельных компонентов. Для этого используют архитектурные принципы отказоустойчивости. Первый и базовый из них — убрать единичные точки отказа.
Принцип 1. Ни одной единой точки отказа
Нужно найти Single Point of Failure — компоненты, из-за отказа которых сервис будет недоступным. Для них нужны резерв и механизм переключения на него.
Карта SPOF: балансировщик, база, кеш, внешние зависимости — где прячутся точки отказа
Точка отказа может быть на любом уровне, поэтому нужно проверить:
Балансировщики и точки входа — переходит ли трафик на другой узел при отказе одного балансировщика или входного узла.
Серверы приложений — может ли сервис работать при сбое одной машины.
Базу данных — есть ли реплики и механизмы переключения между ними.
Кеш и очереди — не станет ли отказ одного экземпляра кеша или очереди причиной сбоя критичных функций приложения.
Сеть и хранилища — есть ли резервные соединения и дополнительные места хранения, которые продолжат работу при отказе основных.
Оценивают и внешние зависимости. Нужно понимать, что произойдет, если станут недоступны платежный шлюз, API или другой востребованный сервис. Тут как раз и возникают узкие места, которых не видно в схеме инфраструктуры.
Резервирование N+1 и автоматическое переключение по health check
Расшифруем N+1:
N — количество экземпляров компонентов, необходимых для работы системы;
+1 — один резервный компонент «на всякий случай».
Если основной выйдет из строя, резервный его заменит. Например, приложению нужны три сервера, значит, компания запускает четыре. Три обслуживают нагрузку, а четвертый просто «ждет».
Периодически состояние компонентов проверяют с помощью процедуры Health check. Балансировщик направляет к серверам запросы. Если тот их принимает и обрабатывает, все в порядке. Если проверка не проходит, трафик автоматически перенаправляется на исправные компоненты.
Принцип 2. Горизонтальное масштабирование и stateless-сервисы
Горизонтальное масштабирование позволяет справляться с постоянным ростом нагрузки, в том числе в пиковые периоды. Оно работает в долгосрочной перспективе и избавляет от необходимости постоянно увеличивать мощность одного сервера.
Вертикальный рост упирается в потолок, а горизонтальный — в архитектуру приложения
При вертикальном масштабировании увеличивают ресурсы одного сервера: CPU, оперативную память, пропускную способность сети и производительность дисков. Это позволяет выдерживать растущую нагрузку без изменений в приложении, но у одной машины есть предел. Кроме того, ее отказ может сделать сервис недоступным, если не предусмотрен резерв.
При горизонтальном масштабировании нагрузку распределяют между несколькими серверами. При росте трафика можно добавить новые экземпляры и тем самым увеличить производительность системы. Но для этого приложение должно быть рассчитано на работу нескольких экземпляров.
Обычно для этого используют stateless-архитектуру: серверы не хранят локально состояние, необходимое для обработки запросов. Общие данные и состояние выносят во внешние хранилища, поэтому любой экземпляр может независимо принять и обработать запрос.
Управлять такими экземплярами помогает оркестрация, например Kubernetes. Оркестратор следит за состоянием сервисов, запускает новые экземпляры при росте нагрузки и перезапускает отказавшие.
Выносим состояние из серверов: кеш, очереди и хранилища
Данные, которые сохраняются между запросами, должны быть во внешних хранилищах. Основное состояние приложения — в базе. Для временных данных и сессий подходит Redis, который хранит часто используемую информацию отдельно от приложения и позволяет всем серверам получать ее быстро. Для документов имеет смысл выбрать объектное хранилище.
Для передачи задач между серверами используют брокер сообщений Kafka — распределенную платформу потоковой передачи событий. Сообщения публикуются в топики (topics), которые разделены на партиции (partitions). Потребители (consumers) читают сообщения из партиций, при этом каждое сообщение может быть обработано несколькими потребительскими группами независимо.
Изображения, видео, CSS и статические элементы приложения можно отдавать пользователям через сеть доставки контента CDN (Content Delivery Network). Она ускоряет выдачу, загружая данные с ближайшего доступного узла.
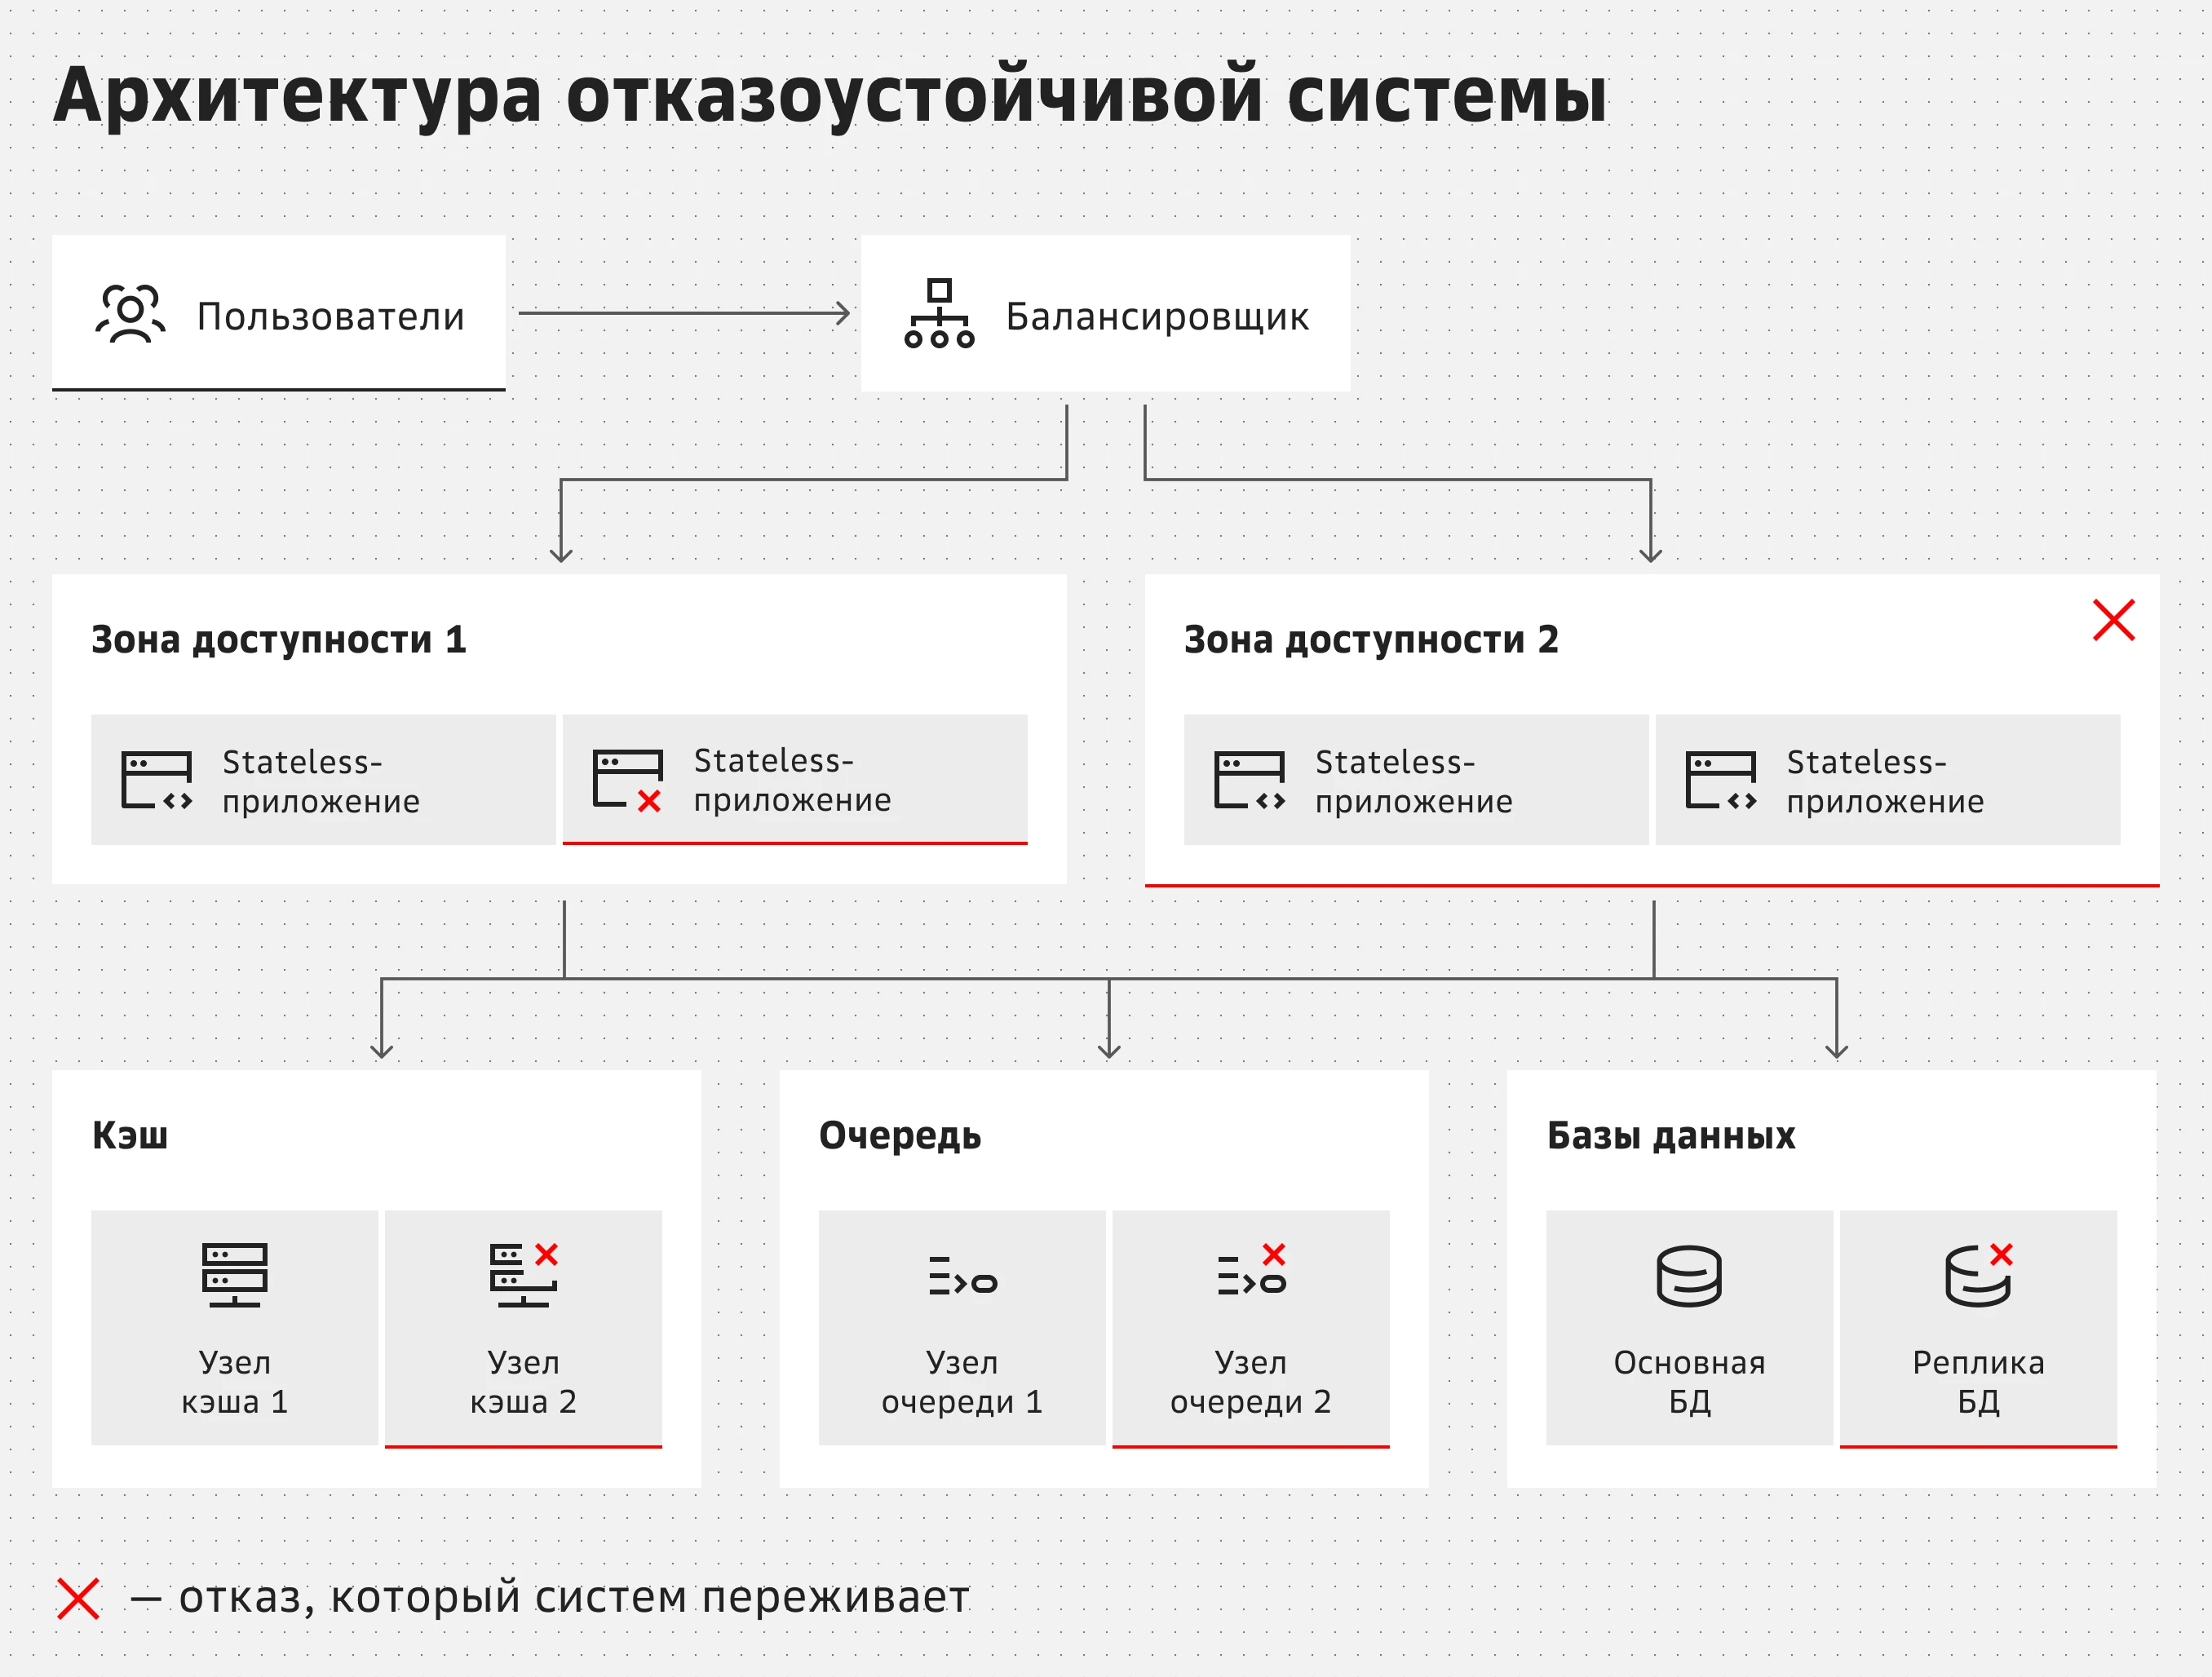 Примерная схема отказоустойчивой системы
Слой данных: реплики, шардирование, кеш, очереди
При горизонтальном масштабировании узким местом становится работа с данными. Несколько серверов могут одновременно обращаться к одной базе, тем самым создавая большую нагрузку. Чтобы не упереться в ограничения, нужно масштабировать и слой данных.
Репликация базы: чтение с реплик, переключение при отказе мастера
Репликация создает несколько копий базы данных и позволяет распределять нагрузку между ними. Например, операции записи выполняются на основном узле, а запросы на чтение — на репликах. Это снижает нагрузку на основной узел и позволяет обрабатывать больше запросов.
Реплики нужны и для отказоустойчивости. Если основной узел становится недоступен, система может переключиться на одну из реплик. Для этого заранее настраивают механизм переключения — автоматический или ручной.
При проектировании репликации важно учитывать требования к согласованности и доступности данных. При сетевом разделении распределенной системы приходится выбирать, что важнее: гарантировать одинаковое состояние узлов или продолжать обрабатывать запросы. Поэтому в highload-системах иногда используют eventual consistency и асинхронную репликацию, если приоритетом является доступность.
Репликация не решает проблему роста нагрузки на запись. Если одного экземпляра базы становится недостаточно, применяют шардирование — разделяют данные между несколькими экземплярами. Каждый шард отвечает за свою часть данных, поэтому нагрузку можно распределять между несколькими узлами и масштабировать слой базы данных.
Кеширование и очереди сообщений: снять пик с базы и развязать сервисы
Кеш хранит часто запрашиваемые данные, чтобы сервису не приходилось при каждом похожем запросе вновь обращаться к базе. Также в него можно вынести информацию, которая редко меняется. Это снизит нагрузку на БД и ускорит выдачу ответов.
Чтобы не обрабатывать все запросы сразу, можно формировать очереди сообщений. Один сервис принимает задачу, помещает ее в очередь, а другой — выполняет, когда есть свободные ресурсы. Таким образом сглаживаются резкие пики нагрузки.
Очереди также уменьшают зависимость сервисов друг от друга. Если один временно недоступен, его задачи могут оставаться в очереди и выполняться после восстановления.
Зоны доступности и георезервирование
Для повышения отказоустойчивости экземпляры приложения размещают в нескольких зонах доступности. Если одна из зон становится недоступной, балансировщик перестает направлять в нее трафик, а запросы продолжают обрабатываться в других зонах. Для защиты от более масштабных сбоев, затрагивающих весь регион, критичные сервисы дополнительно размещают в разных регионах.
Чтобы приложение могло работать на разных площадках, распределять нужно не только серверы, но и все критичные компоненты: базы данных, кеш, очереди, зависимости.
При проектировании георезервирования нужно учитывать сценарий потери одной зоны. Оставшейся инфраструктуры должно хватать для обработки критичного трафика. Следует заранее спрогнозировать пиковую нагрузку, чтобы точнее определить необходимое количество зон.
Деградация вместо падения
При резком росте нагрузки можно временно ограничить часть функций, чтобы сохранить доступ к основным операциям.
Graceful degradation: какие функции отключать под пиком, чтобы сохранить главное
Graceful degradation — управляемая деградация, подразумевающая временное отключение некоторых функций в период пиковой нагрузки. Выбирают те, без которых пользователь может продолжать работать с приложением. Например:
персональные рекомендации;
автодополнение и поисковые подсказки;
персонализация контента;
аналитика;
фоновые задачи;
вывод дополнительных блоков данных;
ресурсоемкие динамические расчеты.
При этом важно задать уровень деградации. Например, при росте нагрузки сначала ограничивают самые тяжелые операции, затем дополнительные функции. Критичные действия, такие, как авторизация, просмотр данных, оформление заказов и проведение платежей должны работать как обычно.
Деградацию автоматизируют по заданным условиям, например, при увеличении времени ответов, переполнении очереди запросов, росте нагрузки на CPU. Когда пик пройдет, отключенные функции можно вернуть в обычный режим.
Уровень | Что переживает система | Доступность | Стоимость | Сложность |
Одна виртуальная машина | Сбои отдельных процессов | Низкая | Низкая | Низкая |
Резервирование в одной зоне | Отказ одной ВМ | Выше | Средняя | Средняя |
Две зоны | Отказ всей зоны | Высокая | Выше | Высокая |
Георезервирование | Отказ площадки или региона | Максимальная | Высокая | Высокая |
Нагрузочное тестирование: проверка до продакшена
Отказоустойчивость сервисов нужно проверять до вывода в полноценную эксплуатацию. Для этого проводят тестирования и учения.
Виды тестов: нагрузочное, стресс, объемное, стабильности — что показывает каждый
У каждого типа тестирования своя задача:
Нагрузочное — проверяет работу системы при ожидаемой или прогнозируемой нагрузке. Показывает, выдерживает ли система заданный объем запросов с приемлемой задержкой и уровнем ошибок. В зависимости от целей может включать проверку стабильности под нагрузкой в течение определенного времени.
Стресс-тестирование — постепенно увеличивает нагрузку выше обычной, чтобы определить предел и поведение сервиса.
Объемное — проверяет работу с большим количеством разноплановых данных.
Тестирование стабильности — запускает систему под длительной нагрузкой, чтобы выявить утечки памяти, падение производительности и другие узкие места, незаметные при обычной работе.
Эти тестирования проводят комплексом, чтобы проверить отказоустойчивость с разных сторон: выдерживает ли система обычную нагрузку, где предел производительности, сохраняются ли оптимальные показатели при длительной работе.
Методика: профиль нагрузки из продакшена, сценарии, критерии прохождения
Профиль нагрузки составляют по данным продакшена: количеству запросов, соотношению операций чтения и записи, целевой нагрузке и пиковым периодам. На его основе формируют сценарии, которые воспроизводят типичные пользовательские действия и поведение системы при пиковом трафике.
Результаты оценивают по нескольким критериям:
количество ошибок и их доля от общего числа запросов;
время ответа для обычных и критичных операций;
достигнутая пропускная способность.
Для нагрузочного тестирования используют специальные инструменты, например JMeter, k6, Locust и Gatling. Выбор зависит от сценария и масштаба теста. JMeter подходит для моделирования большого числа одновременных пользователей, но при очень высокой нагрузке сам требует значительных ресурсов. k6 использует асинхронную модель и подходит для нагрузочных, стресс- и регрессионных тестов. Locust позволяет описывать сложные пользовательские сценарии на Python, а Gatling — на Java, Scala и Kotlin.
Помимо системы, во время теста контролируются CPU, память, сеть, диски, базы данных и очереди.
Сhaos engineering: проверяем систему на отказах
Перед выходом в продакшен важно проверить, как система поведет себя при отказе отдельных компонентов. Для этого в контролируемых условиях намеренно выводят из строя базу данных, реплику, внешний сервис или другой компонент и наблюдают за реакцией системы.
Для каждого сценария заранее определяют ожидаемое поведение: какие функции могут временно деградировать, куда должен переключиться трафик, сколько времени допустимо восстановление. После сбоя проверяют, продолжают ли работать критичные функции, справляется ли оставшаяся инфраструктура с нагрузкой и корректно ли происходит переключение.
Отдельно проверяют восстановление: после возвращения компонента система должна без ручного вмешательства или по предусмотренному сценарию вернуться в штатный режим.
Строительные блоки в Cloud.ru
В Cloud.ru есть управляемые сервисы для масштабирования вычислительных ресурсов, распределения трафика, работы с базами данных и очередями, а также управления инфраструктурой. Их можно использовать отдельно или комбинировать в одной архитектуре.
Evolution Load Balancer — балансировка трафика и автомасштабирование в Cloud.ru Evolution
Evolution Load Balancer автоматически распределяет сетевой трафик из интернета и внутри VPC. Сервис может работать с публичным или приватным IP-адресом, а также с обоими одновременно.
Для масштабирования вычислительных ресурсов можно использовать Evolution Compute и Evolution Managed Kubernetes. В Kubernetes количество узлов кластера можно автоматически изменять в зависимости от нагрузки. Оркестратор также учитывает состояние узлов и не направляет нагрузку на недоступные экземпляры.
Три зоны доступности и дата-центры Tier III: Evolution Managed PostgreSQL с репликами, Evolution Managed Kafka для очередей, Evolution Object Storage для состояния
Платформа Cloud.ru Evolution размещает инфраструктуру в дата-центрах уровня Tier III. Это означает, что оборудование можно обслуживать без остановки работы, а расчетная доступность составляет около 99,982%.
Предусмотрены три зоны доступности. Если одна из них становится недоступной, сервисы могут продолжить работу в других зонах. Это снижает риск полной остановки сервиса из-за отказа одной площадки.
Для построения отказоустойчивой архитектуры можно использовать управляемые сервисы платформы, каждый из которых решает свою задачу.
База данных. Evolution Managed PostgreSQL позволяет создавать кластеры PostgreSQL с основным узлом (Primary) и репликами (Standby). Для production-окружений можно использовать мультизональный кластер Cluster HA с тремя узлами в разных зонах доступности. При отказе основного узла происходит автоматическое переключение на реплику.
Очереди и события. Evolution Managed Kafka — управляемый сервис на базе Apache Kafka® для публикации, передачи и хранения сообщений в топиках. Его можно использовать для передачи задач между компонентами системы и обработки событий без жесткой связи между сервисами.
Файлы и данные. Evolution Object Storage — объектное хранилище с поддержкой S3 API. В нем можно хранить файлы и другие данные, которые не должны быть привязаны к конкретному серверу приложения. Для повышения отказоустойчивости доступна политика избыточности Multi-AZ.
Мониторинг и аварийное восстановление
Отказоустойчивость требует не только резервирования, но и контроля состояния системы. Cloud Monitoring собирает метрики облачных ресурсов и приложений, помогает отслеживать их на дашбордах и настраивать алерты при сбоях или отклонениях от заданных показателей. Cloud Logging централизованно собирает логи сервисов и приложений. Вместе эти инструменты помогают заметить проблему и найти ее причину.
Для восстановления после серьезных сбоев используют Evolution Disaster Recovery — сервис аварийного восстановления для виртуальных машин и инфраструктуры Cloud.ru Evolution. Он поддерживает репликацию данных между зонами доступности и регионами, а также сценарии георезервирования и восстановления с минимальным простоем. Конкретные сценарии и источники репликации зависят от конфигурации и возможностей сервиса.

Чек-лист: 10 проверок перед пиковым сезоном
Распродажи, рекламные компании, расширение бизнеса — повод заранее подумать об обеспечении отказоустойчивости своих систем. Что проверить:
Точки отказа, например, базы, кеш, очереди.
Резервирование балансировщиков и точек входа.
Запас вычислительных ресурсов на случай роста нагрузки.
Репликацию баз данных и переключение при отказе.
Резервирование кеша и очередей.
Дополнительные подключения и хранилища.
Настройки мониторинга и алертов.
Настройки резервного копирования, актуальность копий и возможность восстановления исходников.
Порядок действий при сбоях и отказах.
Способность системы справляться с ростом нагрузки без потери скорости и доступности.
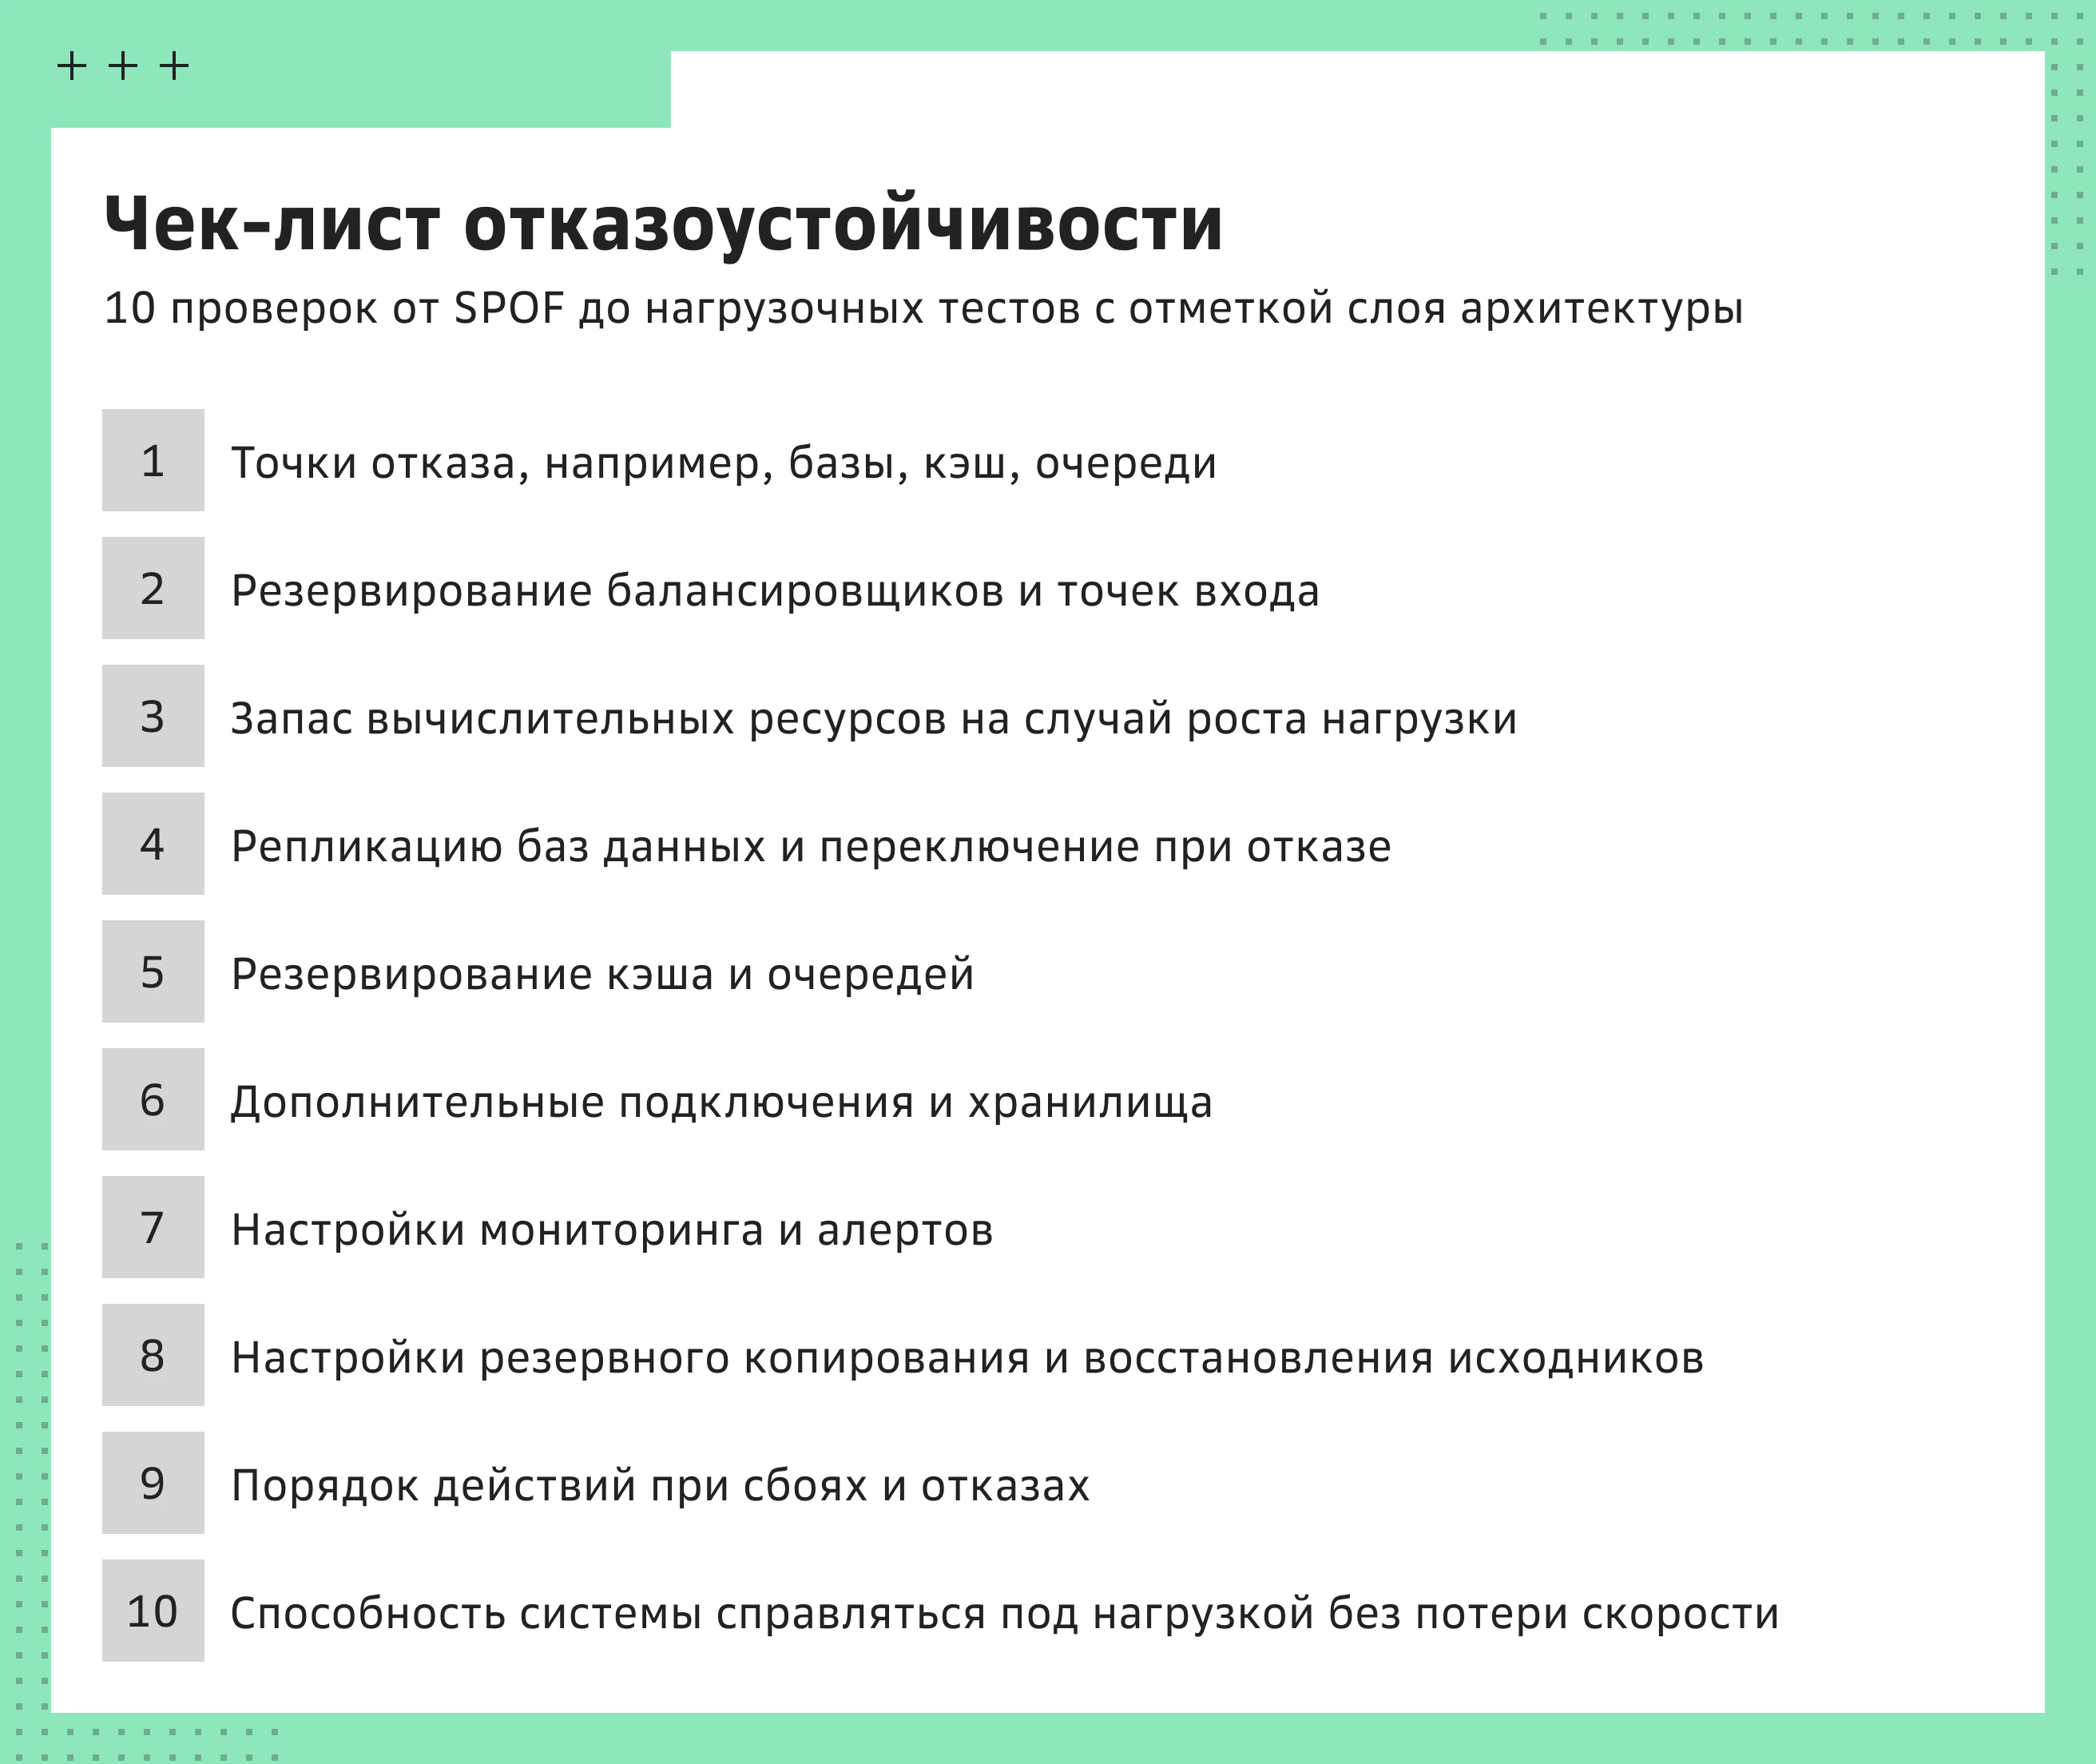 Чек-лист, который поможет убедиться в отказоустойчивости
Заключение
Отказоустойчивость высоконагруженной системы начинается с архитектуры. Нужно заранее убрать единичные точки отказа, предусмотреть горизонтальное масштабирование, вынести состояние во внешние хранилища, реплицировать критичные данные и распределить компоненты по зонам доступности. Но даже продуманную архитектуру важно проверять на практике: нагрузочные тесты и сценарии сбоев помогают убедиться, что система действительно сохраняет работоспособность при пиковых нагрузках и отказах.
Для реализации такой архитектуры можно использовать управляемые сервисы Cloud.ru Evolution: балансировщики, вычислительные ресурсы, Kubernetes, базы данных, очереди, хранилища и инструменты мониторинга. Их можно комбинировать в зависимости от требований к нагрузке, доступности и восстановлению конкретной системы.
FAQ
Что такое высоконагруженная система?
Система, способная стабильно работать в условиях, когда объем данных или количество запросов превышают возможности стандартных решений.
Что такое отказоустойчивость и как ее измерить?
Отказоустойчивость — способность системы продолжать работу при отказе отдельных компонентов и восстанавливаться после сбоев. Ее оценивают по нескольким показателям: доступности сервиса, RTO — целевому времени восстановления, RPO — допустимому объему потерянных данных, а также частоте и длительности отказов.
Чем высокая доступность отличается от отказоустойчивости?
Доступность показывает, как долго сервис остается работоспособным в течение отчетного периода (например, года). Отказоустойчивость — сможет ли система непрерывно функционировать, если «упадут» отдельные компоненты.
Что такое единая точка отказа?
Компонент, при сбое которого система перестает работать.
Чем горизонтальное масштабирование отличается от вертикального?
При горизонтальном добавляют новые серверы, между которыми распределяется нагрузка. При вертикальном — наращивают ресурсы существующего или покупают более производительный.
Как провести нагрузочное тестирование и какими инструментами?
Имитировать нагрузку, постепенно увеличить ее до пиковой и проверить производительность сервиса. В этом помогают решения вроде JMeter, k6 или Gatling.
Что означают 99,9% доступности в минутах простоя?
Три девятки (99,9% доступности) означают, что допустимый простой сервиса составляет не более 8,76 часа в год, то есть примерно 8 часов 46 минут.