Токены в нейросети: что это простыми словами и как считают стоимость запросов
Когда вы отправляете запрос нейросети, она обрабатывает его с помощью токенов — специальных единиц текста. Их количество влияет на объем данных, который языковая модель обрабатывает и генерирует. При работе с LLM через API от этого зависит стоимость использования модели: входные и выходные токены могут тарифицироваться по разным ставкам.
Количество токенов не всегда можно определить по числу слов или символов. Например, на результат влияют язык, структура запроса, наличие кода и история переписки.
Разберемся, как работает токенизация, чем отличаются входные и выходные токены и как рассчитать стоимость запросов к языковым моделям.


Что такое токен простыми словами
Токен — это фрагмент текста, который языковая модель воспринимает как отдельную единицу. Им может быть целое слово, часть слова, знак препинания или сочетание пробела с буквами. Например, распространенные слова обычно занимают один токен, а длинные и редкие могут делиться на несколько частей. Благодаря этому модели не нужно создавать отдельную единицу для каждой возможной формы слова.
Текст на отдельные токены разбивает специальный алгоритм — токенизатор. Он использует словарь фрагментов, характерный для конкретной модели. Поэтому одна и та же фраза может разбиваться на разное количество токенов в разных языковых моделях.
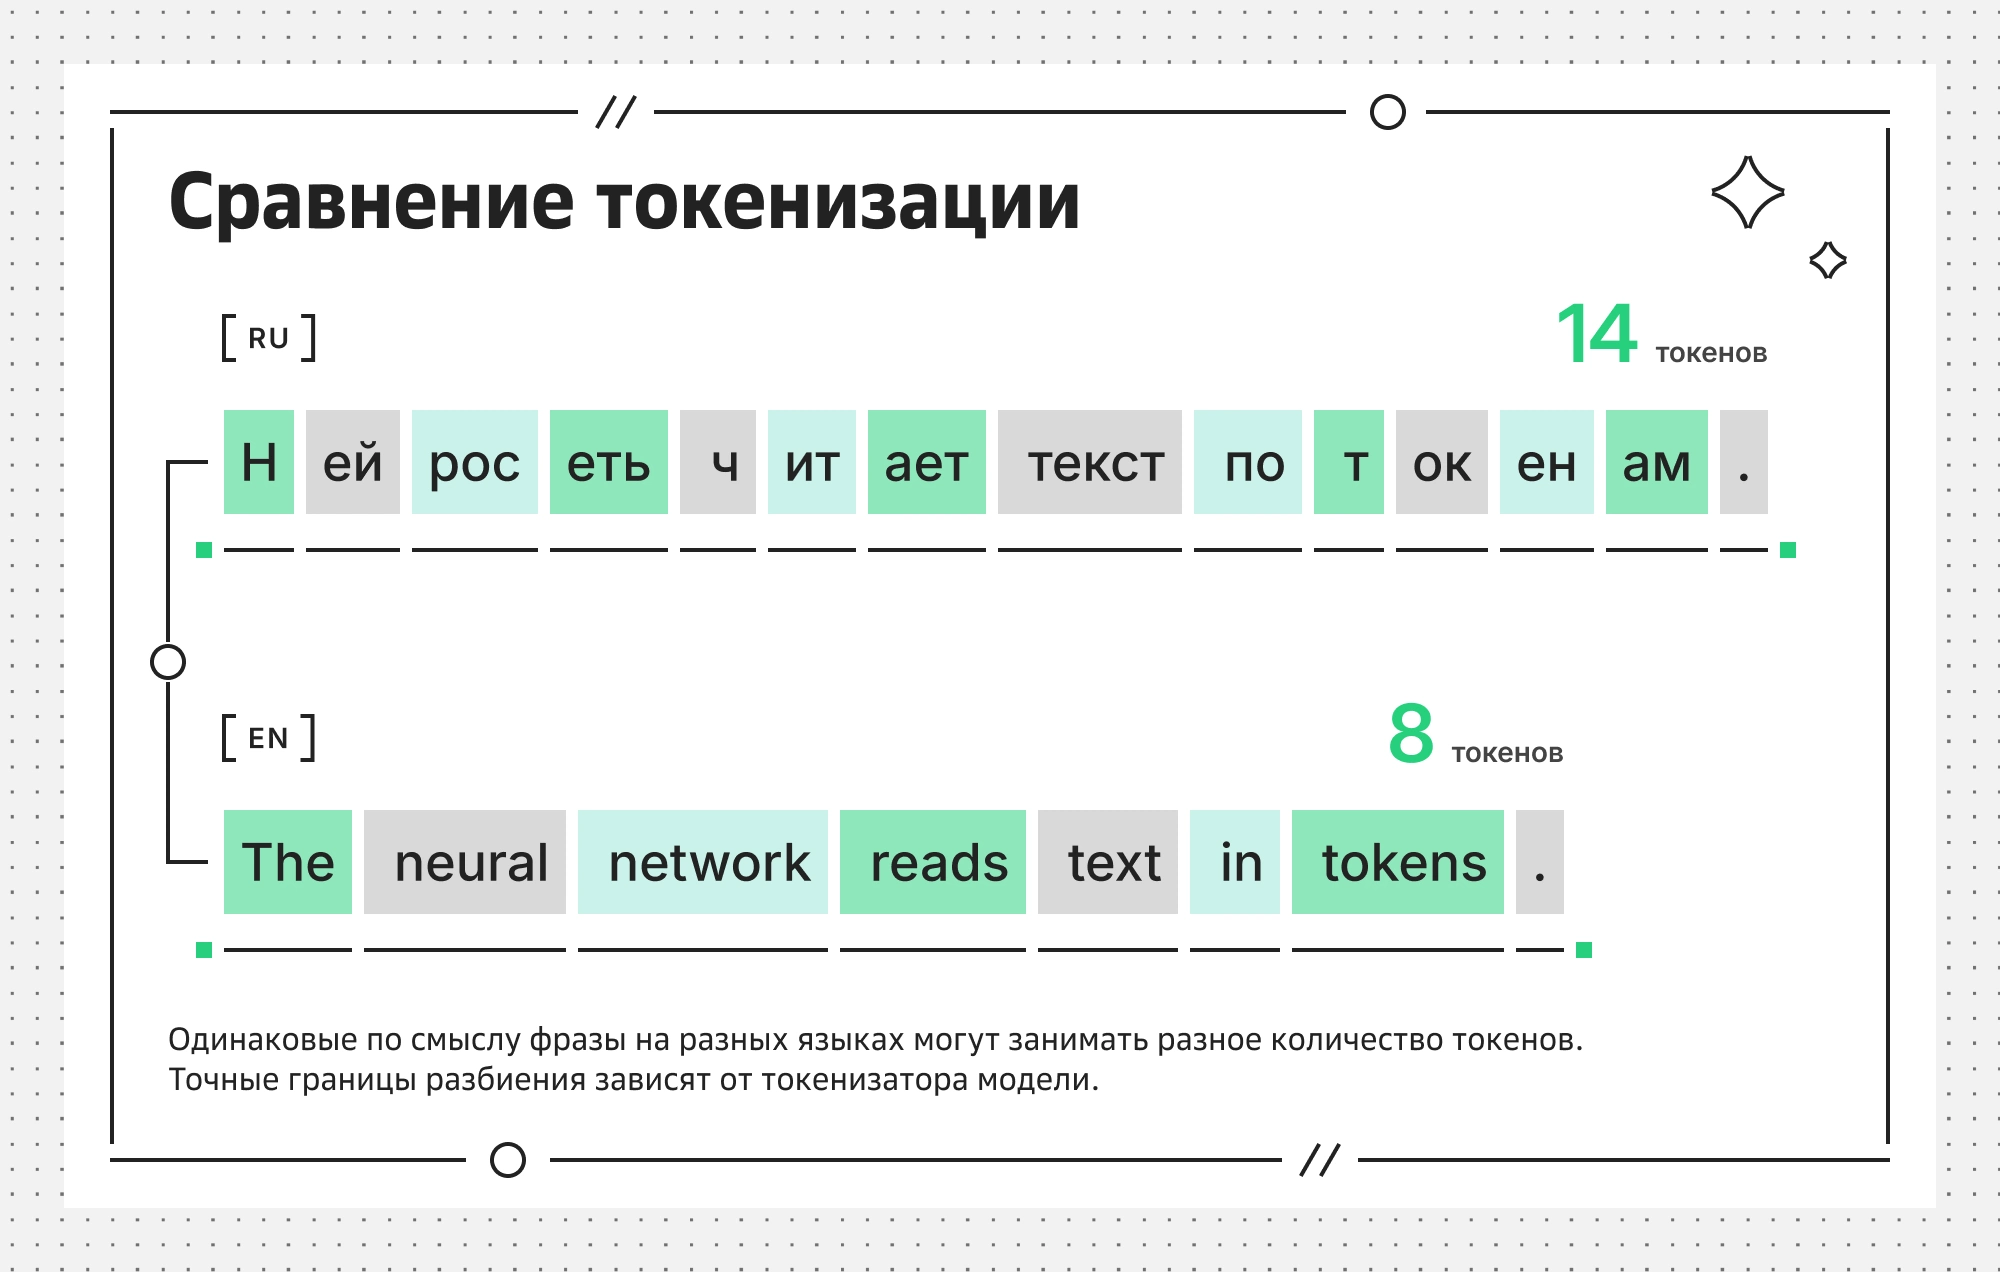 Токенизация в русском и английском языках
Как работает токенизация
После разбиения текста каждый токен получает числовой идентификатор — ID. Это нужно, чтобы языковая модель могла работать с текстом в числовом формате.
Дальше происходит несколько шагов:
Преобразование векторов. Модель переводит ID токенов в числовые векторы — наборы чисел, которые отражают особенности и связи между фрагментами текста.
Обработка последовательности. Модель анализирует токены с учетом их порядка и контекста, чтобы определить смысл запроса и связи между его частями.
Генерация ответа. Модель последовательно предсказывает следующие токены и формирует из них текст ответа.
Таким образом, токенизация — первый этап обработки текста. Она переводит запрос в формат, с которым может работать языковая модель.
Токенизатор и словарь токенов
Для разбиения текста токенизатор использует заранее подготовленный словарь — набор фрагментов, каждому из которых соответствует числовой идентификатор. При одинаковой версии токенизатора и настройках один и тот же текст разбивается одинаково.
Размер словаря зависит от модели. Например, у Qwen3-32B параметр vocab_size в конфигурации составляет 151 936. Но это значение включает не только токены, доступные токенизатору.
Фактически словарь содержит 151 643 обучаемых BPE-слияния и 26 специальных токенов. Последние обозначают служебные элементы, например начало и конец сообщения. Таким образом, размер словаря токенизатора составляет 151 669 записей. Оставшиеся 267 позиций приходятся на padding и предзарезервированные слоты.

Алгоритм BPE на простом примере
Один из распространенных способов формирования словаря — алгоритм BPE (Byte Pair Encoding). Во время обучения токенизатора он многократно объединяет часто встречающиеся пары соседних элементов. В зависимости от реализации исходными единицами могут быть символы или байты. Полученные правила сохраняют и используют для разбиения новых запросов.
Представим, что в обучающих текстах часто встречаются слова «ток», «поток», «токен» и «токены». В упрощенном примере алгоритм сначала объединяет «т» и «о» в «то», затем «то» и «к» в «ток». На следующих шагах могут появиться сочетания «ен» и «токен». Реальный порядок объединений зависит от частоты сочетаний в обучающих текстах, поэтому схема показывает общий принцип работы BPE.
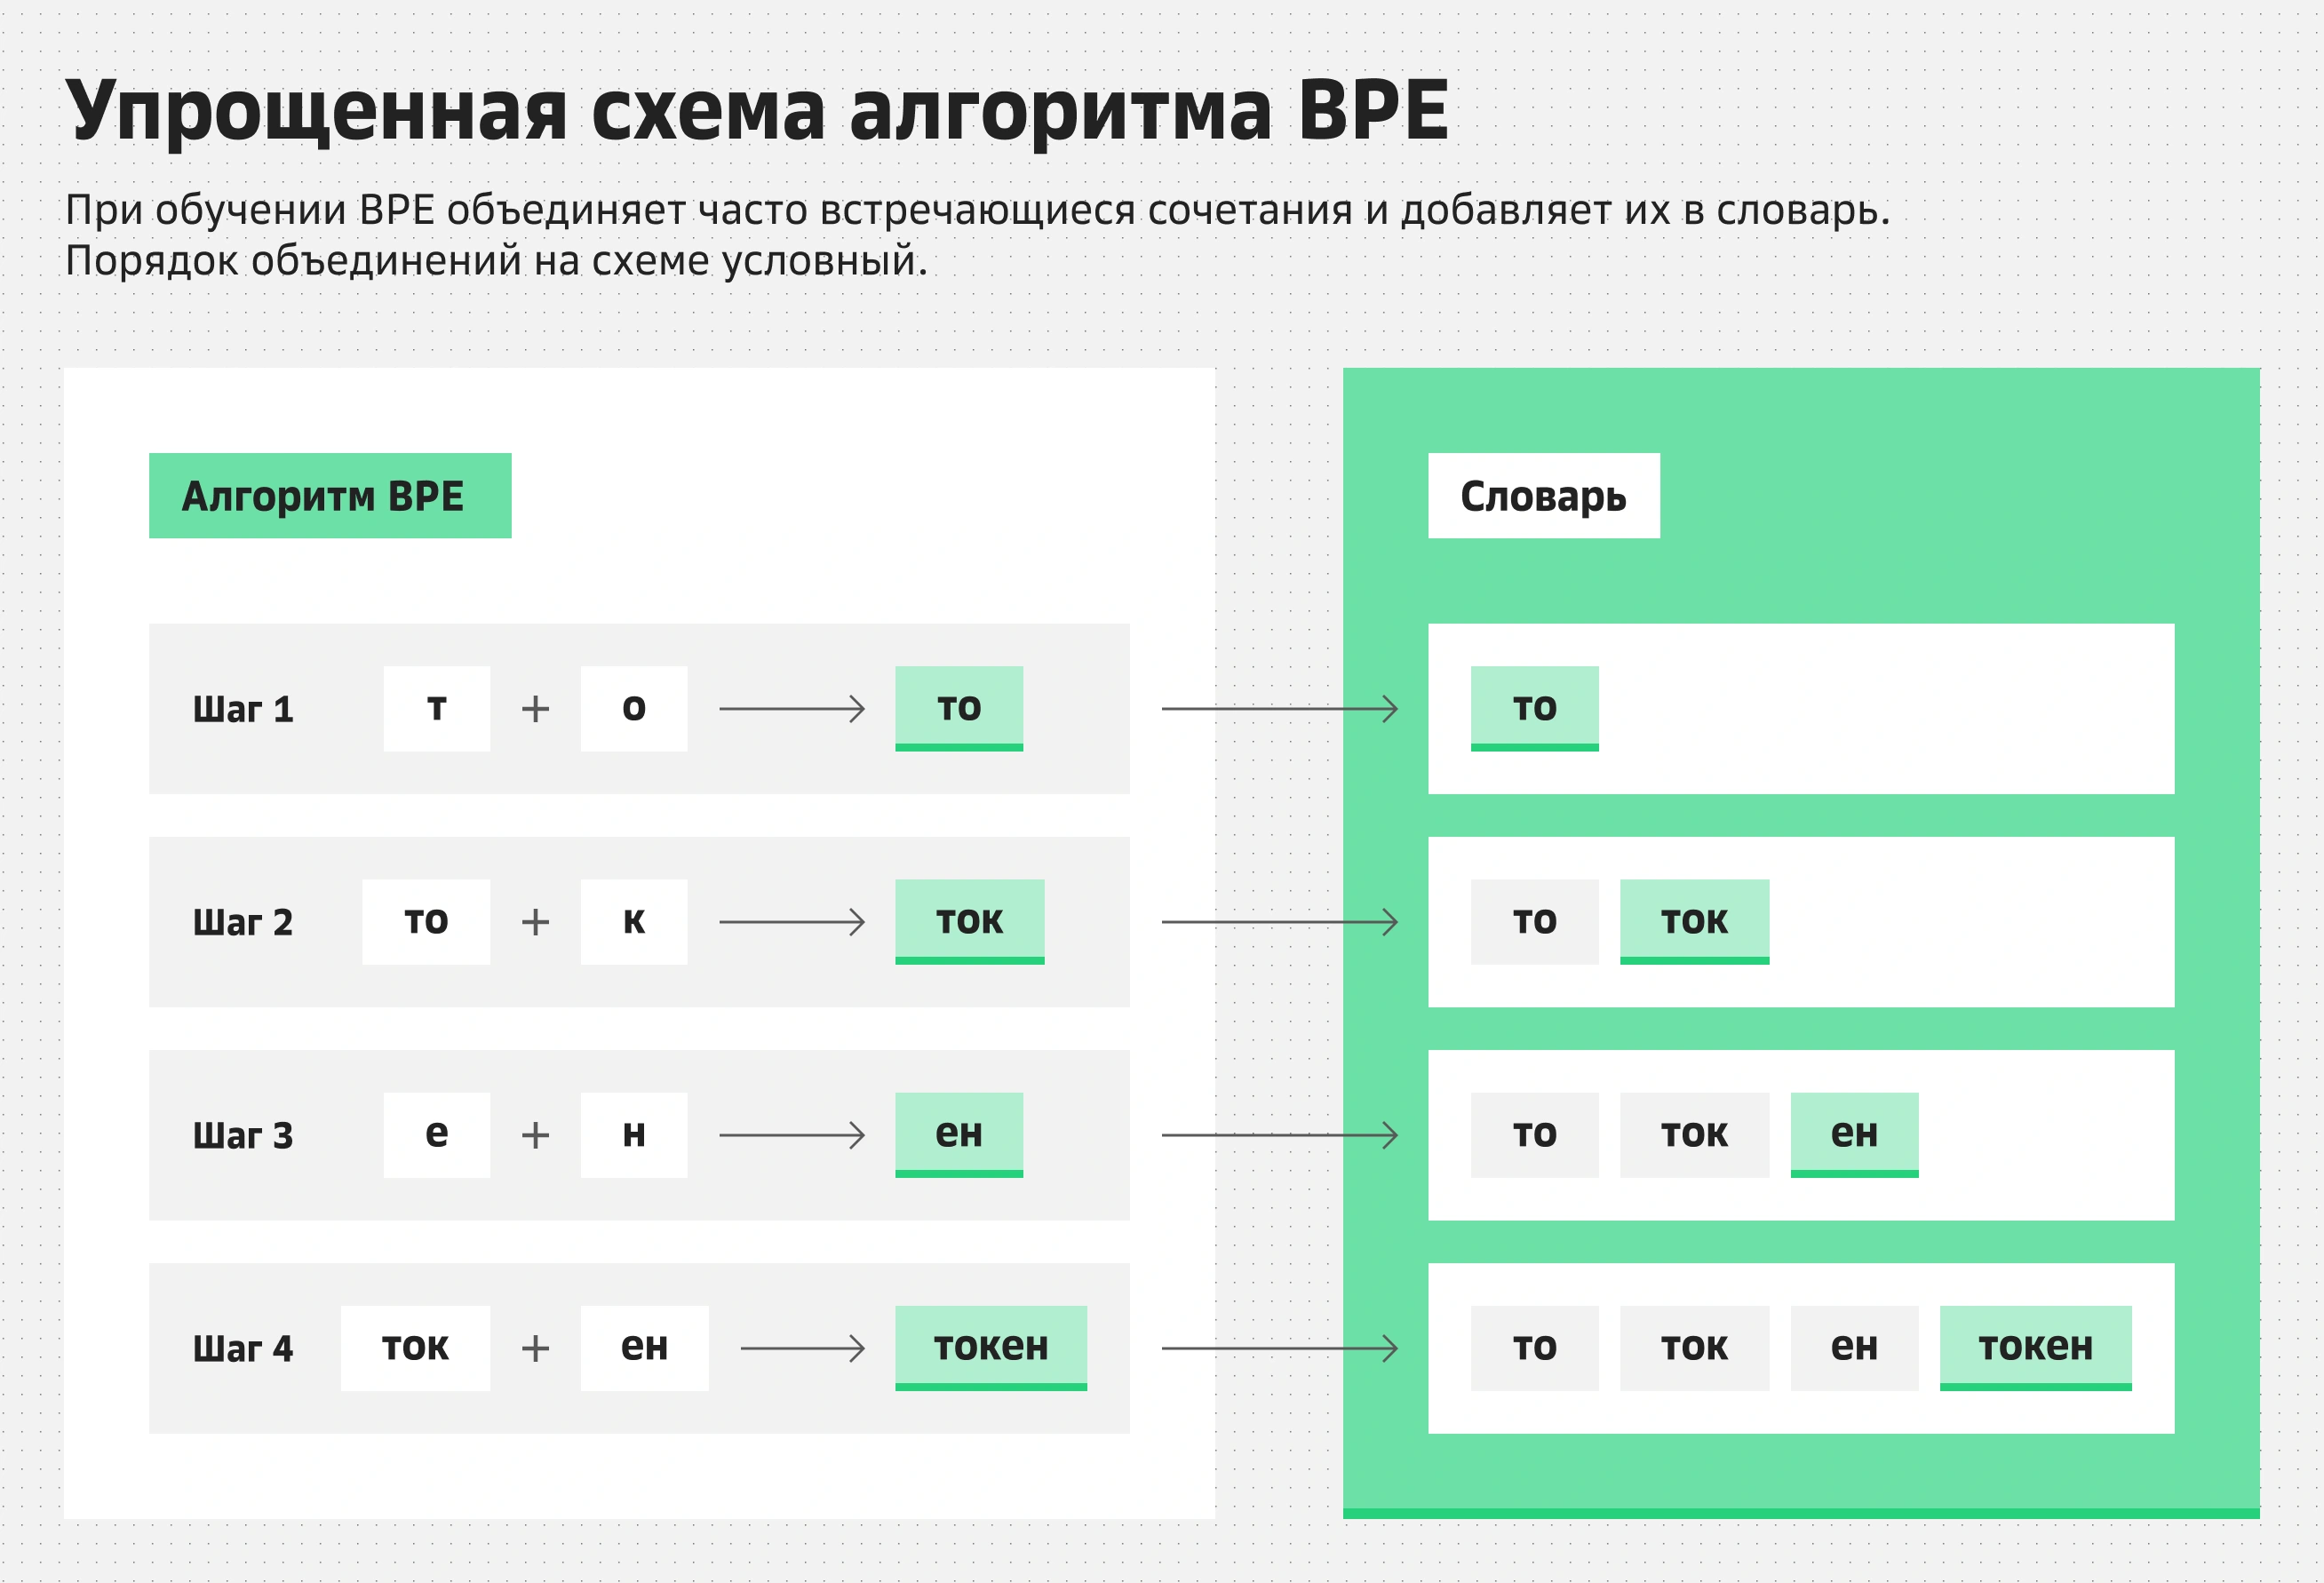 Схема BPE в упрощенном виде
Как работают токены в нейросетях: от чисел к ответу
Когда текст преобразован в числовую последовательность, языковая модель начинает анализировать ее с учетом контекста. Слои трансформера определяют связи между токенами, учитывают их порядок и смысл, чтобы понять запрос.
Затем модель предсказывает следующий токен и добавляет его к ответу. Этот процесс повторяется много раз: каждый новый фрагмент учитывает уже сформированную часть текста. Так постепенно появляется связный ответ на запрос пользователя.
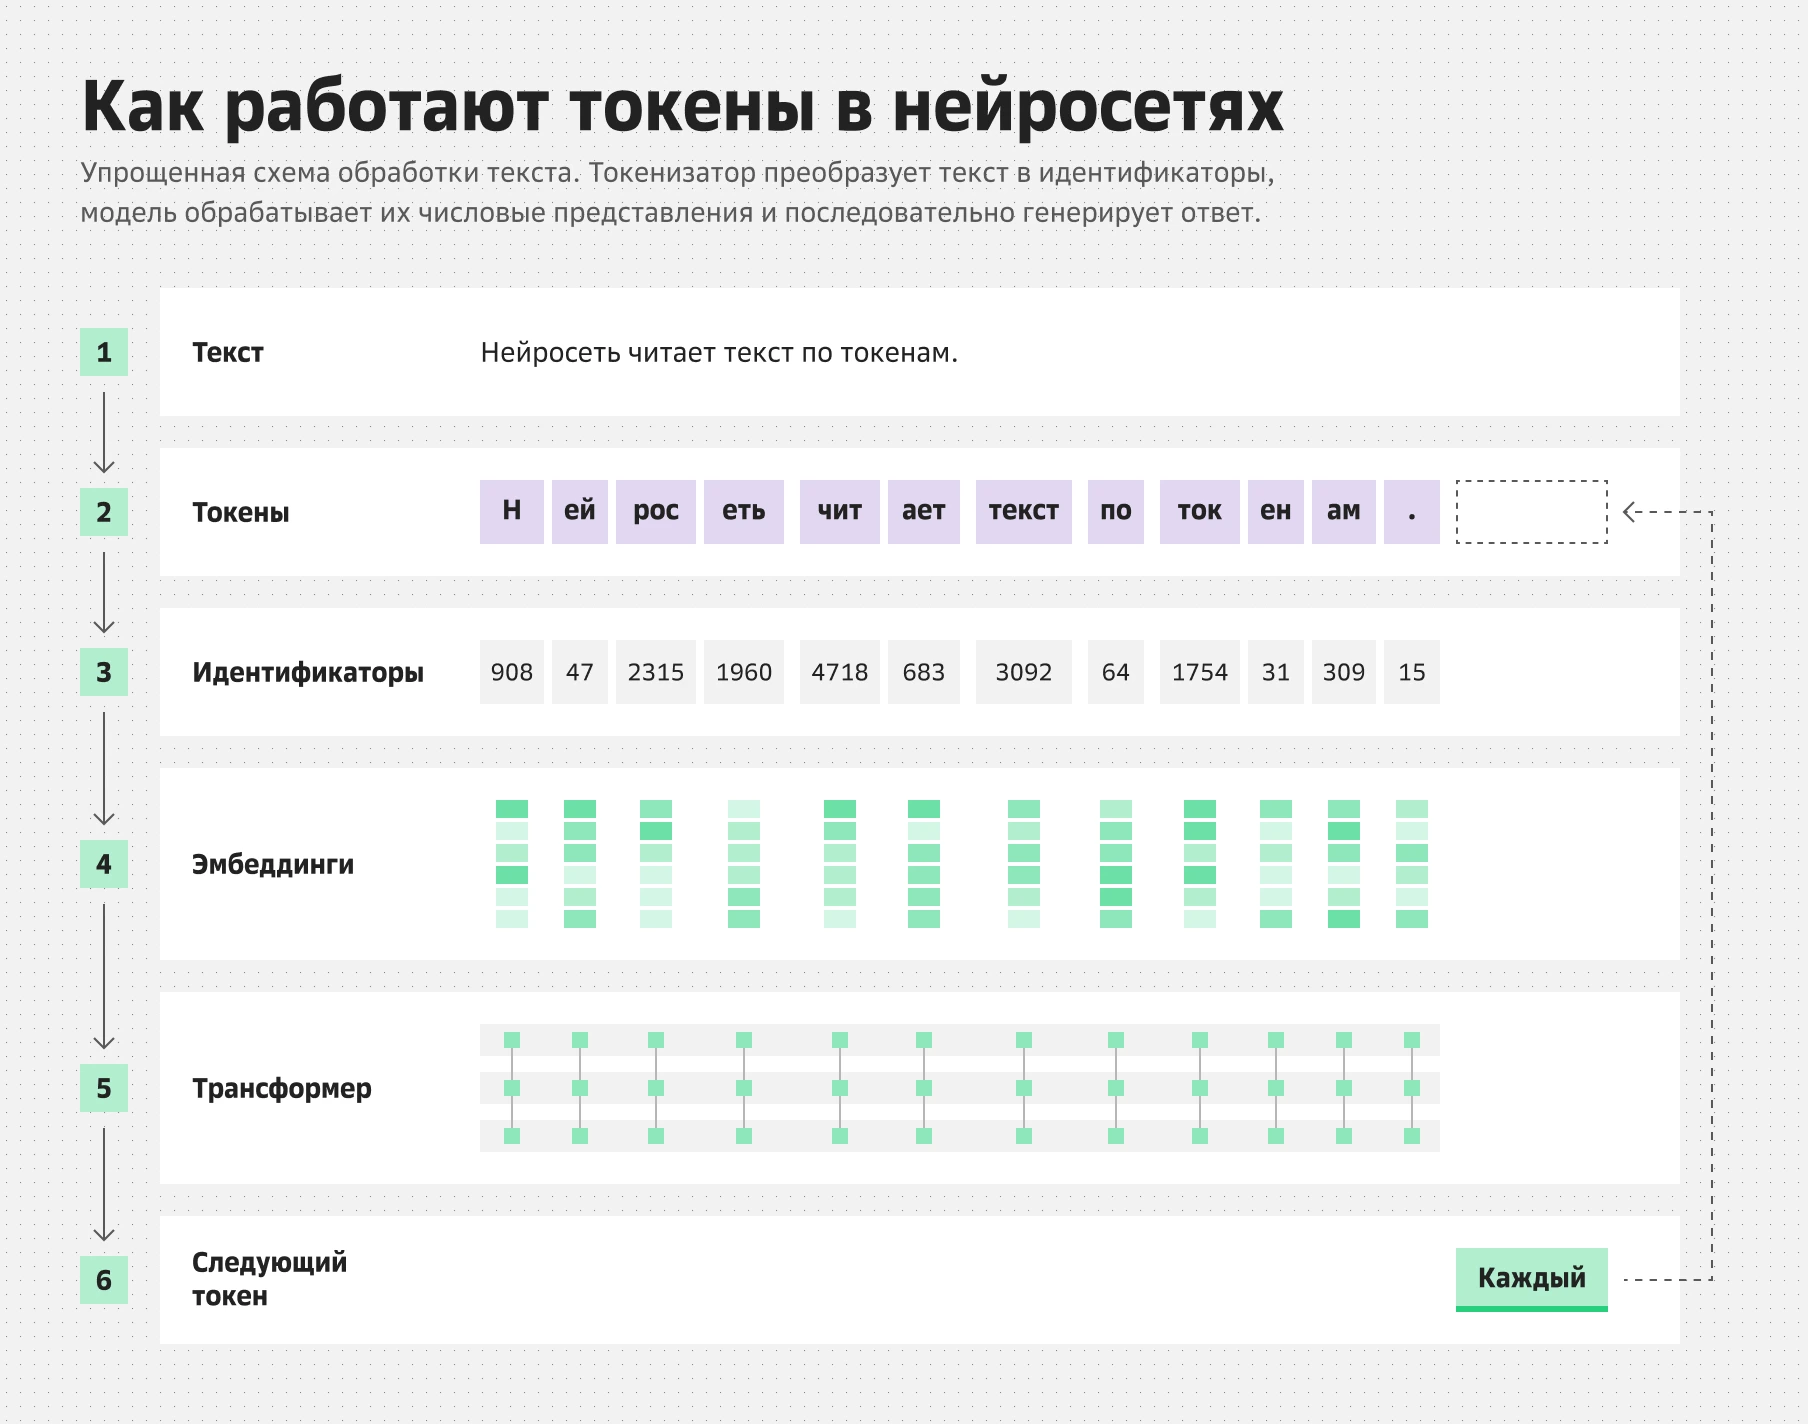 Работа токенов в нейросетях
Сколько токенов в тексте
Количество токенов в одном и том же тексте зависит от языка и токенизатора конкретной модели. Чтобы показать эту разницу, сравним результаты для Qwen3, DeepSeek-V4-Pro и gpt-oss-120b. В расчетах учитываем только текст, без служебных токенов и шаблона диалога. У других моделей и версий токенизаторов результаты могут отличаться.
Сколько токенов в слове на русском и английском
Даже слова с одинаковым значением могут занимать разное количество токенов в зависимости от языка. Например, в выбранных моделях английское token разбивается на один токен, а русское «токен» — на два или три.
При этом длина слова не всегда определяет количество токенов. Например, слово «здравствуйте» состоит из двух токенов в gpt-oss-120b и пяти — в DeepSeek-V4-Pro.
Слово | Qwen3 | DeepSeek-V4-Pro | gpt-oss-120b |
токен | 2 | 2 | 3 |
нейросеть | 3 | 3 | 3 |
токенизация | 4 | 3 | 4 |
здравствуйте | 4 | 5 | 2 |
token | 1 | 1 | 1 |
tokenization | 2 | 2 | 2 |
Сколько символов в токене? Универсального ответа нет: результат зависит от языка и токенизатора. Правило «около четырех символов на токен» подходит для приблизительной оценки английского текста. Русский текст в среднем требует больше токенов на то же количество слов, чем английский, однако разрыв сильно зависит от токенизатора и предметной области. Для специализированных моделей с расширенным русскоязычным словарем разница может быть меньше; для моделей с преимущественно англоязычным корпусом — больше. Для предварительного расчета можно ориентироваться на два токена на русское слово, но точное значение лучше проверять с помощью токенизатора.
Код, таблицы и JSON: как формат влияет на число токенов
При обработке кода и структурированных данных количество токенов зависит не только от содержания, но и от формата записи. На результат влияют кавычки, разделители, пробелы, переносы строк, повторяющиеся названия полей и числа.
Разные модели могут по-разному разбивать числовые значения. Например, токенизатор Qwen3, как и Gemma, кодирует каждую ASCII-цифру (0–9) отдельным токеном. DeepSeek-V4-Pro и gpt-oss-120b могут объединять несколько цифр в один токен. Поэтому в таблицах с ценами, идентификаторами и другими числовыми данными расход токенов может заметно различаться. Конкретный результат зависит от версии токенизатора и содержимого данных.
На количество токенов влияет и формат хранения данных. Например, таблица заказов на 50 строк в формате CSV занимает 1800–2700 токенов, а в JSON с отступами — 4000–4900. В JSON повторяются названия полей, а пробелы и переносы строк увеличивают объем текста. Поэтому один и тот же набор данных может требовать разного количества токенов в зависимости от формата.
В мультимодальных моделях изображения тоже могут учитываться при расчете расхода. Количество токенов зависит от модели, разрешения изображения и настроек детализации. Поэтому определить расход только по размеру файла не получится.
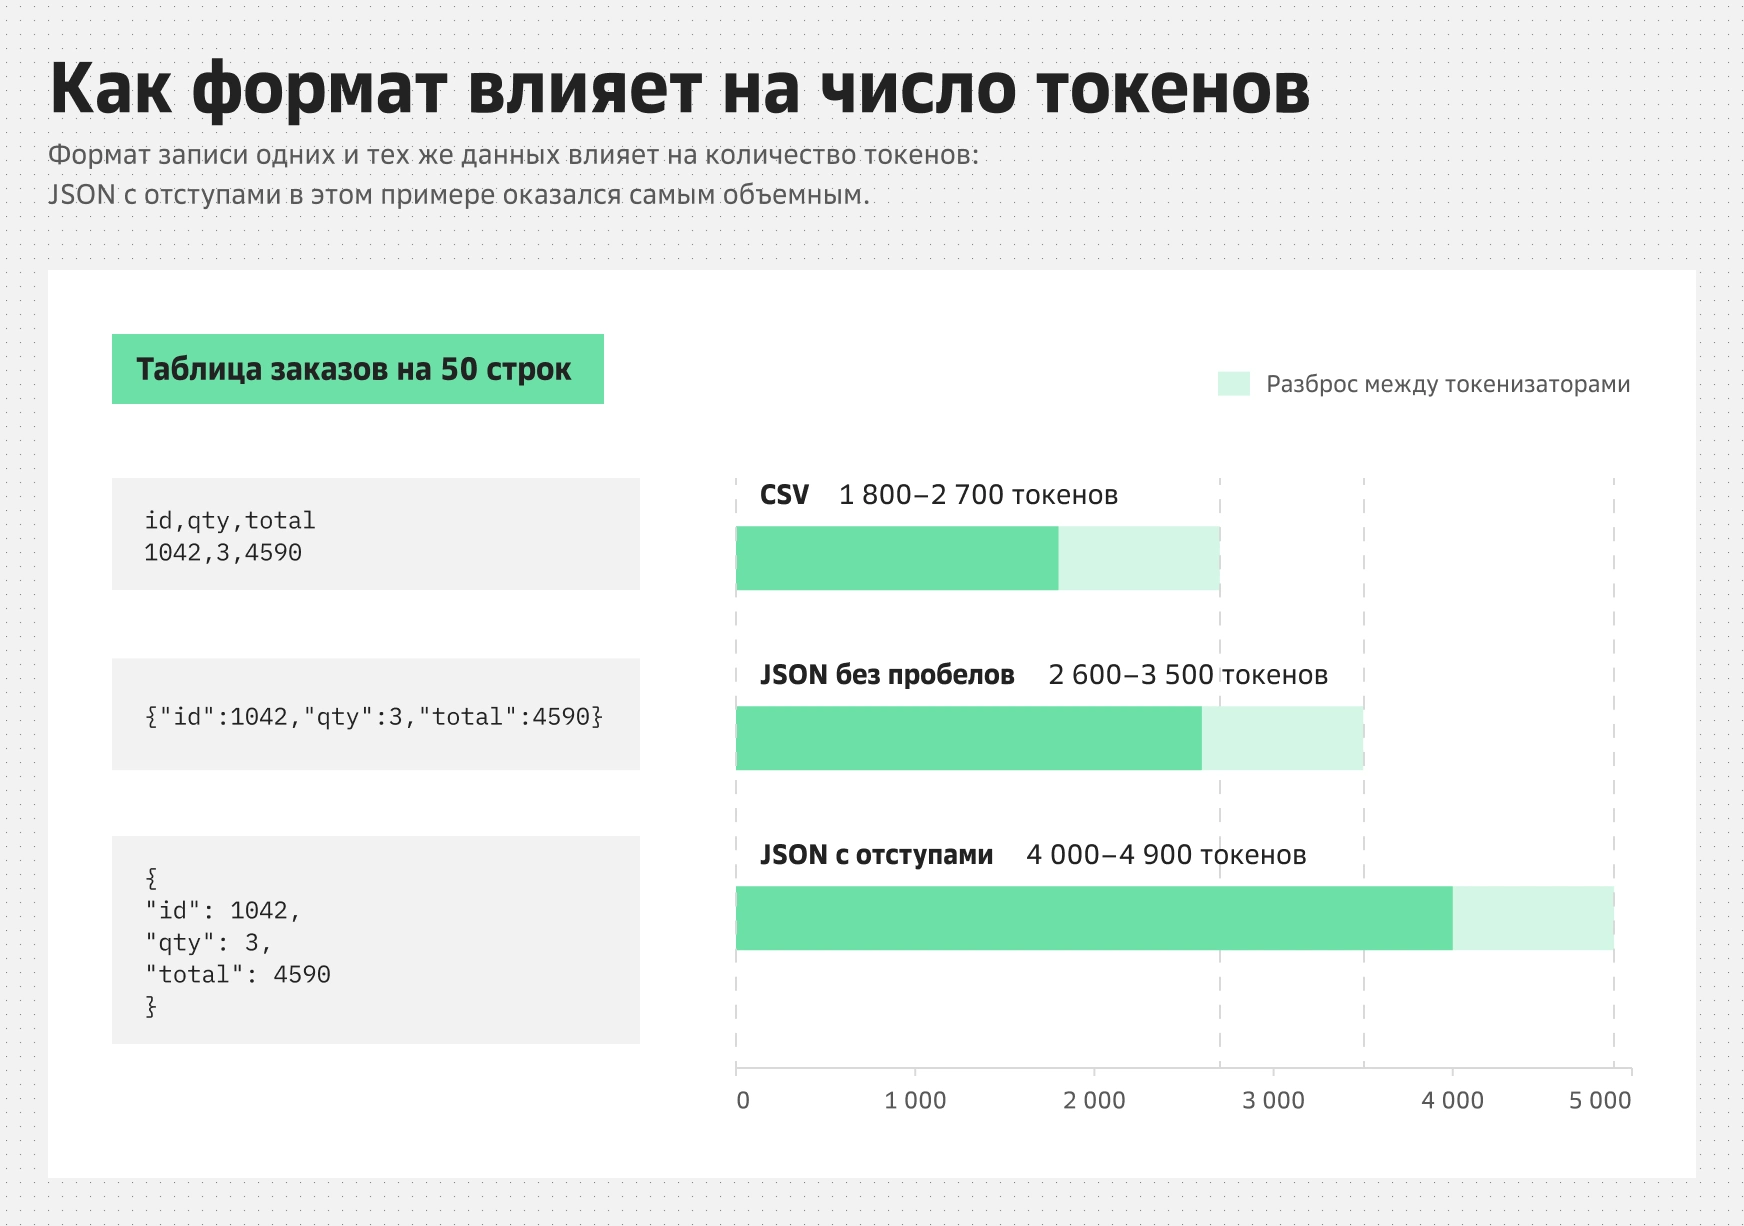 Влияние числа токенов на формат записи
Как посчитать токены: счетчики и калькуляторы
Точнее всего посчитать токены до отправки запроса позволяет токенизатор выбранной модели. Для открытых моделей его можно запустить через библиотеку transformers, для моделей OpenAI доступна библиотека tiktoken. Онлайн-счетчик токенов удобен для быстрой проверки, но нужно убедиться, что он использует подходящий словарь: результаты разных калькуляторов токенов могут отличаться.
После выполнения запроса фактический расход можно посмотреть в поле usage ответа API. В OpenAI-совместимом Chat Completions обычно используются поля prompt_tokens и completion_tokens — для входных и выходных токенов соответственно. Если сохранять эти значения, можно оценить расход для своих сценариев точнее, чем по усредненным коэффициентам.
Для первоначального расчета также можно использовать результаты тестов на типовых данных:
Данные | Объем | Токены |
Короткий вопрос в поддержку | 64 | 14–19 |
Деловое письмо | 868 символов | 220–300 |
Страница договора | 1 596 символов | 460–580 |
100 строк кода на Python | 3 382 символа | 720–800 |
Таблица на 50 строк в CSV | 3 621 символ | 1 800–2 700 |
Входные токены — это содержимое запроса к модели: системный промпт, история диалога, вопрос пользователя и переданные документы. Выходные токены появляются при генерации ответа.
Почему выходные токены дороже входных
Входные и выходные токены требуют от модели разных вычислений. Когда нейросеть получает запрос, она одновременно обрабатывает его части: системные инструкции, историю переписки и вопрос пользователя. Этот этап называется prefill. Благодаря параллельным вычислениям модель может относительно быстро обработать даже большой объем входного текста.
Генерация ответа устроена иначе. Модель предсказывает токены по одному: сначала следующий фрагмент, затем следующий с учетом уже сформированного текста. Для ускорения этого процесса модель сохраняет промежуточные результаты вычислений в специальной памяти — KV-cache. Однако по мере увеличения контекста растет и объем этой памяти, а каждый новый токен требует отдельного вычислительного шага. Поэтому генерация может занимать больше времени и ресурсов.
Этим отчасти объясняется разница в тарифах: у многих провайдеров выходные токены стоят в 2–6 раз дороже входных. Например, для DeepSeek-V4-Pro в Cloud.ru 1 млн выходных токенов стоит 732 ₽, а 1 млн входных — 183 ₽. Таким образом, генерация ответа обходится в четыре раза дороже обработки запроса.
Это не универсальное правило: соотношение зависит от модели, ее архитектуры и тарифной политики провайдера. У некоторых моделей стоимость входных и выходных токенов может быть одинаковой или отличаться незначительно.
Токены рассуждений в thinking-моделях
Thinking-модели могут генерировать промежуточные рассуждения перед окончательным ответом. На сложных задачах их объем иногда превышает длину видимого текста. Эти дополнительные токены обычно тарифицируются как выходные, даже если пользователь не видит сам процесс. В ответе API они, как правило, уже включены в общий расход на генерацию, поэтому прибавлять их повторно не нужно.
Режим рассуждений полезен в задачах, требующих последовательного анализа: например, при проверке договоров, сложных расчетах или поиске ошибок в коде. Для таких сценариев в Cloud.ru доступна модель GigaChat 3.5 Reasoning. При простых справочных запросах дополнительные рассуждения могут быть избыточными.
Как рассчитать стоимость запроса: формула и пример
При работе с нейросетью через API пользователь платит за обработку входных данных и генерацию ответа. Стоимость рассчитывается по количеству токенов, причем для входных и выходных данных могут действовать разные тарифы. Обычно провайдеры указывают цену за миллион токенов.
Например, для DeepSeek-V4-Pro в Cloud.ru 1 млн входных токенов стоит 183 ₽, а 1 млн выходных — 732 ₽. Чтобы рассчитать стоимость запроса, нужно умножить количество входных и выходных токенов на соответствующие тарифы и сложить полученные значения.
Стоимость = (входные токены × цена за 1 млн входных + выходные токены × цена за 1 млн выходных) / 1 000 000
Рассмотрим пример чат-бота поддержки. Для одного запроса модель получает:
системный промпт — 600 токенов;
историю диалога — 1 200 токенов;
вопрос пользователя — 50 токенов.
Всего на входе получается 1 850 токенов. Ответ модели занимает еще 250 токенов.
По тарифам Evolution Foundation Models на ноябрь 2026 года 1 млн входных токенов DeepSeek-V4-Pro стоит 183 ₽, а 1 млн выходных — 732 ₽.
Рассчитаем стоимость отдельно для входных и выходных данных:
Обработка запроса: 1 850 × 183 / 1 000 000 ≈ 0,34 ₽.
Генерация ответа: 250 × 732 / 1 000 000 ≈ 0,18 ₽.
Итого один запрос обходится примерно в 0,52 ₽. Если чат-бот обрабатывает 30 000 таких запросов в месяц, расходы составят около 15 647 ₽.
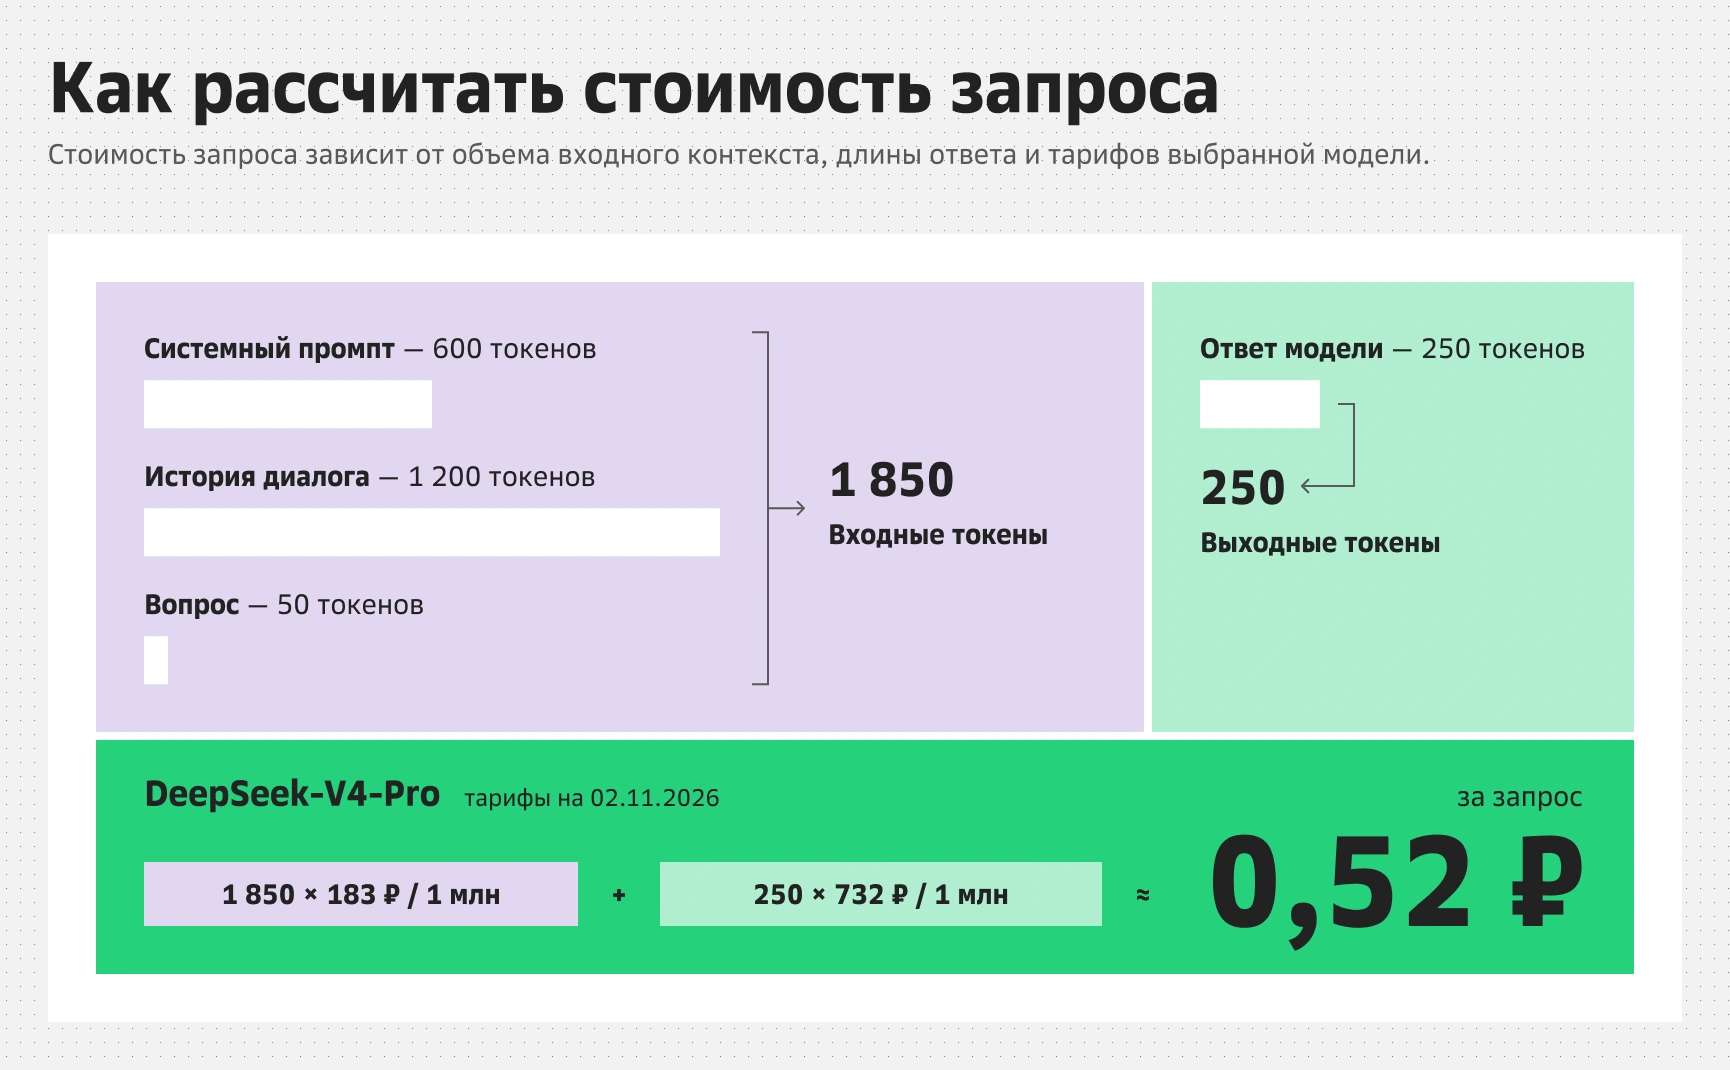 Расчет стоимости запроса
Лимиты токенов: что ограничивает длину запроса и ответа
Контекстное окно определяет, сколько входных и выходных токенов модель может обработать в рамках одного запроса. Например, у gpt-oss-120b оно составляет 131 072 токена, а у DeepSeek-V4-Pro — 1 048 576 (около 1 млн). При этом фактический лимит зависит от провайдера: API может поддерживать меньше токенов, чем заявлено для модели. Кроме того, в контекстное окно входят не только запрос пользователя, но и системные инструкции, история переписки и ответ модели.
Максимальную длину ответа задают параметры max_tokens или max_completion_tokens. Если модель достигает установленного предела, генерация прекращается, даже если ответ еще не завершен.
Еще одно ограничение — rate limit: максимальное количество запросов или токенов, которое API может обработать за определенное время. Если приложение отправляет слишком много обращений, часть из них может быть отклонена. Чтобы избежать перегрузки, используют очереди запросов и повторные попытки с задержкой.
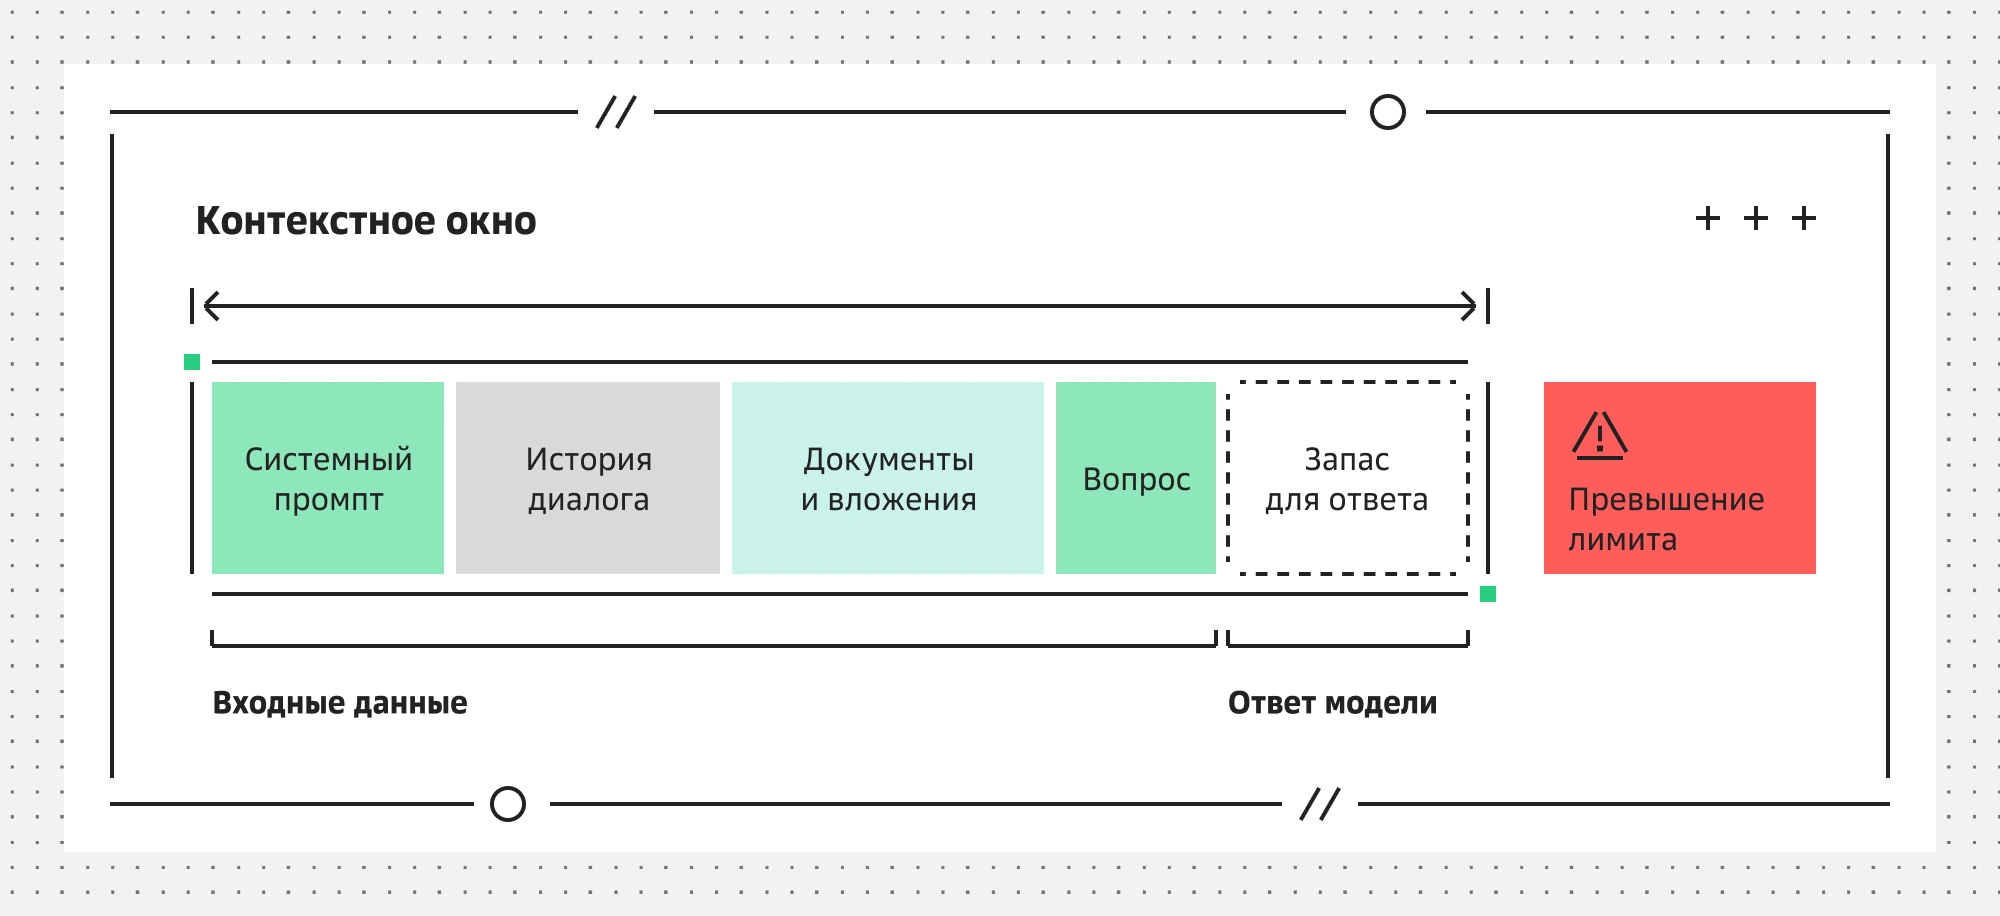 Контекстное окно
Как сэкономить токены
Рассмотрим чат-бота поддержки. Если сократить системный промпт с 600 до 300 токенов, а историю диалога — с 1 200 до 400, расчетные месячные расходы снизятся примерно на 39% при прежней длине ответа.
Есть несколько способов добиться такой экономии:
Сокращайте системный промпт. Убирайте повторяющиеся инструкции, избыточные пояснения и примеры, которые не влияют на качество ответа. В типовом API-приложении системный промпт передается при каждом запросе, поэтому даже небольшое сокращение дает заметную экономию при высокой нагрузке.
Сжимайте историю диалога. Необязательно каждый раз передавать модели всю переписку. Можно сохранять последние реплики, а предыдущую часть разговора заменять кратким пересказом с важными фактами и договоренностями.
Используйте кеширование промпта, если модель и API поддерживают такую возможность. Повторяющиеся инструкции лучше размещать в начале запроса и настраивать кеширование согласно требованиям провайдера. Само количество передаваемых токенов при этом не сокращается, но их повторная обработка может стоить дешевле.
Выбирайте модель с учетом сложности задачи. Для классификации обращений, извлечения данных или коротких справочных ответов может быть достаточно небольшой LLM с более низкими тарифами. При выборе стоит сравнивать качество и стоимость на собственных запросах. Разобраться в особенностях разных моделей поможет обзор нейросетей.
Передавайте конкретные фрагменты документов с помощью RAG. Система находит сведения, относящиеся к вопросу, и добавляет их в запрос вместо полного документа. Например, в условном расчете договор на 50 страниц занимает около 25 000 токенов, а три найденных фрагмента — около 1500. При этом нужно учитывать дополнительные расходы на индексацию, поиск и хранение данных.
Токены в Evolution Foundation Models
Evolution Foundation Models — сервис цифровой среды AI Factory, который предоставляет доступ к популярным языковым моделям через OpenAI-совместимый API. В каталоге можно сравнить модели по стоимости обработки запросов, размеру контекстного окна и поддерживаемым функциям, включая рассуждения и вызов внешних инструментов.
Сервис работает по модели pay-as-you-go, то есть с оплатой по факту использования. Для текстовых запросов стоимость зависит от количества входных и генерируемых токенов. Для кеширования и обработки других типов данных могут действовать отдельные ставки.
Заключение
Токены — это фрагменты текста, с которыми работает языковая модель. Их количеством измеряют объем запроса и ответа, а при использовании API рассчитывают стоимость. Один и тот же по смыслу текст может занимать разное число токенов в зависимости от языка и модели. Код, JSON и история переписки также влияют на общий расход.
Чтобы оценить затраты на ИИ, проверяйте количество токенов в реальных запросах, отдельно учитывая входные и выходные токены. Сокращайте повторяющиеся инструкции, сжимайте историю диалога и передавайте только нужные фрагменты документов. При выборе LLM сравнивайте не только тарифы, но и итоговую стоимость выполнения задачи.
FAQ
Что такое токен в нейросети простыми словами?
Токен — это фрагмент текста, с которым работает языковая модель. Им может быть целое слово, его часть, знак препинания или отдельный пробел. В токенах измеряют объем запросов и ответов, а также рассчитывают стоимость использования API.
Сколько токенов в одном слове на русском языке?
Количество зависит от слова и токенизатора модели. Для приблизительной оценки русского текста можно использовать ориентир около двух токенов на слово. При этом короткие слова могут занимать один токен, а длинные и редкие — пять и больше.
Почему русский текст часто занимает больше токенов, чем английский?
Токенизаторы используют словари наиболее распространенных фрагментов текста, которые различаются для разных языков. Русские слова нередко разбиваются на большее число частей, чем сопоставимые английские. Точная разница зависит от модели и содержания запроса.
Чем входные токены отличаются от выходных?
Входные токены включают системный промпт, историю диалога, вопрос пользователя и переданные документы. Выходные — это все, что модель генерирует при ответе, включая дополнительные рассуждения у thinking-моделей. Генерация обычно стоит дороже обработки входного текста.
Как посчитать, сколько токенов в тексте?
До отправки запроса используйте токенизатор выбранной модели или совместимый онлайн-счетчик. После обращения фактический расход можно посмотреть в поле usage ответа API.
Сколько стоит 1 млн токенов?
Единой цены нет: стоимость зависит от модели, провайдера и типа токенов. Для входных и генерируемых обычно действуют разные тарифы, а для кешированных данных могут быть отдельные ставки.
Как сэкономить токены?
Сокращайте системный промпт, сжимайте историю диалога, ограничивайте длину ответа и передавайте только нужные фрагменты документов через RAG. Кеширование промпта и выбор более дешевой модели также помогают снизить расходы на API, хотя не обязательно уменьшают количество обрабатываемых токенов.