AI-IDE: как ИИ работает с контекстом кодовой базы
Искусственный интеллект (ИИ) в IDE умеет не только дописывать код в открытом файле. Современные AI-IDE могут искать связанные файлы, учитывать зависимости, менять код в нескольких частях проекта и запускать проверки. Разбираемся, как они собирают контекст кодовой базы, чем отличаются индексация, длинное контекстное окно и агентный подход, и какие инструменты доступны российским командам.


AI-IDE — это только часть системы: на результат влияет и модель, которая стоит за инструментом. Поэтому при выборе решения имеет смысл смотреть не только на саму среду разработки, но и на то, какие модели к ней можно подключить и как они справляются с реальными задачами.

Что значит «понимать контекст кодовой базы»
AI-IDE (Integrated Development Environment) — это продвинутая среда разработки со встроенными ИИ-агентами и ассистентами, готовыми выполнять задачи разработчиков. Ее можно назвать программой-помощником для создания приложений.
Чтобы качественно выполнять свои функции, AI-IDE должна самостоятельно находить участки проекта, связанные с поставленной задачей. Это и есть понимание контекста кодовой базы.
Например, разработчики поручают изменить способ авторизации в приложении. Для этого недостаточно найти файл, где реализована функция входа. AI-IDE должна определить, какие компоненты затронет эта логика: допустим, middleware, API, модели пользователей и связанные тесты. Если изменения касаются нескольких компонентов, программа должна связать их между собой и предложить правки с учетом всех зависимостей.
Иногда разработчики пытаются сгладить возможные проблемы, загружая в контекст репозиторий целиком. Для больших проектов это неэффективно: программе придется обработать весь код, хотя значительная его часть не относится к поставленной задаче. Важно, чтобы AI-IDE сама находила нужные файлы и зависимости и передавала ИИ-агентам только релевантный контекст.
Уровни контекста: файл → открытые вкладки → индекс репозитория → граф зависимостей → история изменений
Чем больше контекста доступно AI-IDE, тем точнее будут учитываться структура проекта и последствия изменений. Есть несколько уровней:
Файл — инструмент видит содержимое открытого файла. Его достаточно для простого автодополнения кода и поиска ошибок.
Открытые вкладки — в контекст попадают несколько файлов, над которыми разработчик трудится одновременно. Это помогает учитывать связанные функции, классы данных и импорты.
Индекс репозитория — AI-IDE индексирует кодовую базу, по смыслу и ключевым словам ищет нужные фрагменты. В этом помогают эмбеддинги и RAG по коду.
Граф зависимостей — инструмент строит связи между модулями, функциями и классами данных. Это важно при многофайловом рефакторинге.
История изменений — система учитывает прошлые коммиты и изменения в коде. Это помогает понять, почему проект устроен именно так.
Чем выше уровень контекста, тем больше данных может учитывать AI-IDE в работе с кодом. Для простых задач обычно хватает одного файла или нескольких вкладок. Рефакторинг требует индекса репозитория, анализа зависимостей и дополнительной информации о связях. Причем важен не столько объем контекста, сколько правильный выбор информации из всей доступной.
Где ломается понимание: неявные зависимости, генерируемый код, монорепозитории на миллионы строк
Даже если у ИИ для написания кода есть доступ ко всему репозиторию, программа может не видеть некоторые связи. Особенно это заметно в масштабных проектах с большим количеством компонентов. Типичные проблемы:
Неявные зависимости. Изменение одного поля может затронуть базу данных, API и фронтенд, хотя прямой связи между компонентами в коде нет.
Генерируемый код. Некоторые инструменты разработки автоматически создают исходники, которые ложатся в основу кода. IDE должна понять, что менять нужно их, а не последующие файлы.
Микросервисы. Нужная логика может находиться в другом сервисе или общей библиотеке. Без поиска по связанным компонентам IDE увидит только часть цепочки.
Большие монорепозитории. Система передает модели много лишнего кода, из-за чего та путается в контексте и хуже выполняет задачи.
В перечисленных случаях недостаточно индексации репозитория — AI-IDE должна точно понимать, куда смотреть и что искать для конкретной задачи. Это отличает работу с кодовой базой от простого поиска нужного фрагмента кода.
Три подхода к контексту: индексация, длинное окно, агентный обход
Система может собирать контекст по-разному. Рассмотрим сценарии с примерами.
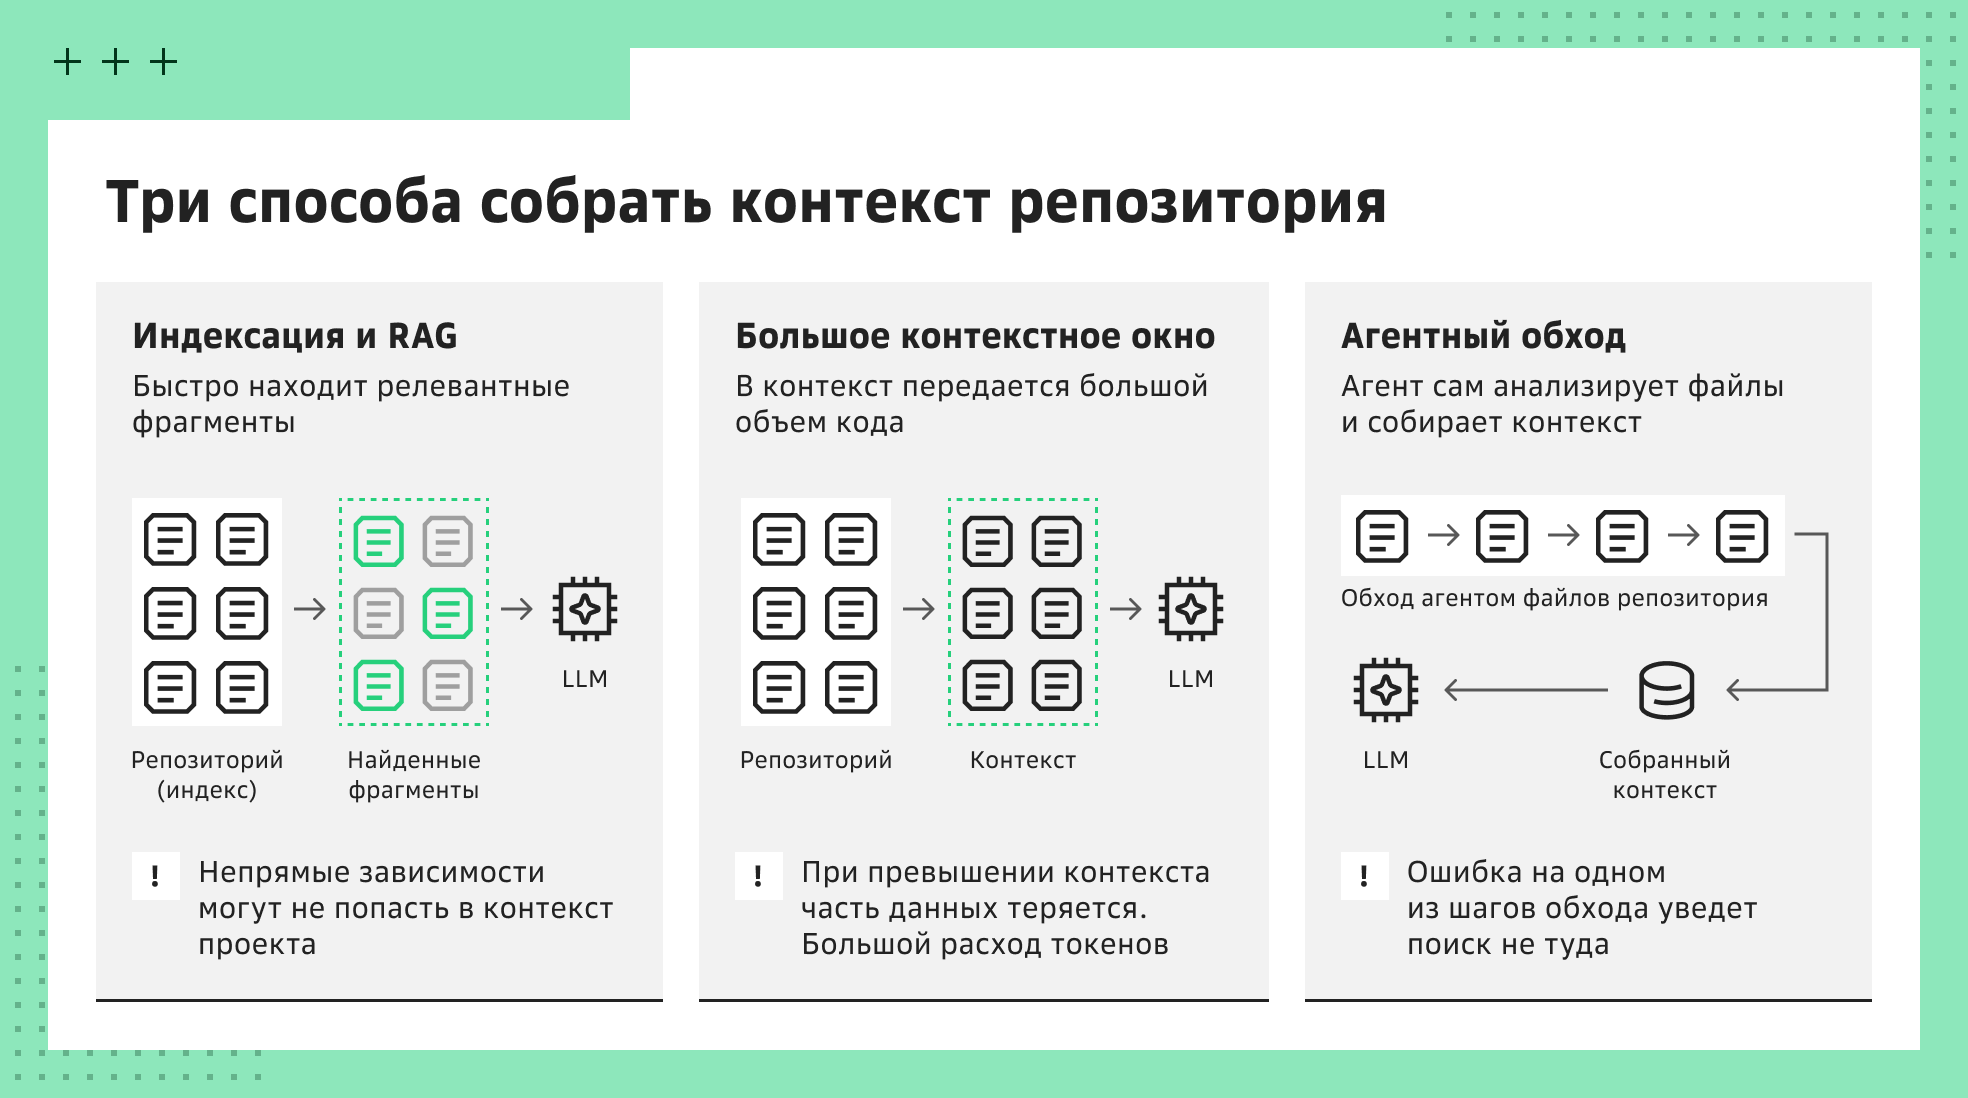 Способы сборки контекста репозитория
Индексация и RAG по коду: быстро, но извлекается только «похожее», а не «связанное»
Сначала индексируется кодовая база, затем по запросу отбираются наиболее релевантные фрагменты. Например, разработчик спрашивает о вызове конкретного метода. Система ищет в коде участки, семантически связанные с запросом и передает модели.
Преимущество этого подхода в скорости, поскольку условия поиска сужают область контекста. Однако проблема может возникнуть, если нужная информация распределена по нескольким файлам и не связана напрямую. Вернемся к примеру про вызов функции. По поиску получится найти нужный участок кода, но есть риск не учесть конфигурацию, тесты, внешние сервисы.
Длинное контекстное окно: до миллиона токенов в одном запросе — цена, задержка, деградация внимания
Под контекстным окном понимают максимальный объем данных, который модель может учесть для одного запроса. Например, это фрагменты кода, сообщения из переписки, инструкции, результаты предыдущих действий. Размер окна измеряется в токенах, например, 128K, 256K или 1M.
Длинное контекстное окно удобно для работы AI-IDE с кодовой базой, поскольку можно поместить больше связанных между собой файлов. Так системе будет проще находить зависимость в одном контексте.
У подхода есть три серьезных минуса:
Высокая вычислительная нагрузка и возможные задержки ответов.
Повышение стоимости обработки запросов при регулярной работе с большими контекстами.
Деградация внимания модели из-за огромного массива данных.
То есть технически модель может получить миллион токенов, если это позволяет контекстное окно. Однако не факт что она будет учитывать каждый нужный фрагмент. В больших массивах важные строки и связи могут затеряться среди тысяч нерелевантных участков. Поэтому возможность получать много информации еще не означает качественную работу.
Агентный обход: инструмент сам читает файлы, запускает тесты и собирает контекст по ходу задачи
В этом сценарии не нужно загружать весь репозиторий. Модель получает доступ к разным инструментам, например, поиску по файлам, чтению кода, запуску тестов и др. В зависимости от задачи она сама определяет, какие данные получать и на каком шаге.
Представим, что разработчик просит систему исправить ошибку в обработке платежа. ИИ-агент находит проблемную функцию, открывает нужный участок кода и видит вызов стороннего сервиса. Он переходит к нему, проверяет конфигурацию и компоненты, запускает тесты. Если проблема не в сервисе, агент откатывается обратно и продолжает поиск.
Агентный обход особенно полезен в проектах, где настолько много данных, что они не помещаются даже в длинное контекстное окно. Минус — дополнительные шаги и задержки ответов, поскольку агенту приходится последовательно смотреть файлы, выполнять команды и проверять результаты. К тому же, есть риск, что ошибка на одном из этапов уведет поиск не туда.
Обзор инструментов
Российским командам доступны зарубежные и отечественные решения с разным функционалом. Ниже — наиболее популярные.
Cursor AI
Cursor индексирует репозиторий и использует семантический поиск. Он видит не только файл, над которым трудится разработчик, но и понимает контекст кодовой базы. Также у него есть агентные возможности, но они работают иначе, чем «агентный обход» в Claude Code: Cursor опирается на индекс репозитория и инструменты через LSP, а не на последовательное чтение файлов агентом.
Постоянные правила проекта задаются в .cursor/rules (файлы .mdc). При этом файл AGENTS.md Cursor автоматически не подхватывает — для этого нужна отдельная настройка, поэтому как штатный механизм правил его указывать не стоит.
В Cursor можно выбирать модели разных провайдеров. Состав доступных зависит от региона. Вот тут сложность — в России часть моделей и функций ограничены.
Windsurf
Windsurf — это ИИ-ассистент для написания кода, который сохраняет связный контекст сессии и может подряд выполнять несколько действий, например, искать нужные фрагменты, менять их, проверять результаты и исправлять ошибки. С ним удобно работать командам, поскольку можно задать для проекта общие правила (rules-файлы) с учетом требований к структуре приложения.
Можно потестировать Windsurf бесплатно, пусть и с урезанным функционалом. Однако свободной версии достаточно, чтобы оценить преимущества в части управления локальными и облачными задачами разработчиков. MCP поддерживается через Cascade, но с ограничениями: до 100 инструментов и до 25 вызовов инструментов за один промпт.
Claude Code
Claude Code — это терминальный агент с длинным контекстом. Умеет читать и изменять файлы, выполнять команды, самостоятельно запускать проверки. Работает в трех средах — Local, Cloud и Remote Control. В Local действия выполняются на локальной машине с подтверждением пользователя. В Cloud — сессии запускаются на инфраструктуре Anthropic или на self-hosted runner'ах; поддерживаются проекты с несколькими репозиториями и потоками. Контекстное окно — до 1M токенов для моделей, где это поддерживается.
Агент также умеет делегировать задачи субагентам. Например, один может исследовать структуру проекта, другой — проверять участки кода, третий — анализировать тесты. Такой сценарий подходит для больших рефакторингов и задач, которые для скорости нужно разделить на независимые этапы.
GigaCode и GigaIDE
GigaCode — российский ИИ-ассистент, который можно установить как дополнение к VS Code и IDE от JetBrains или использовать вместе с GigaIDE. Он умеет искать и анализировать файлы, учитывать результаты предыдущих действий, искать ошибки, проводить рефакторинг. Поддерживает агентный режим: ассистент может искать файлы, вносить изменения и запускать проверки. Механизм постоянных правил реализован через Rules: проектные правила хранятся в <project-root>/.gigacode/rules/ и версионируются вместе с кодом, глобальные — в ~/.gigacode/rules/.
GigaCode — проприетарное решение Сбера, работающее на его инфраструктуре. Агентный режим позволяет выполнять команды, работать с файлами и git. GigaCode CLI может разворачиваться on-premise. Через интеграцию с AI Factory доступно подключение более 20 LLM-моделей. А MCP-подключения позволяют работать с внешними системами, включая Jira и другие сервисы.
Open source: Continue, Cline — своя модель и свой контур
Continue и Cline — открытые инструменты, которые добавляются в привычную среду разработки и помогают работать с кодом. Главное отличие от готовых AI-IDE — возможность выбрать модель для использования в облаке или своем контуре. Такой подход дает больше контроля над кодом и данными. К тому же, инструменты можно адаптировать под существующие процессы разработки и подключить к используемой инфраструктуре.
AI-IDE | Сбор контекста | Максимальный контекст | Агентный режим | MCP | Своя модель | Оплата в РФ | Приватность кода |
Cursor | Индекс и поиск по репозиторию | до 1M токенов | ✅ | ✅ | Через API/BYOK | Есть региональные ограничения | Облачная обработка, настройки приватности |
Windsurf | Индексация и контекст сессии | Зависит от модели | ✅ | ✅ | Через подключаемые модели | Зависит от региона | Облачная обработка |
Claude Code | Агентный режим | до 1M токенов | ✅ | ✅ | Через API-совместимые модели | Зависит от доступности | Local / Cloud / Remote / Self-hosted |
GigaCode / GigaIDE | Поиск и анализ кодовой базы | Зависит от модели | ✅ | ✅ | Через Cloud.ru (AI Factory) | Есть | Можно использовать российскую инфраструктуру |
Continue | Индексация и поиск по коду | Зависит от модели | ✅ | ✅ | Да | Зависит от модели | Можно настроить свой контур |
Cline | Поиск по репозиторию и агентный обход | Зависит от модели | ✅ | ✅ | Да | Зависит от модели | Можно настроить свой контур |
Как выбрать AI-IDE под свою кодовую базу
Выбор важно делать с учетом масштабов и структуры проекта, требований к работе с исходным кодом.
Небольшой проект, монорепозиторий, легаси на 1С или Java: что работает лучше
Для маленьких проектов обычно достаточно AI-IDE, который умеет работать с открытыми файлами и несколькими связанными модулями. Сложная индексация кодовой базы здесь не нужна — в приоритете качественное автодополнение и быстрые многофайловые правки.
В монорепозитории требования выше. Инструмент должен оперативно искать нужные файлы в общей массе, учитывать зависимости и отбрасывать из контекста нерелевантный код. Требуются индексация репозитория и агентный режим.
Для легаси-проектов на 1С или Java важна работа с существующей архитектурой и зависимостями. Сгенерировать новый фрагмент кода тут недостаточно, поскольку учитываются структура проекта, правила команды, используемые библиотеки, существующие реализации. Нужно, чтобы инструмент понимал конкретный технологический стек и умел безопасно вносить в изменения кодовую базу.
Приватность: какие инструменты отправляют код во внешние API и как это контролировать
Cursor, Claude Code и Windsurf и многие другие инструменты AI-IDE работают с облачными моделями, поэтому часть кода и данных идут на серверы провайдера. Не обязательно передавать весь репозиторий — достаточно контекста для задач. Перед этим важно узнать следующее:
Куда отправляются данные — например, на сервер разработчика AI-IDE или провайдеру модели.
Что нужно передавать — весь проект, отдельные файлы или только контекст
Что будет с данными после обработки — хранятся, удаляются, используются для обучения моделей.
Если передача данных на сторону недопустима, остается вариант с локальной моделью или собственным размещением. Код остается внутри, но команде придется самостоятельно обеспечивать вычислительные ресурсы, настраивать и обслуживать модели.
Модели для AI-IDE из Cloud.ru
Cloud.ru позволяет использовать модели через API, подключать их к готовым инструментам или запускать собственные LLM в облаке.
Evolution Foundation Models
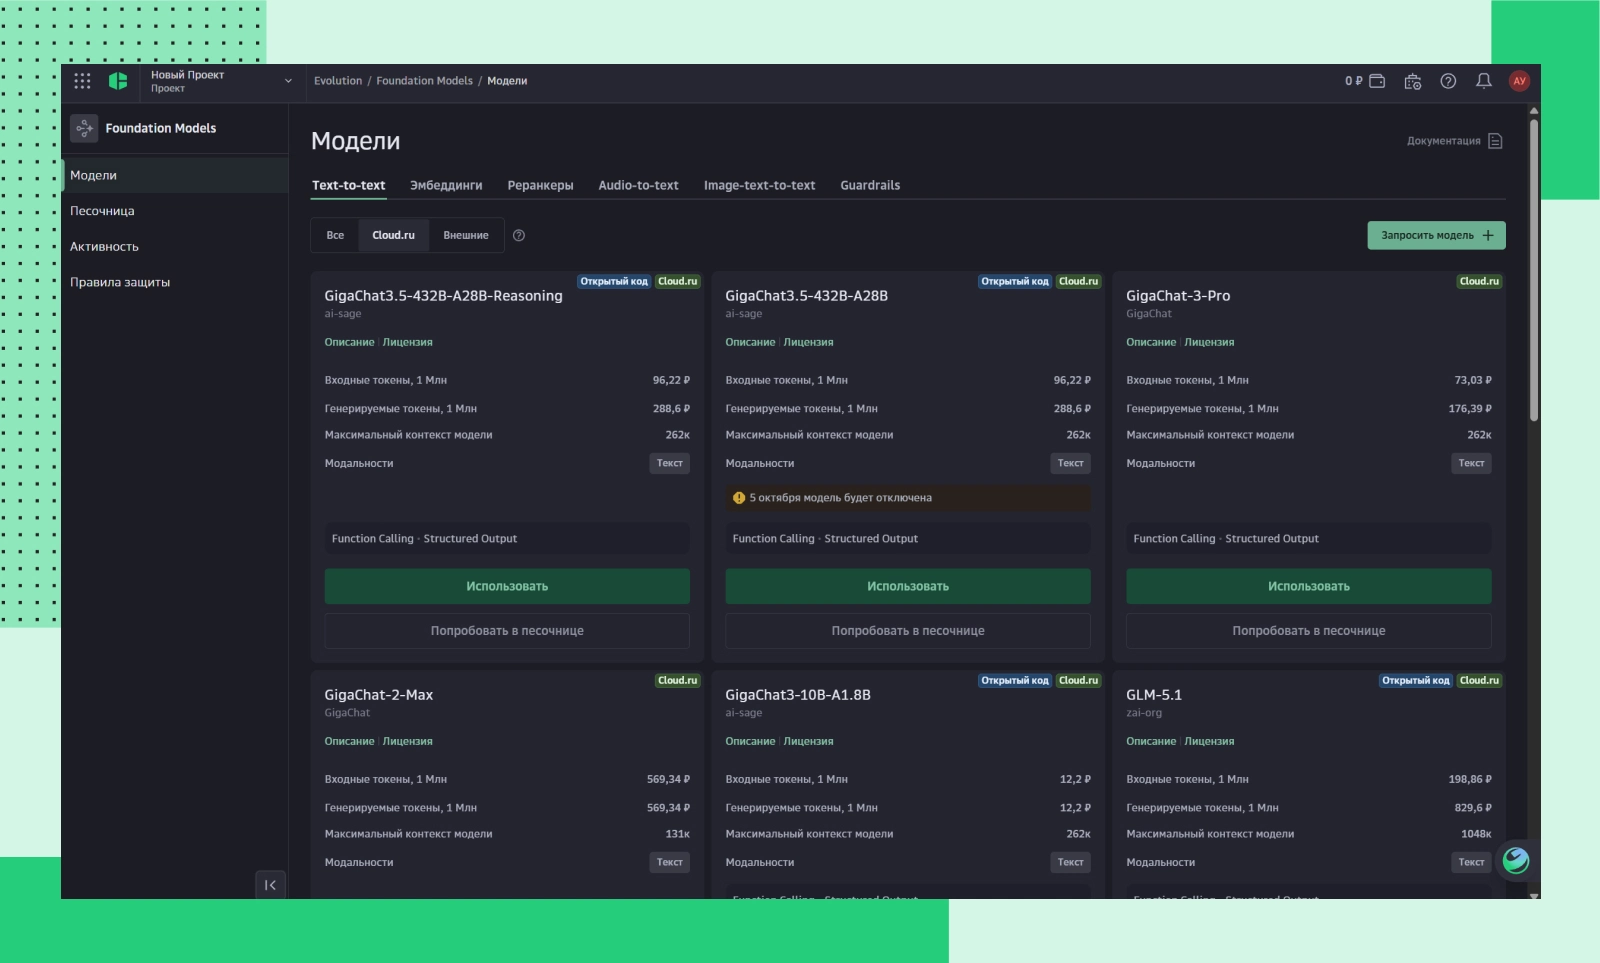 Модели в Evolution Foundation Models
Evolution Foundation Models предоставляет доступ к готовым моделям через API. Они подключаются к Cursor, Continue и другим инструментам. Доступны как популярные модели, в частности, Qwen, DeepSeek и GLM, так и специализированные для работы с кодом.
Сервис предусматривает защиту конфиденциальных данных, которые передаются провайдеру. Например, механизмы Guardrails-фильтрации проверяют запросы и маскируют секреты плейсхолдерами.
GigaCode через GigaIDE
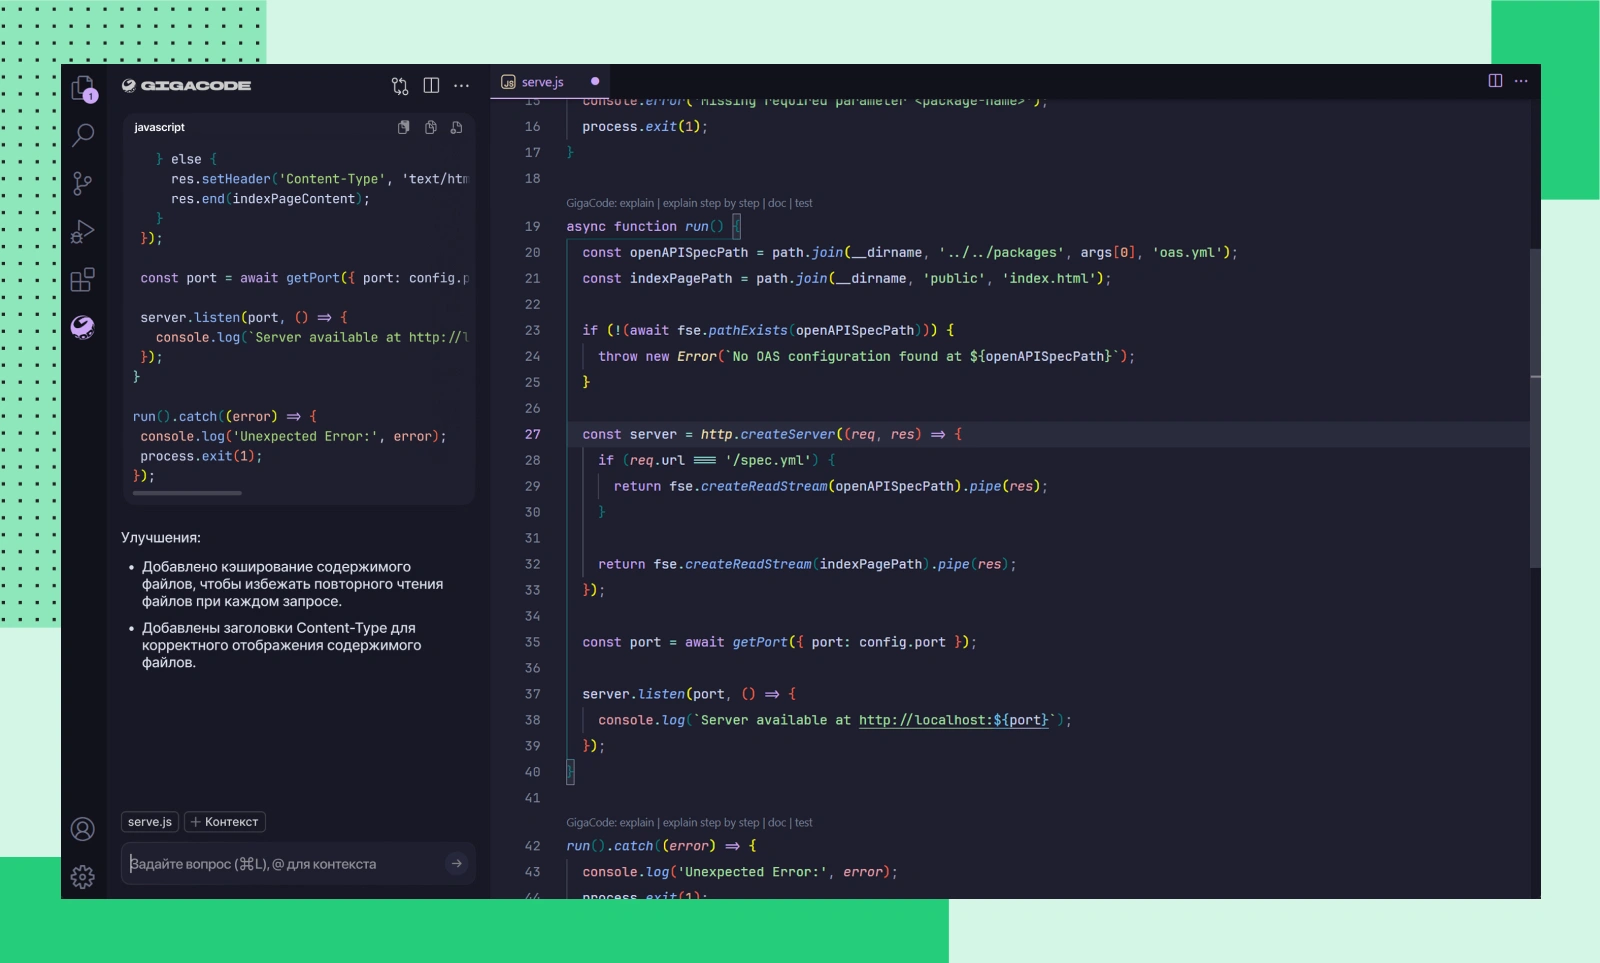 GigaIDE интегрирован с AI Factory
GigaCode через плагин GigaIDE интегрирован с AI Factory. Это позволяет подключать к ассистенту различные LLM с платформы Cloud.ru. Есть возможность использовать инструмент в привычной среде и выбирать подходящие модели под задачу проекта.
Evolution ML Inference — запуск собственной модели для кода и «Агент Python-разработчик» в каталоге Evolution AI Agents
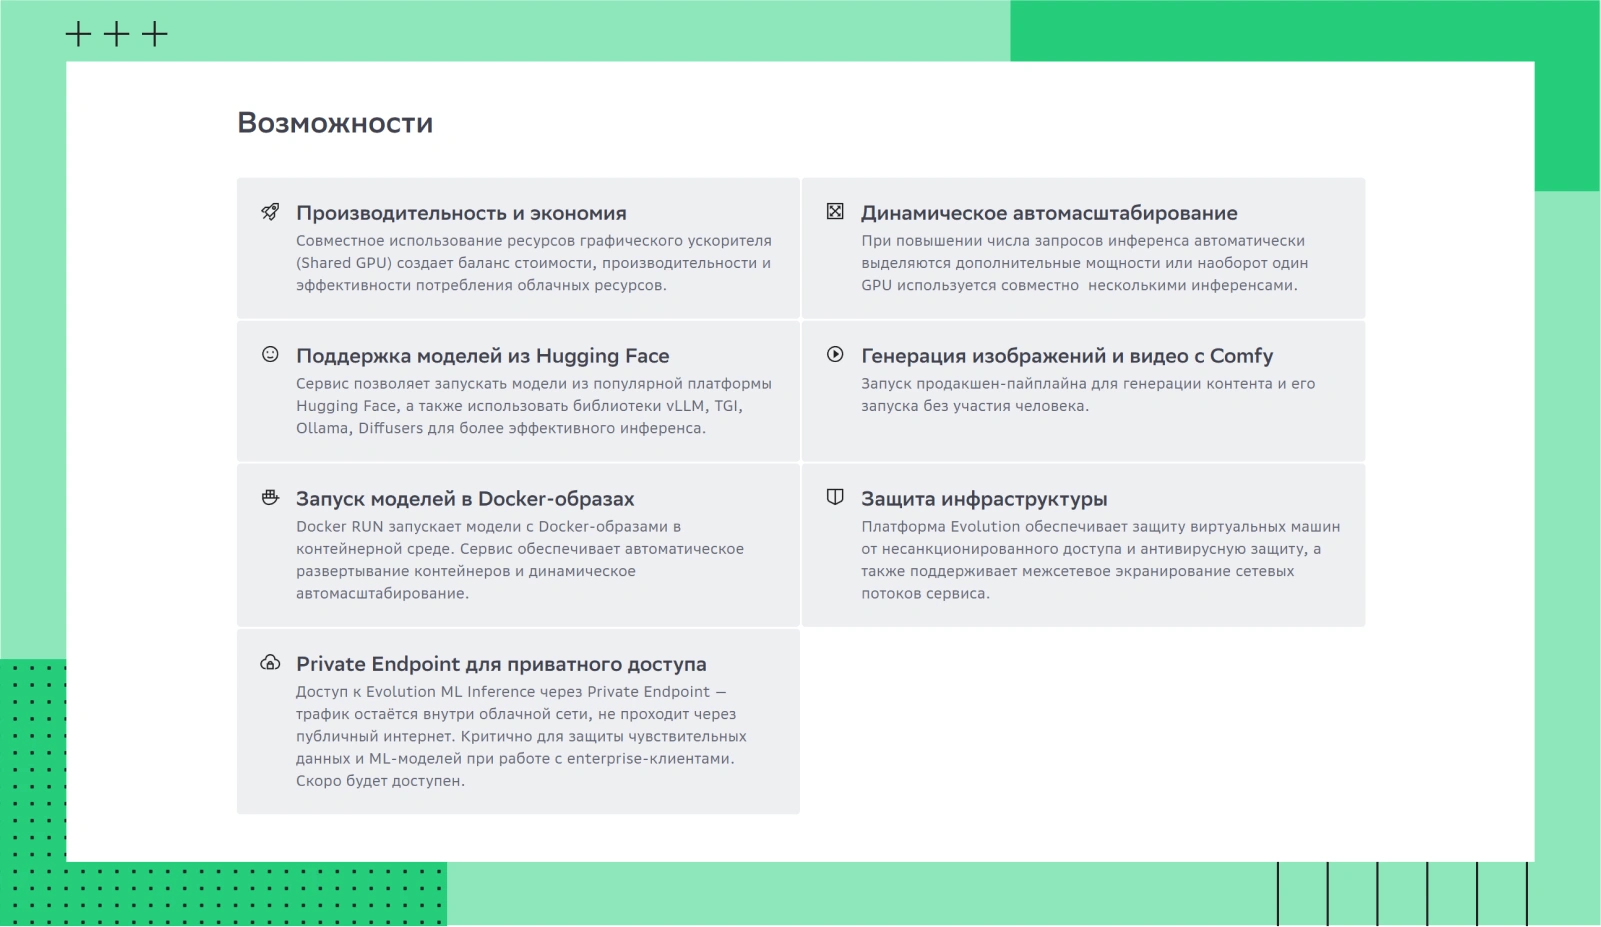 Возможности Evolution ML Inference
Evolution ML Inference — сервис для запуска ML-моделей в облаке на GPU. Он поддерживает готовые модели, пользовательские Docker-образы и среды выполнения вроде vLLM, TGI, Ollama. Доступно автомасштабирование мощностей в зависимости от нагрузки.
Evolution AI Agents поддерживает подключение собственных моделей через Evolution ML Inference. В каталоге также доступен «Агент Python-разработчик». Его можно использовать сразу, не создавая агентную логику с нуля.
Чек-лист: как протестировать AI-IDE на своем репозитории за один день
Прогоните через инструменты одну реальную не слишком сложную задачу вроде изменения способа авторизации в приложении. После выполнения оцените:
Понимает ли инструмент расположение компонентов и модулей.
Находит ли связанные файлы, функции, тесты.
Получается ли выполнить действие, затрагивающее несколько частей проекта.
Не потерялся ли нужный контекст при поиске по всему репозиторию.
Есть ли изменения во всех необходимых местах.
Были ли ошибки и ненужные исправления.
Запускались ли тесты.
После такого эксперимента можно сравнивать инструменты не по функциям, а по применимости в конкретных задачах проекта.
Заключение
У AI-IDE нет одного универсального способа работать с кодовой базой. Одни инструменты делают ставку на индексацию и поиск по репозиторию, другие — на длинный контекст, третьи — на агентный поиск и последовательную работу с файлами и инструментами.
Поэтому при выборе важно смотреть не только на список функций. Учитывайте размер и структуру репозитория, технологический стек, сложность задач и требования к приватности кода. А главное — проверяйте инструменты на реальных задачах своей команды: именно так проще понять, насколько хорошо AI-IDE находит нужный контекст и вносит изменения без лишних правок.
Для тестирования разных моделей можно использовать Evolution Foundation Models и подключать их к совместимым инструментам разработки.
FAQ
Какой ИИ лучше для написания кода?
Зависит от задачи и проекта. Учитывайте качество генерации и работы с контекстом репозитория, поддержку технологического стека, возможность подключить подходящую модель.
Что такое AI-IDE?
AI-IDE — среда разработки со встроенными ИИ-инструментами. Она помогает писать, изменять и проверять код.
Как AI-IDE понимает структуру проекта?
Она анализирует файлы проекта, индексирует код, ищет связи между функциями и компонентами, работает с контекстом для конкретных задач.
Чем Cursor отличается от GitHub Copilot?
Cursor — решение на базе VS Code с ИИ-функциями, ориентированными на работу с кодовой базой. GitHub Copilot — набор ИИ-инструментов, которые можно встраивать в сервисы GitHub и разные среды разработки.
Можно ли использовать Cursor в России?
С ограничениями функций, способов подключения и вариантов оплаты. Перед использованием нужно проверять условия для своего региона.
Какие аналоги Cursor AI есть в России?
Например, GigaCode и GigaIDE. Они подходят для разных сред разработки.
Можно ли подключить свою модель к AI-IDE?
Возможность зависит от конкретных решений. Многие AI-IDE предусматривают подключение сторонних или собственных моделей.