Сравнение российских LLM: GigaChat, YandexGPT, Mistral — что выбрать
Выбор LLM (Large Language Model, или большая языковая модель) для компании зависит не только от качества ответов. Не менее важно, насколько хорошо модель работает с русским языком, какой объем контекста поддерживает, на каких условиях ее можно использовать и получится ли развернуть в собственном контуре. GigaChat и YandexGPT — российские модели, а Mistral предлагает открытые решения, которые можно развернуть в своей инфраструктуре.
Публичные тесты и рейтинги не всегда показывают, как модель поведет себя на реальных задачах. Поэтому сравнивать LLM лучше на собственных данных и по заранее определенным критериям. В статье разберем особенности GigaChat, YandexGPT и Mistral и покажем, как проверить модели перед выбором.


- Что сравниваем и по каким критериям
- GigaChat: линейка Сбера
- YandexGPT: линейка Яндекса и Alice AI LLM
- Mistral: открытые модели для контура компании
- Сравнительная таблица и выбор под задачу
- Как протестировать модели на своих задачах в Cloud.ru
- Методика: как сравнить модели на своих данных за один день
- Как выбрать LLM без оглядки на чужой рейтинг
Что сравниваем и по каким критериям
Среди российских нейросетей GigaChat и YandexGPT — самые обсуждаемые. Но какая из них лучше — зависит от сценария проекта: поддержки клиентов, генерации документов, кодогенерации.
Пять критериев: качество на русском, контекст и инструменты, лицензия и размещение, стоимость, экосистема
Критерии, по которым стоит сравнивать модели, прежде чем тестировать их на своих данных:
Качество на русском — проверяют открытые бенчмарки MERA и SLAVA, независимые тесты на русскоязычных данных с фиксированной методологией.
Контекст и инструменты — сколько текста модель обрабатывает за один запрос. 32 тысячи токенов хватит для короткого диалога, а для анализа договора или базы знаний понадобится уже 128–256 тысяч.
Лицензия и размещение — с открытой MIT или Apache 2.0 модель разворачивают у себя в контуре. С проприетарным доступом по API — только облако разработчика, и точка.
Стоимость — считают за миллион токенов, отдельно за вход и за выход.
Экосистема — тут смотрят на готовые интеграции, документацию, SLA поставщика API и сообщество разработчиков вокруг модели.

Почему Mistral в списке: открытые веса и размещение в контуре как альтернатива закрытым API
GigaChat и YandexGPT — полностью российские нейросети, обученные и развернутые внутри страны. Mistral к этому списку не относится — команда разрабатывает свои системы во Франции. В статье Mistral рассматривается как открытая альтернатива для задач, где GigaChat и YandexGPT недоступны в нужном формате. Например, когда бизнесу нужен полный контроль внутри собственного дата-центра без передачи данных третьей стороне. Mistral Small и Mistral Large распространяются с открытыми весами под лицензией Apache 2.0. Их разворачивают на своих GPU и контролируют весь цикл обработки. В список российских нейросетей входят и другие имена — например, T-Pro от Т-Банка. Но в этом сравнении фокус на трех моделях с наибольшим объемом запросов.
GigaChat: линейка Сбера
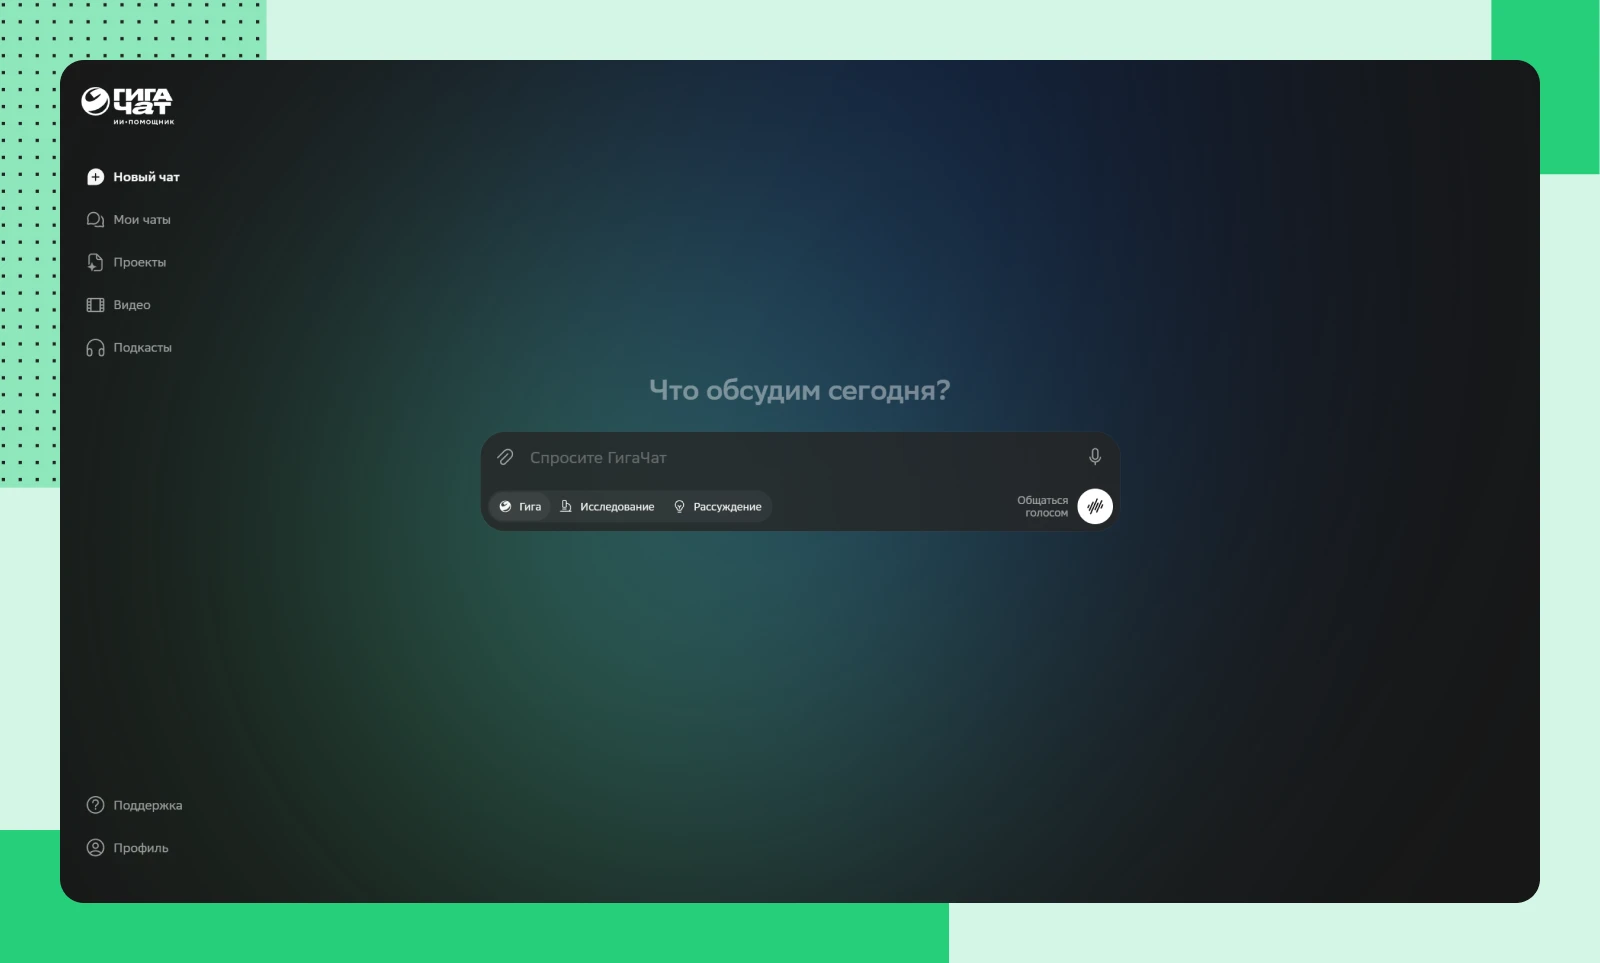 Интерфейс GigaChat
Версии и контекст: от Lightning до Ultra, открытая лицензия MIT у части моделей, позиции в MERA
Несколько версий с разным балансом скорости и качества входят в линейку GigaChat 3 — русскоязычную нейросеть от Сбера. Lightning отвечает быстро и держит высокую пропускную способность — подходит для простых, частых запросов. Ultra идет дальше: расширенный контекст и более высокий результат на бенчмарке MERA. Часть линейки распространяется под лицензией MIT — с правом на коммерческое использование и развертывание в собственной инфраструктуре, например, через Evolution ML Inference. На бенчмарке MERA GigaChat стабильно входит в число лидеров среди отечественных нейросетей. Но отстает от топовых зарубежных решений по совокупному баллу.
Сильные стороны и ограничения на прикладных задачах: длинный контекст, RAG, вызов инструментов
GigaChat хорошо работает с русскоязычными текстами: помогает писать деловые письма, описания товаров и другой контент. Модель также поддерживает function calling — может вызывать внешние функции и API по запросу пользователя, например получать данные из корпоративных систем.
Отдельный сценарий — RAG, когда модель отвечает на вопросы, используя информацию из базы документов. На больших и специализированных базах качество ответа может снижаться, особенно если в документах много узких отраслевых терминов. В таких случаях важно правильно настроить поиск по базе и промпты. Для этого можно использовать проверенную базу знаний и подключить ее через Evolution Managed RAG.
YandexGPT: линейка Яндекса и Alice AI LLM
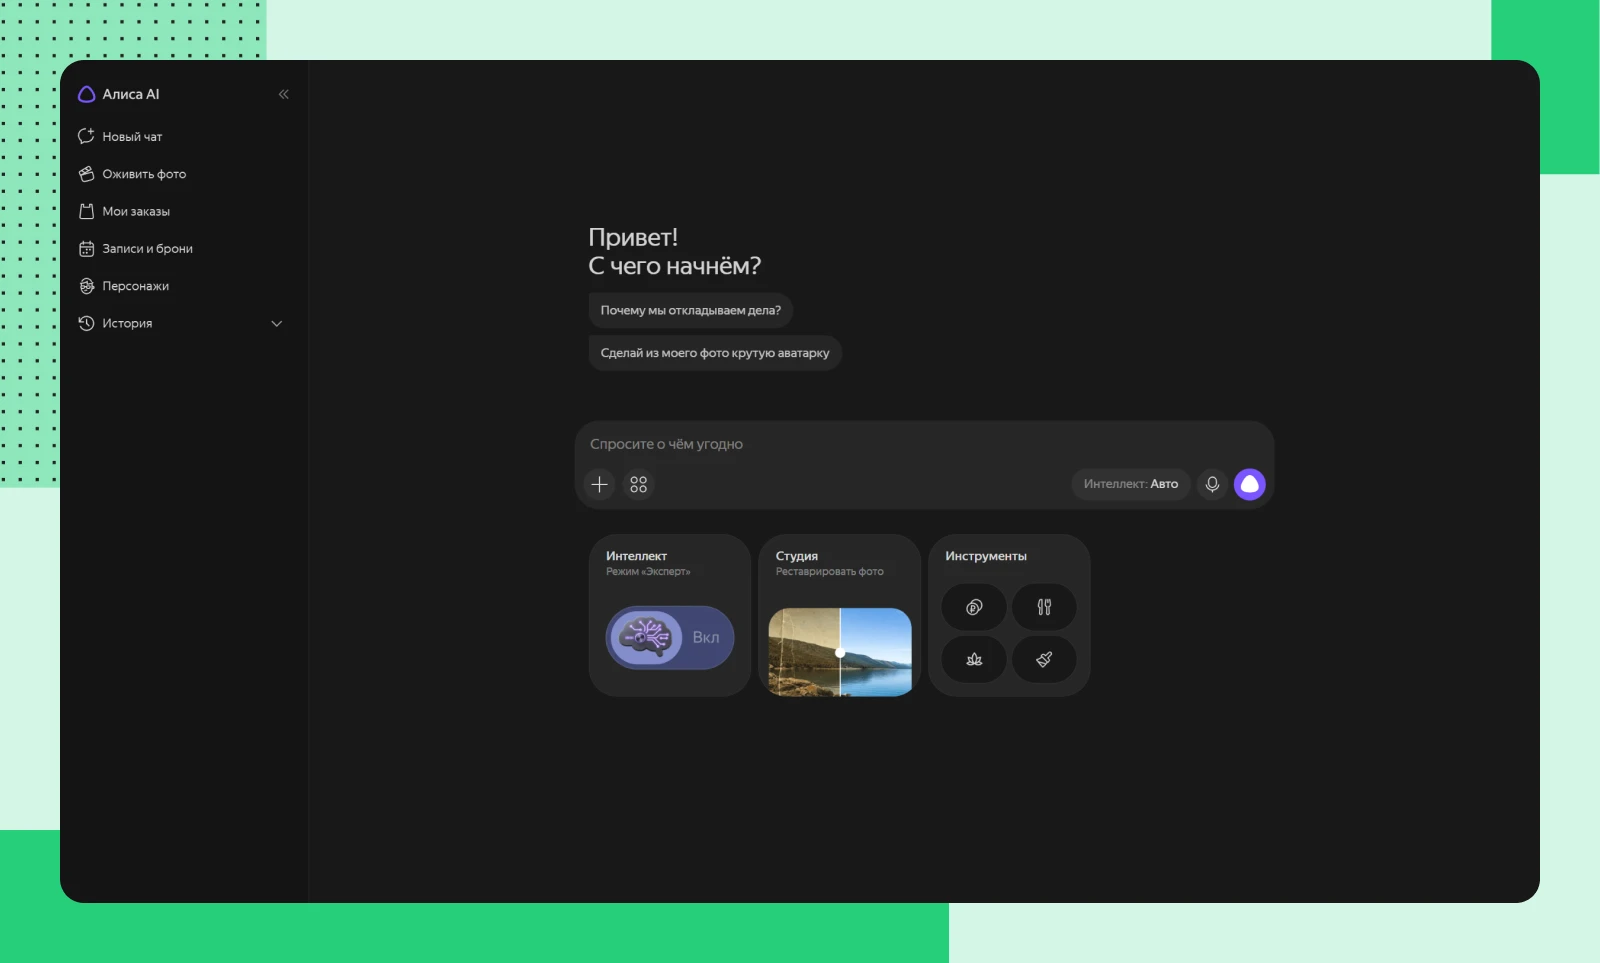 Интерфейс Алисы AI
Версии, контекст, доступ по API и через облако Яндекса; что изменилось с появлением Alice AI LLM
Актуальная версия линейки — YandexGPT 5.1 Pro. Работает с контекстным окном 128 тысяч токенов, доступна через API и облако Яндекса. Alice AI LLM — отдельная линейка, заточенная под роль ассистента внутри экосистемы Яндекса. С ее выходом голосовой и текстовый ассистент получил более современную архитектуру и лучше держит контекст диалога, чем более ранние версии YandexGPT в потребительских сценариях. Обе линейки остаются проприетарными. Развернуть их на своих серверах нельзя — доступ только по API.
Где YandexGPT сильнее, где уступает: генерация текста, работа с длинными документами, стоимость
Связные тексты на русском языке и адаптация стиля под задачу — сильная сторона YandexGPT: от рекламных материалов до технической документации. Но контекстное окно в 128 тысяч токенов ограничивает работу с длинными документами. Объемный договор или свод регламентов приходится делить на части. Для несложных случаев это работает. Но растет число запросов, а вместе с ним — риск потерять контекст между частями. Для регулярной работы с длинными файлами лучше подходят модели с окном от 128 тысяч токенов. Стоимость варьируется по тарифу и объему запросов. Закрытая лицензия исключает размещение в собственном контуре.
Mistral: открытые модели для контура компании
 Интерфейс Mistral
Mistral Small и Large: лицензии, качество на русском, требования к GPU для инференса
Фирменный чат-интерфейс Le Chat от Mistral AI позволяет быстро оценить качество ответов на русском языке перед выбором версии для развертывания. В линейке две модели.
Large — старшая версия с открытыми весами и лицензией, которая разрешает коммерческое использование.
Small — компактный вариант для случаев с ограниченным бюджетом на вычисления.
С русским языком у Mistral есть нюанс: качество уступает специализированным российским решениям. Но для базовых задач вроде суммаризации и извлечения сущностей этого достаточно. Для инференса Large требуется серьезная видеокарта. Evolution ML Inference снимает эту нагрузку с внутренней инфраструктуры, давая доступ к GPU по требованию.
Как Mistral соотносится с Qwen и DeepSeek — другими открытыми моделями, доступными в России
По цене и качеству на русском языке с Mistral часто конкурируют китайские открытые системы — Qwen и DeepSeek. DeepSeek сильнее в кодогенерации и математических вычислениях. Qwen — в многоязычной работе с большим объемом данных. У Mistral свой козырь: юридическая прозрачность лицензии и опыт европейской разработки. Все три доступны в каталоге Evolution Foundation Models. Их тестируют без развертывания отдельной инфраструктуры под каждую.
Сравнительная таблица и выбор под задачу
Критерий | GigaChat 3 Ultra Preview | YandexGPT 5.1 Pro | Mistral Large |
Контекст | 131 тыс. токенов | 128 тыс. токенов | 256 тыс. токенов |
Параметры | 702B общих / 36B активных параметров | не раскрыто | 675B общих / 41B активных параметров |
Лицензия | MIT (часть моделей) | проприетарная, только API | Apache 2.0 |
Размещение в контуре | да, через Evolution ML Inference | нет | да, через Evolution ML Inference |
Function calling | поддерживается | ограниченно | поддерживается |
Мультимодальность | в разработке | текст | текст + изображения |
Из сравнения видно: закрытая лицензия YandexGPT исключает вариант с размещением в собственном контуре, а GigaChat и Mistral подходят для случаев, где данные не должны покидать инфраструктуру компании.
Поддержка клиентов и RAG: что выбрать при чувствительных данных
Чат-боты с доступом к персональным данным клиентов должны маскировать чувствительную информацию перед отправкой в систему. Речь идет о номерах телефонов, адресах, номерах счетов — обо всем, что естественным образом попадает в переписку с клиентом. GigaChat и Mistral снижают этот риск. Развернутые через Evolution ML Inference с Guardrails Filter, они контролируют запросы на этапе отправки: фильтр заменяет чувствительные поля на плейсхолдеры до того, как запрос уходит в модель. YandexGPT — для другого случая: там, где нет строгих требований к размещению, а важнее скорость внедрения через готовый API. Например, для публичного бота с ответами на общие вопросы о продукте, где персональные данные в диалоге не фигурируют.
Генерация документов и маркетинг: где важнее качество русского языка
Описания товаров, рекламные тексты и деловая переписка держатся в первую очередь на грамотном русском языке. Контекстное окно и лицензия здесь менее критичны. В качестве примера возьмем интернет-магазин с каталогом на несколько тысяч позиций или агентство, которое готовит десятки коммерческих предложений в месяц. Здесь важнее стабильность стиля и минимум ручной правки, чем контекстное окно в сотни тысяч токенов. YandexGPT и GigaChat показывают сопоставимый уровень в этом сегменте. Выбор часто сводится к стоимости генерации при большом объеме текста и скорости интеграции с уже используемой CMS или CRM.
Кодогенерация и агенты: где важнее вызов инструментов и длинный контекст
Многошаговый вызов функций и обращение к нескольким инструментам подряд — типичный сценарий для агентов. Здесь длинный контекст и стабильный function calling важнее общего балла на бенчмарке. Например, агент для обработки заявок: он работает пошагово, каждый следующий вызов использует результат предыдущего:
Запрашивает данные клиента и статус заявки из CRM.
Проверяет остатки на складе через отдельный API.
Формирует и отправляет ответ клиенту, опираясь на данные из первых двух шагов.
Промежуточные результаты добавляются в контекст следующего вызова. При окне в 128 тысяч токенов такая цепочка быстро упирается в лимит и теряет начальные инструкции. Здесь выигрывают GigaChat и Mistral — с контекстом от 128 тысяч токенов и поддержкой function calling. А собрать саму цепочку вызовов удобно в сервисе Evolution AI Agents поверх любой из выбранных моделей.
Для более простого старта с ИИ-агентами есть Cloud.ru Agents Space — пространство, где можно ставить агенту задачи в чате, загружать файлы и подключать готовые сервисы. Агент сам планирует последовательность действий, работает с подключенными инструментами и возвращает результат. Например, он может разобрать почту, найти свободное время в календаре, подготовить документ или собрать отчет. При этом доступы к сервисам и действия агента остаются под контролем пользователя.
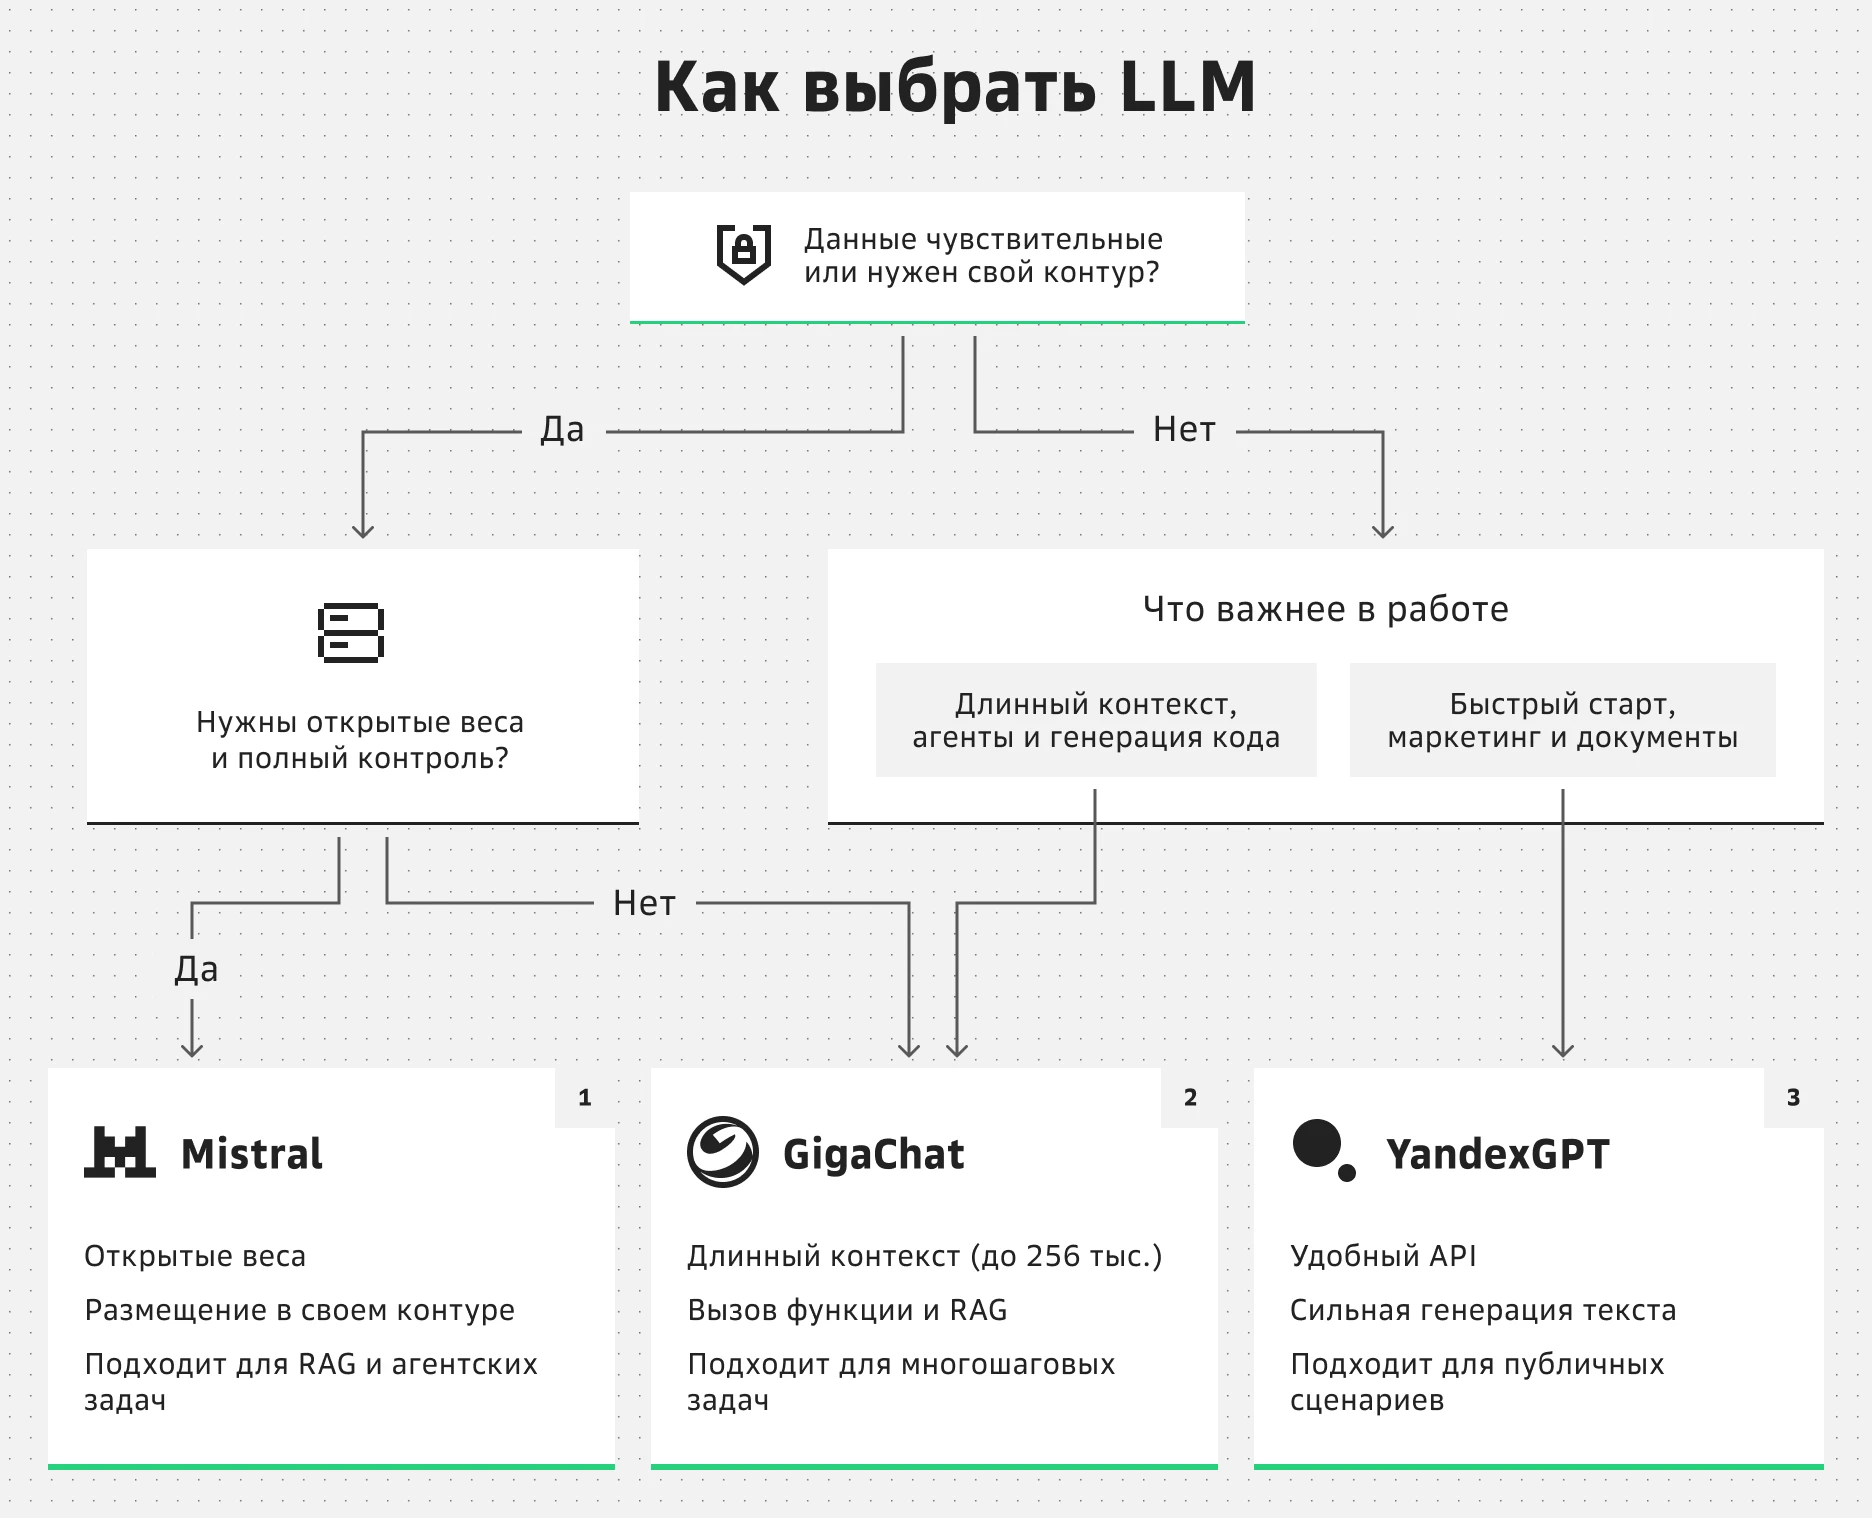 Алгоритм выбора LLM
Как протестировать модели на своих задачах в Cloud.ru
Evolution Foundation Models: 20+ моделей через единый API и веб-интерфейс, оплата по факту, AI Playground для сравнения
Доступ к GigaChat, Qwen, DeepSeek, GLM и другим нейросетям через единый OpenAI-совместимый API открывает сервис Evolution Foundation Models. Оплата — по факту использования: за количество входных и выходных токенов, без абонентской платы за неиспользованные ресурсы. Сравнить модели можно прямо в личном кабинете — через AI Playground, на одном запросе, без переключения между провайдерами. Лимит стандартный: 20 запросов в секунду на один API-ключ. Для более высокой нагрузки модель разворачивают в приватном экземпляре через Evolution ML Inference.
Guardrails: маскирование корпоративных и персональных данных в запросах к внешним моделям
Чувствительные данные в запросах к внешним LLM проверяет и маскирует до отправки фильтр Guardrails. Встретился в тексте номер карты, ФИО клиента или номер договора? Фильтр заменяет их плейсхолдерами до отправки в модель и восстанавливает исходные значения в ответе. Так снижается риск утечки и упрощается соответствие 152-ФЗ о хранении данных на территории России — особенно когда запрос уходит во внешнюю LLM за пределами инфраструктуры Cloud.ru. Есть и второй уровень защиты — Guardrails LLM. Он проверяет сами запросы на скрытые инструкции, которые пытаются переопределить системный промпт агента.
Evolution ML Inference: размещение открытых моделей, включая Mistral, в инфраструктуре Cloud.ru
Открытые нейросети из Hugging Face, включая Mistral, запускаются на выделенных GPU-ресурсах Cloud.ru через сервис Evolution ML Inference. Доступны видеокарты Nvidia V100, A100 и H100 — с разным соотношением цены и производительности. А технология Shared GPU позволяет частично использовать один ускоритель под несколько задач: не нужно переплачивать за простаивающие ресурсы. Собственные видеокарты закупать не придется — заказчик получает частный экземпляр, трафик остается внутри облачной инфраструктуры. Есть и гибкость в средах исполнения: помимо готовых моделей, сервис поддерживает vLLM, TGI и Ollama.
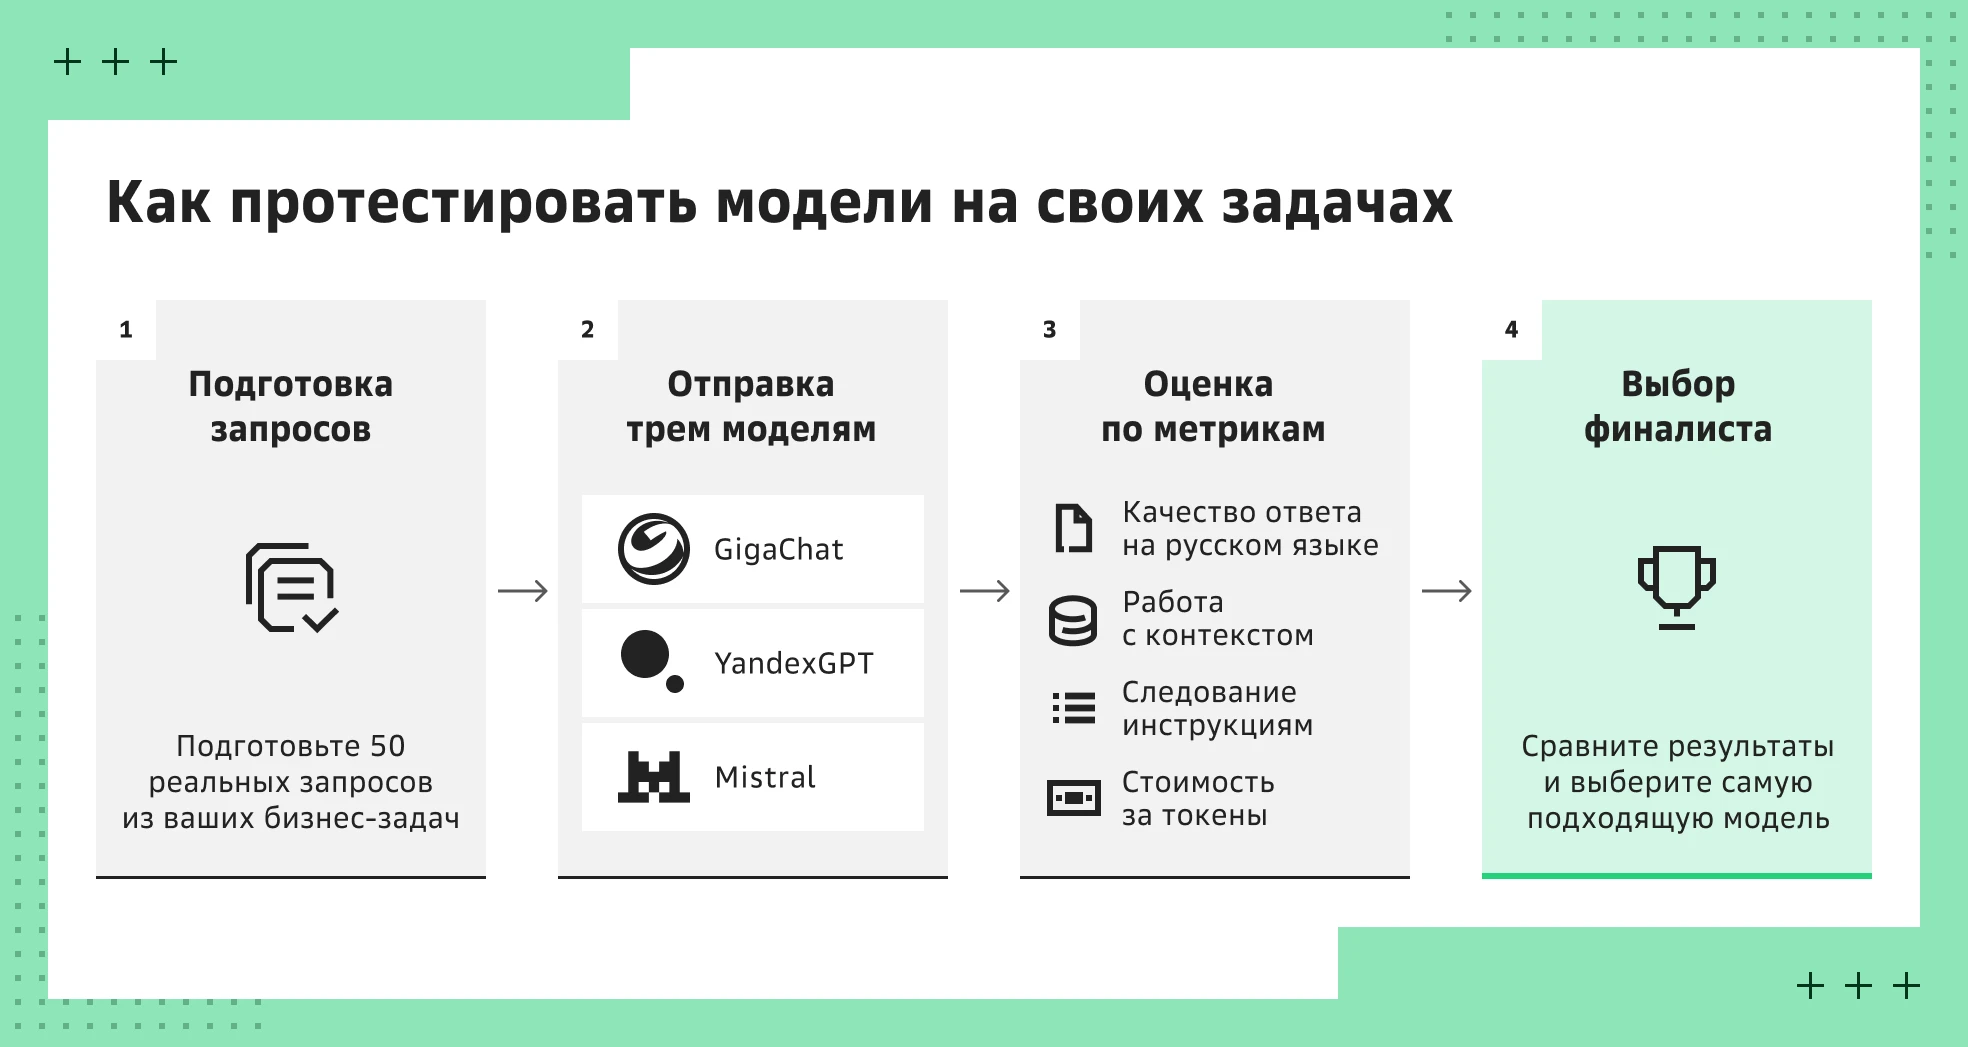 Тестирование на своих задачах
Методика: как сравнить модели на своих данных за один день
Команда собирает 50 реальных запросов из своего сценария: обращений в поддержку, черновиков документов, задач кодогенерации. Каждый запрос отправляется всем трем нейросетям через единый API Evolution Foundation Models — без изменения промпта. Дальше — оценка. Ответы сравнивают по четырем метрикам: точность, соответствие формату, скорость генерации и стоимость запроса. По итогам команда выбирает финалиста для полноценного внедрения или комбинацию решений под разные случаи использования внутри одного продукта.
Если интересует, как такие ИИ-системы строят на практике, 15 октября в Москве пройдет GoCloud Tech 2026 — хардовая конференция Cloud.ru для инженеров и разработчиков. В программе: инфраструктура, разработка, данные и ML, а также практические воркшопы и инженерные кейсы.
Как выбрать LLM без оглядки на чужой рейтинг
Универсального победителя среди российских нейросетей нет:
GigaChat берет длинным контекстом и открытой лицензией.
YandexGPT — интеграцией с сервисами Яндекса и качеством генерации текста.
Mistral и другие открытые решения — полным контролем в собственном контуре.
Правильный выбор опирается на тестовые запросы самой компании. Чужой рейтинг здесь дает только ориентир. Протестировать все три варианта на своих данных можно за один день в Evolution Foundation Models — с готовым API вместо отдельного стенда под каждый из них.
Частые вопросы и ответы
Какие нейросети считаются российскими?
Юрисдикция разработчика в России — главный признак: например, ГигаЧат создан Сбером, а YandexGPT — Яндексом. Mistral, в отличие от них, — разработка французской Mistral AI, поэтому в тексте она обозначена как открытая альтернатива для размещения в контуре. Статус «российская LLM» к ней не относится.
Что лучше — GigaChat или YandexGPT?
Однозначного лидера нет. У GigaChat — более широкое контекстное окно и открытая лицензия на часть линейки. У YandexGPT — сильная генерация текста на русском языке и удобная интеграция в сервисы Яндекса. Выбор зависит от сценария и требований к размещению данных.
Можно ли использовать Mistral в России и в закрытом контуре?
Да, Mistral распространяется с открытыми весами: ее можно развернуть на собственных серверах или запустить как частный экземпляр в сервисе Evolution ML Inference на площадках в России.
Что такое бенчмарк MERA и как его читать?
Открытый и независимый набор задач на знания, логику и работу с текстом — так устроен бенчмарк MERA для оценки русскоязычных LLM. Результат указывается в баллах из 100 с датой замера, поскольку модели обновляются и позиции в рейтинге меняются.
Какая LLM лучше подходит для RAG по корпоративным документам?
Чувствительные данные не должны покидать инфраструктуру заказчика — поэтому для RAG лучше подходят GigaChat или Mistral в сервисе Evolution ML Inference, с размещением в контуре.
Сколько стоит использование российских LLM по API?
Цена считается по токенам: отдельно за то, что система получает на входе, и за то, что генерирует на выходе, а конкретная сумма зависит от версии. Актуальные тарифы указаны в каталоге сервиса Evolution Foundation Models.
Как протестировать несколько LLM на своих данных?
Через AI Playground в Evolution Foundation Models: нейросети доступны по единому API, а сравнение ответов на одном запросе занимает несколько минут без развертывания отдельной инфраструктуры.