Как выбрать GPU-сервер
GPU-сервер выбирают не по названию видеокарты, а по задаче. Если этого не сделать, возможны две крайности: либо вы купите избыточное «железо», которое будет простаивать, либо недоберете видеопамяти, и модель просто не запустится. Чтобы этого избежать, нужно отталкиваться от размера модели и длины контекста и сопоставлять задачу с классом GPU. В статье — метод расчета и сравнение покупки сервера с арендой.


Что такое GPU-сервер и зачем он ИИ-задачам
GPU-сервер — «железо» с графическими процессорами, предназначенное для выполнения параллельных и сложных вычислений. Это нужно при использовании искусственного интеллекта (ИИ), поскольку обучение и запуск нейросетей подразумевают огромное количество операций с матрицами и тензорами.
Почему GPU, а не CPU
CPU и GPU решают разные задачи. CPU силен в последовательных операциях: он выполняет команды одну за другой и хорошо справляется с логикой, ветвлениями, работой с памятью. Нейросети же устроены иначе — это тысячи однотипных операций над матрицами, которые нужно выполнять одновременно. Для этого в GPU (Graphic Processing Unit) появились тензорные ядра: они обрабатывают такие операции параллельно и ускоряют обучение и инференс.
Но CPU в GPU-сервере не бездельничает. Он отвечает за API, маршрутизацию, обслуживание контейнеров, подготовку запросов и данных. GPU берет на себя только вычислительную нагрузку нейросети.
Однако мощность GPU — не единственный критерий. Для ИИ важна еще и видеопамять (VRAM). В ней хранятся веса LLM и данные для вычислений, поэтому именно объем VRAM определяет, какие модели вообще можно запустить. Если памяти недостаточно, модель будет работать медленно либо ее не получится развернуть на одном GPU.
Три типа нагрузок
GPU-серверы применимы в разных сценариях работы с моделями. Разделим нагрузки на три типа:
Тип нагрузки | Особенности | Основные требования к GPU | Что нужно учесть |
Инференс | Запуск готовой обученной модели | Достаточный объем VRAM, высокая пропускная способность памяти (HBM) | Количество пользователей, ожидаемая скорость ответа, длина контекста, допустимая задержка (latency) |
Дообучение | Адаптация готовой LLM под конкретные бизнес-задачи и данные | Больше VRAM и вычислительных мощностей, чем для инференса | Размер датасета (общий объем используемой информации), batch size (количество данных, которые обрабатываются за раз), метод дообучения (LoRA или QLoRA) |
Обучение | Создание модели с нуля | Несколько GPU с высокой производительностью и быстрым обменом данными | Размер модели, объем и особенности датасета, количество итераций, batch size и продолжительность обучения |
Тип нагрузок влияет на требования к GPU-инфраструктуре. Для инференса приоритетны скорость обработки запросов и эффективное распределение доступных ресурсов, для дообучения — вычислительная мощность и достаточный объем VRAM, для обучения — высокая производительность и перспективы масштабирования на несколько GPU.
Шаг 1. Считаем видеопамять под модель
Памяти должно хватить для весов модели, данных и KV-кеша (Key-Value Cache), который применяется при генерации ответов. Если ее недостаточно, модель не запустится или будет работать некорректно. Слишком большой запас тоже не нужен, поскольку компания переплатит за неиспользуемые ресурсы.
Формула для расчета
Пример расчета для модели 32B в 4-битной квантизации и в FP16:
Здесь рассчитана память только для хранения весов модели. Для служебных буферов и KV-кеша потребуется дополнительная. Чем больше одновременных запросов и длиннее контекст, тем больше объем памяти.
Если один GPU не обеспечивает достаточный объем VRAM, LLM можно распределить между несколькими ускорителями.
LoRA и QLoRA: почему дообучение помещается в одну карту
LoRA (Low-Rank Adaptation) — низкоранговая адаптация. При таком методе матрица весов нейросети раскладывается на произведение двух матриц с меньшими параметрами. Именно эти две матрицы и оптимизируются. После обучения они перемножаются и получается одна дополнительная матрица, которая прибавляется к основной. Такой подход снижает количество обучаемых параметров и сохраняет вычислительную мощность LLM.
QLoRA (Quantized LoRA) — усовершенствованная версия предыдущего метода, объединяющая низкоранговую адаптацию с квантованием (сжатием). Квантование применяется для основной предобученной матрицы, чтобы за счет сжатия весов уменьшить ее объем.
Методы позволяют обойтись без полноценного дообучения всех параметров. Большая модель с учетом оптимизации с помощью LoRA и QLoRA часто помещается в VRAM одной GPU. При Full Fine-Tuning (полном дообучении) памяти требуется больше.
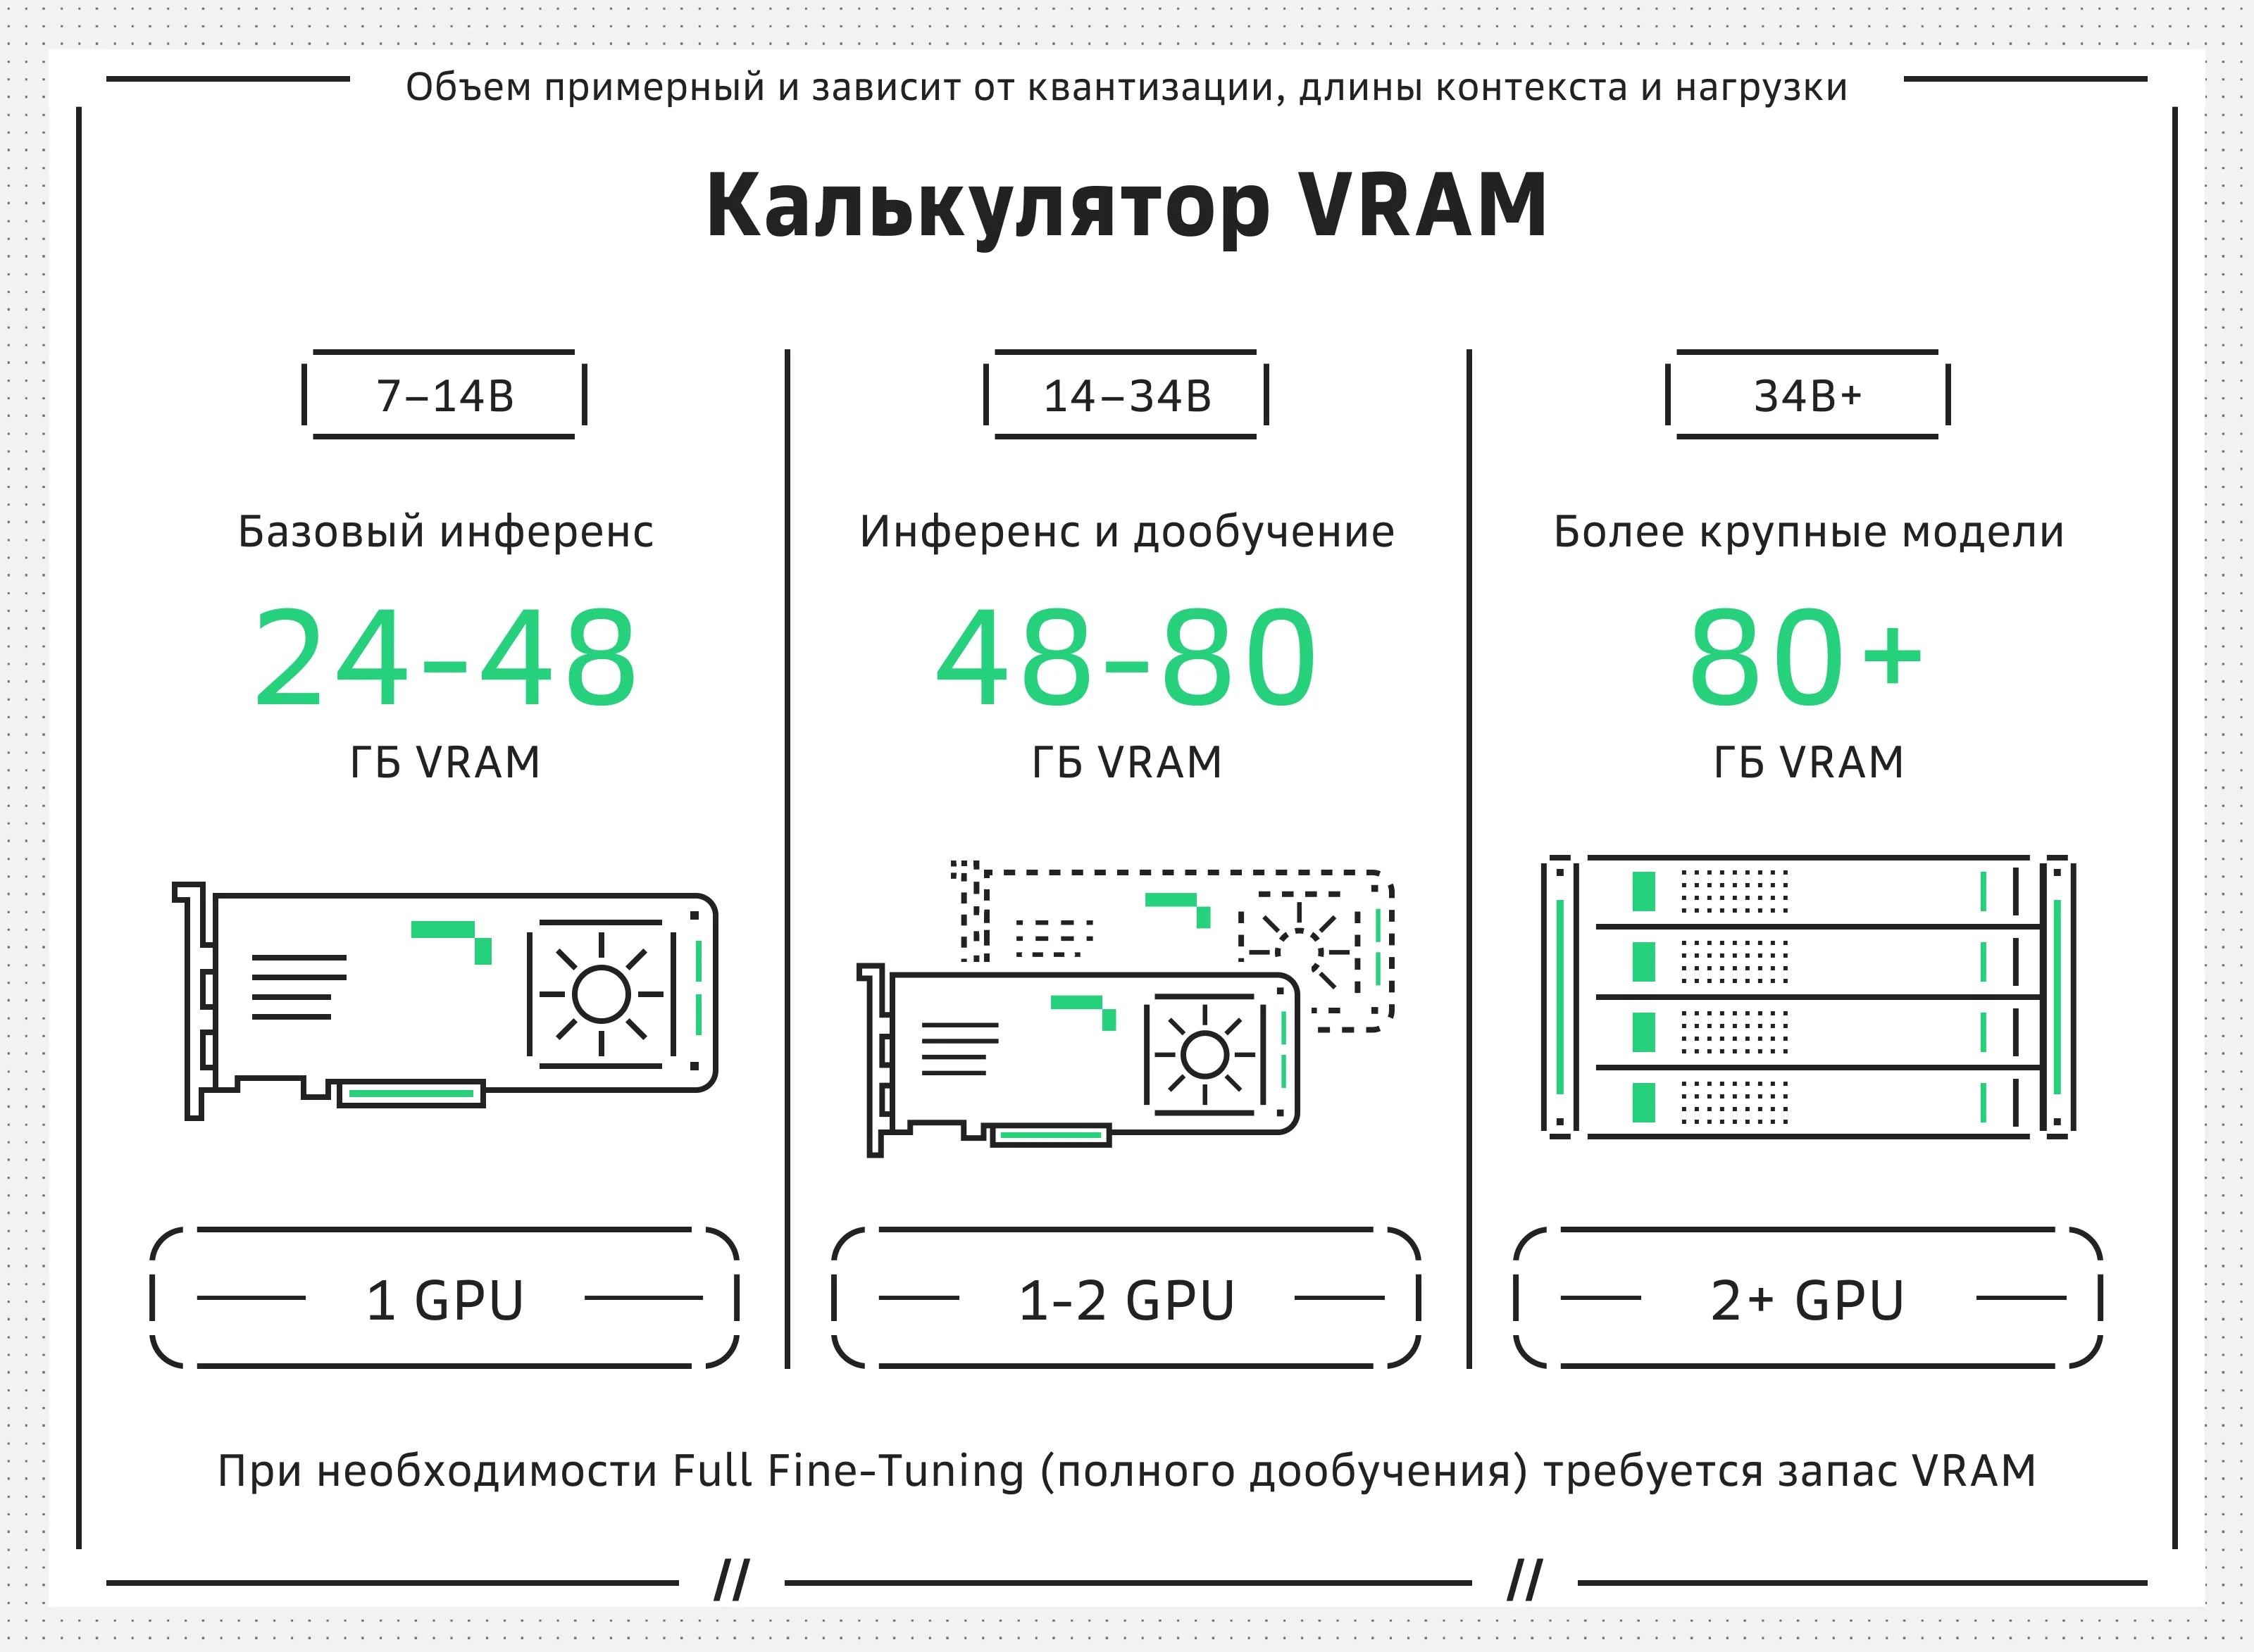 Калькулятор VRAM
Шаг 2. Выбираем класс GPU под задачу
Здесь важно учитывать не только объем памяти, но и сценарий использования: разработка и пилотирование, рабочий инференс или обучение модели. Один и тот же GPU не обязательно будет оптимальным для всех трех задач.
Потребительские карты для разработки и небольшого инференса, серверные ускорители — для продакшена и обучения
Для разработки, тестирования и пилотов подходят потребительские GPU, например, RTX 3090 (24 ГБ), RTX 4090 (24 ГБ), RTX 5090 (32 ГБ). В бизнес-задачах для готовых моделей используются серверные ускорители. Варианты:
Небольшой инференс — T4 и A10 подходят для легких моделей, ИИ-агентов с малым количеством задач.
Высоконагруженный инференс в продакшене — A100.
Fine-tuning — производительные ускорители вроде A100, H100 и H200.
Для крупных моделей, большого количества пользователей и длинного контекста могут понадобиться дополнительные системные ресурсы.
Память, пропускная способность и NVLink: что важнее для инференса, что — для обучения
Три характеристики GPU по-разному влияют на инференс и обучение.
Объем памяти (VRAM) определяет, какие модели вообще поместятся на карту. Для инференса это критично: VRAM должна вмещать веса модели, промежуточные данные и KV-кеш. Чем длиннее контекст и больше одновременных запросов, тем выше требования.
Пропускная способность памяти отвечает за скорость обмена данными между памятью и вычислительными блоками. Она важна и для инференса, и для обучения: в обоих случаях приходится постоянно обращаться к большим массивам данных. Но для обучения она критичнее — именно она часто становится узким местом при работе с большими батчами.
NVLink — высокоскоростной интерфейс для обмена данными между GPU, альтернатива PCIe. Он нужен там, где одной карты не хватает и модель или данные распределяются между несколькими. При обучении это почти всегда: параметры постоянно синхронизируются между ускорителями. При крупномасштабном инференсе NVLink тоже применяется, но не обязателен — если модель помещается на одну карту, он не нужен.
При этом GPU — только один элемент ИИ-инфраструктуры. На практике приходится учитывать и сеть, хранение данных, топологию серверов, масштабирование и другие компоненты. О том, как устроена инфраструктура под растущие ИИ-нагрузки и какие инженерные решения применяют в продакшене, поговорим 15 октября на GoCloud Tech 2026 — конференции Cloud.ru для тех, кто создает технологии в эпоху ИИ.
Примеры параметров для разных задач:
Сценарий | Модель | Нагрузка | Видеопамять | Количество карт |
Чат-бот | 7–14B | Один пользователь, простые запросы | 24–48 ГБ | Одна |
Поиск по корпоративным документам | 7–14B + | Средний контекст | 24–48 ГБ + запас ОЗУ | Одна |
Ассистирование в разработке кода | 14–34B | Длинный контекст | от 48 ГБ | Одна или две |
Анализ данных и генерация отчетов | 14–34B | Средний контекст, постоянный поток запросов | от 48 ГБ | Одна или две |
Мультиагентная система | 34–70B | Несколько агентов, много запросов | от 80 ГБ | Две и больше |
Шаг 3. Собираем сервер вокруг GPU
GPU — не единственный компонент системы. Рассказываем, что учесть при сборке.
CPU и линии PCIe для нескольких карт, оперативная память, NVMe, сеть для кластера
В сервере с GPU для LLM также должны быть:
CPU и линии PCIe. CPU обеспечивает связь GPU-сервера с другими устройствами, однако при ограниченной пропускной способности не выйдет быстро получать данные. При использовании нескольких карт применяют PCIe-топологию, когда устройства распределяются между CPU и PCIe-коммутаторами.
Оперативная память (RAM). Необходима для обрабатываемых данных, подготовки датасетов и управления задачами. Чем масштабнее ИИ-проект, тем больше объем.
NVMe-накопители. Нужны для моментальной подачи датасетов, сохранения чекпоинтов (текущего состояния весов модели) и локального кеша.
Сеть (например, 25/100 Гбит/с). Позволяет GPU в кластере обмениваться данными.
Эти компоненты нужно учитывать сразу и в комплексе при выборе конфигурации. Если процессор, память, накопитель или сеть не справятся с нагрузкой, систему не спасет и самый производительный GPU.
Питание и охлаждение: почему 8 карт в стойке — отдельная инженерная задача
Чем больше GPU, тем выше энергопотребление и тепловыделение. У каждой карты есть TDP (Thermal Design Power) — проектная тепловая мощность, на которую рассчитаны ее система охлаждения и блок питания. При сборке сервера нужно суммировать TDP всех ускорителей и подобрать БП и охлаждение с соответствующим запасом.
Возьмем сервер с восемью ускорителями B200, каждый из которых потребляет до 1 кВт. Только на GPU приходится до 8 кВт — без учета процессоров, памяти, накопителей и сетевых карт. Это уже сопоставимо с потреблением небольшого цеха. Отвести такое количество тепла стандартными серверными вентиляторами не получится: нужна либо мощная воздушная система с продуманной циркуляцией, либо жидкостное охлаждение. Если охлаждение не справляется, ускорители сбрасывают частоты — и производительность падает.
Поэтому для сервера с восемью GPU питание и охлаждение считают комплексно, с учетом всей ИИ-инфраструктуры. Чем выше плотность вычислений, тем жестче требования.
ТСО покупки против аренды
При нестабильной нагрузке покупать GPU-сервер не всегда выгодно — проще арендовать его и платить за фактически потребляемые ресурсы.
Точка безубыточности: при какой утилизации собственный сервер дешевле аренды
Утилизация GPU (GPU utilization) — процент времени, в течение которого ускоритель занят выполнением вычислительных задач. Чем стабильнее и выше загрузка, тем быстрее окупаются вложения в собственный сервер. Если GPU постоянно простаивает, рациональнее выбрать аренду.
Перед принятием окончательного решения нужно просчитать точку безубыточности. Учитываются стоимость сервера, срок эксплуатации, расходы на размещение и электричество. Полученную сумму нужно сравнить со стоимостью аренды сопоставимых мощностей. По отраслевым оценкам, при устойчивой загрузке ниже ~40% аренда, как правило, обходится дешевле владения; при загрузке выше 60–70% собственный сервер начинает окупаться быстрее.
Скрытые расходы покупки
Компания платит не только за «железо», но из-за размещение в ЦОД, электричество, амортизацию оборудования. Расходы будут особенно ощутимы для мощных многокарточных систем. Это нужно учитывать при расчете TCO (Total Cost of Ownership, совокупной стоимости владения).
В перспективе ожидают и затраты на смену поколений GPU. Даже исправный сервер через несколько лет будет проигрывать новым версиям в производительности.
При выборе между локальной и облачной инфраструктурой нужно сравнивать стоимость мощностей при одинаковой полезной нагрузке. Например, для инференса можно взять за ориентир расходы на обработку миллиона токенов, для обучения — на один запуск.
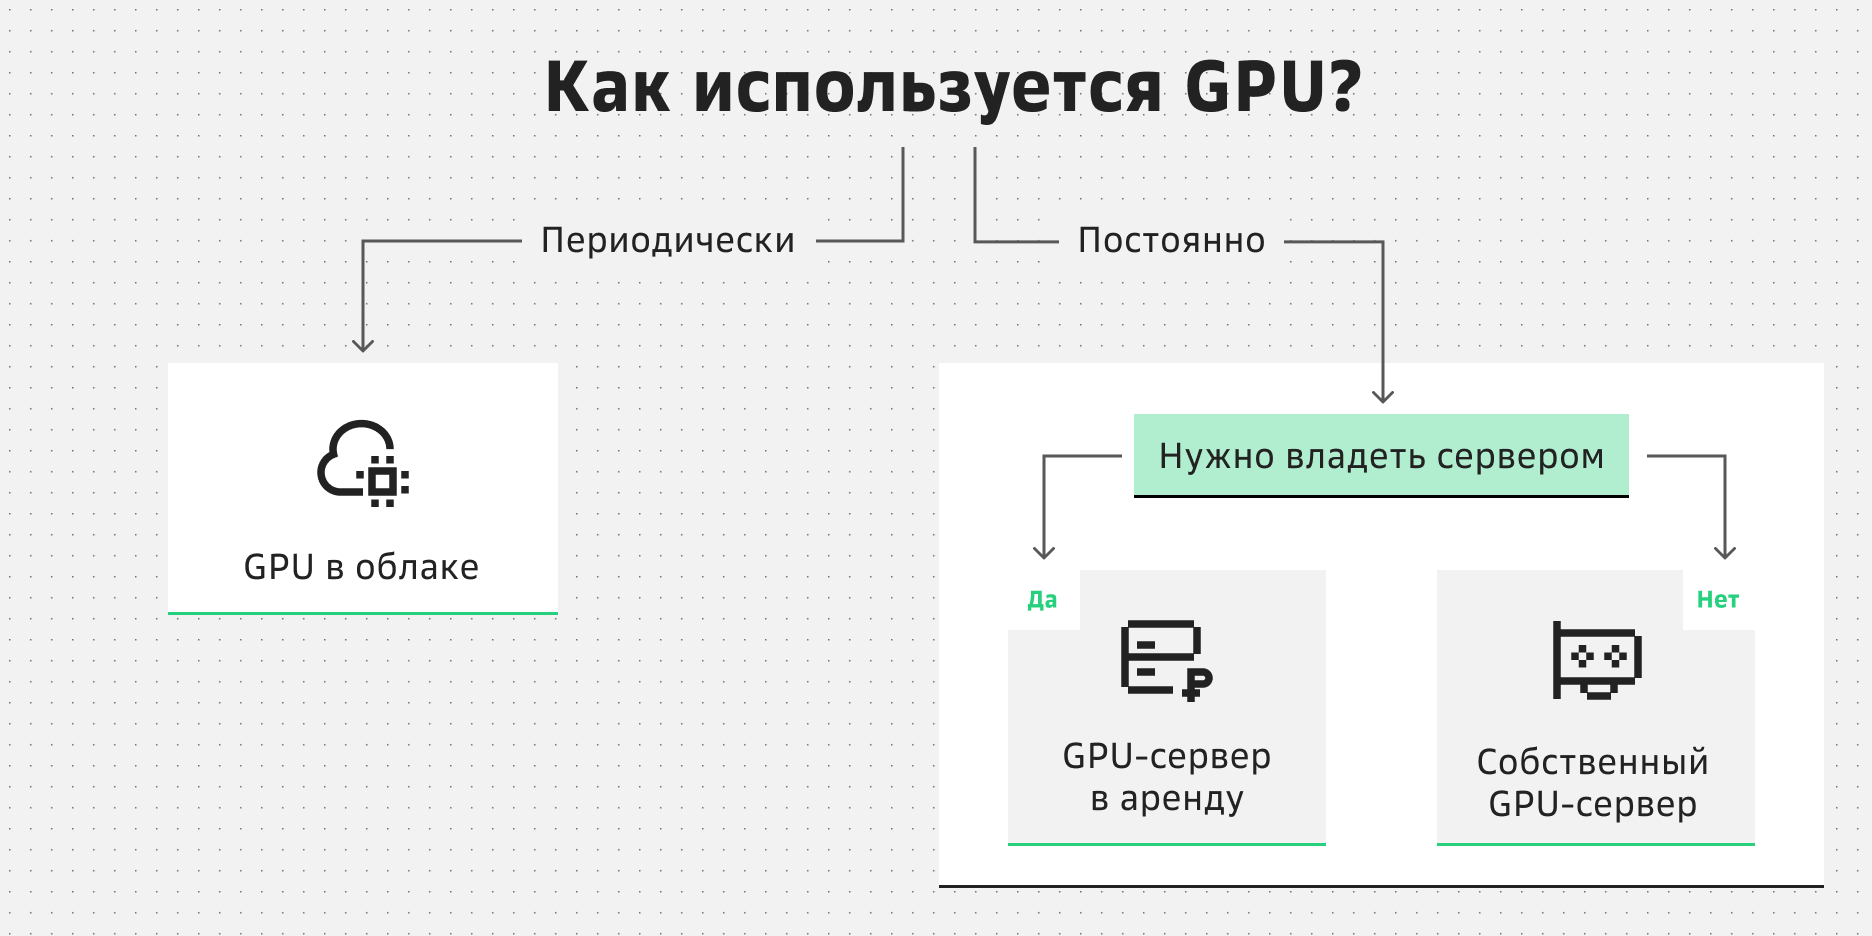 Выбираем формат использования GPU
GPU в Cloud.ru: варианты под разные нагрузки
Провайдер предоставляет выделенные физические серверы, виртуальные машины, готовые LLM.
Аренда GPU в облаке Cloud.ru: виртуальные серверы с GPU с оплатой по факту
На платформе Cloud.ru Evolution доступны виртуальные машины с GPU: A100 (40 и 80 ГБ), H100 (80 ГБ), а также V100 (32 ГБ). Последние подойдут для задач, не требующих новейшего стека драйверов и поддержки enterprise-инструментов. Можно выбрать конфигурацию с необходимыми параметрами под задачи бизнеса — от разработки и инференса до дообучения моделей.
Оплачиваются только фактически потребляемые мощности — это удобно, если GPU не используется постоянно.
Evolution Bare Metal с GPU — выделенный сервер под постоянную нагрузку и обучение
Evolution Bare Metal — готовые конфигурации физических серверов с GPU, размещенных в российских дата-центрах, в аренду. Это вариант для компаний, которым нужен доступ к аппаратной части. Подходит для постоянного инференса и обучения моделей.
С каждым сервером бесплатно предоставляются мониторинг утилизации CPU и RAM, аудит-логирование, подключение к приватной сети.
Без своего сервера: Evolution ML Inference для запуска моделей и Evolution Foundation Models с оплатой за токены
Оба сервиса — часть экосистемы AI Factory, которая также включает Evolution AI Agents для построения агентных сценариев, Evolution Notebooks для разработки, Evolution ML Finetuning для дообучения моделей и Evolution Managed RAG для работы с корпоративными знаниями.
Evolution ML Inference позволяет развернуть собственную модель без управления физическим GPU-сервером. Поддерживаются пользовательские Docker-образы и готовые модели. Инфраструктура масштабируется автоматически под текущую нагрузку — платите только за фактическое использование.
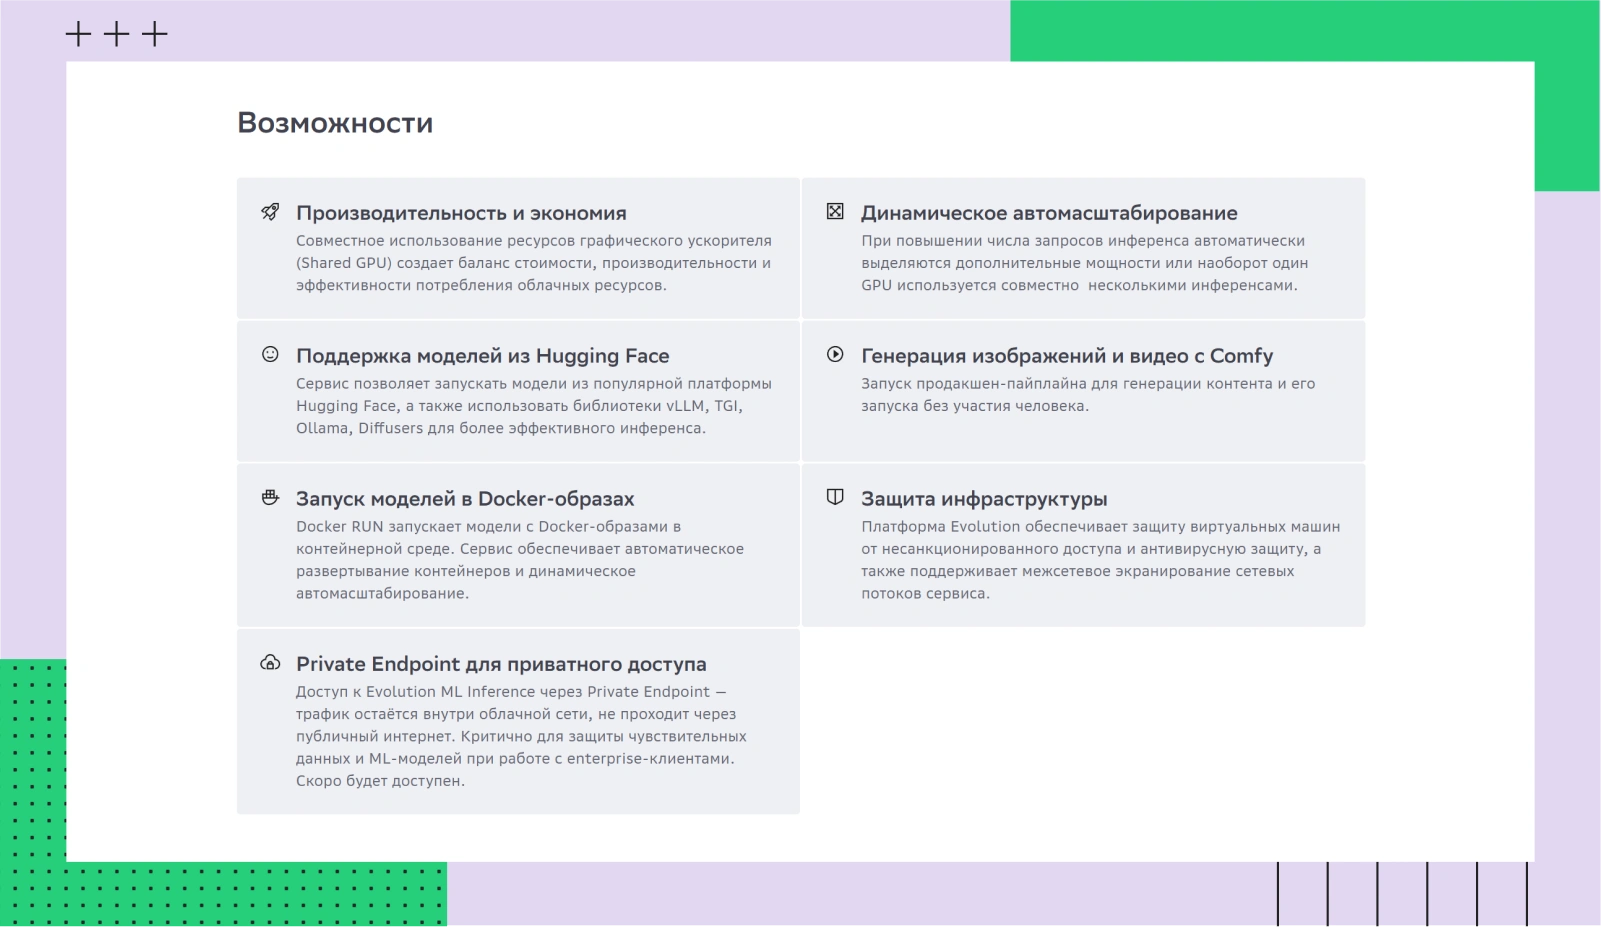 Возможности Evolution ML Inference
Evolution Foundation Models — сервис с готовыми моделями, доступными через API. Оплата рассчитывается по количеству обработанных токенов.
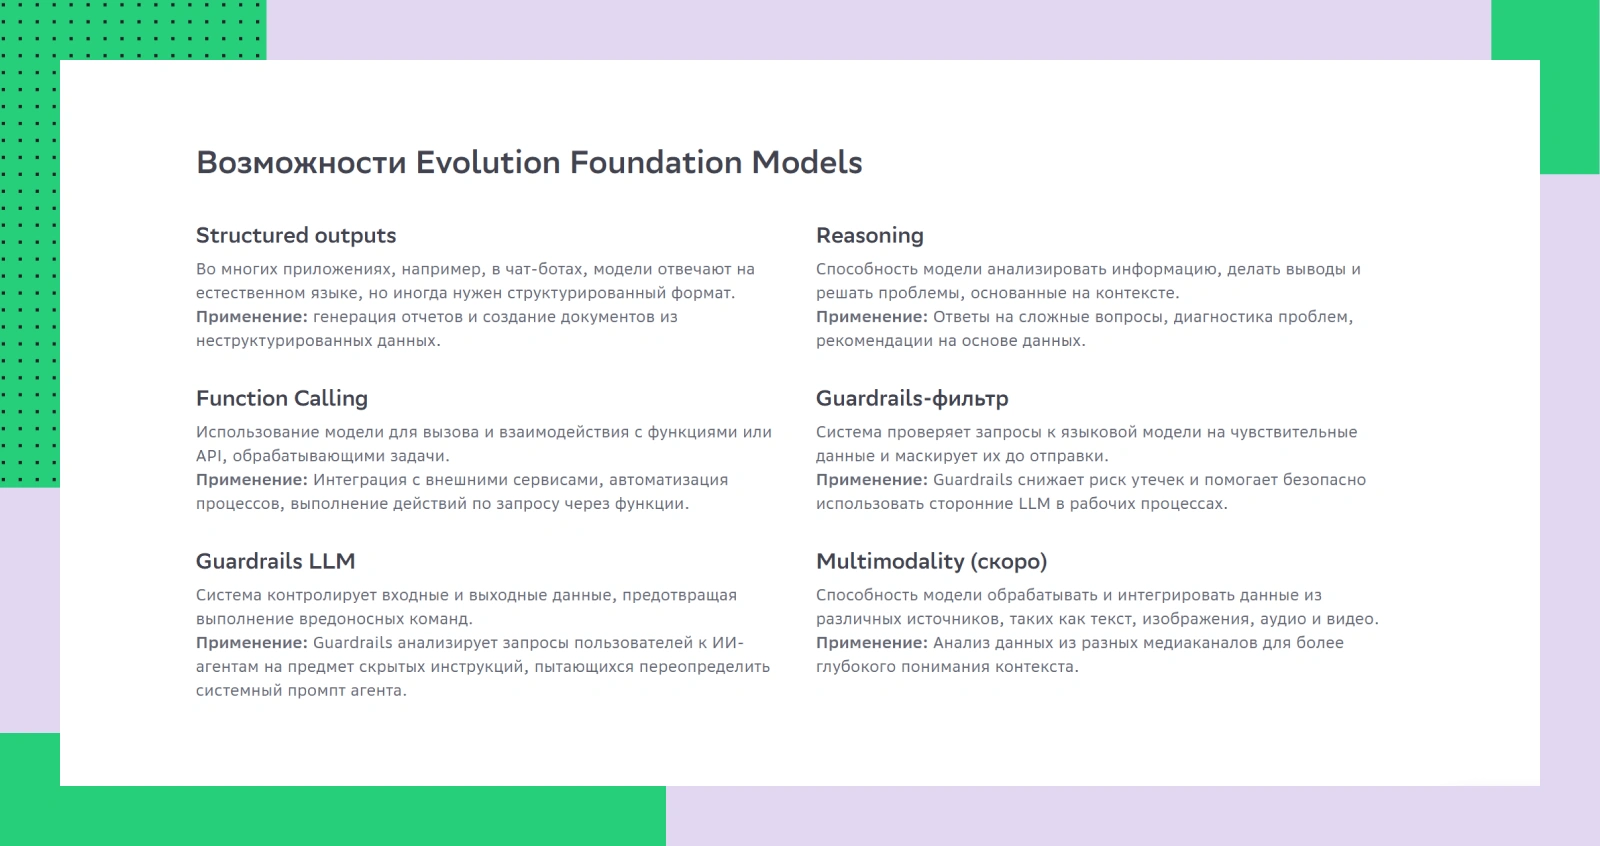 Возможности Evolution Foundation Models
Чек-лист: 8 вопросов перед выбором GPU-сервера
Какая ожидается нагрузка? Учитывайте сценарий: небольшой или масштабный инференс, обучение с нуля, дообучение.
Сколько нужно VRAM? Важно разместить саму модель и все рабочие данные.
Какая пропускная способность памяти нужна? Она влияет на скорость обработки данных.
Какое количество GPU потребуется? Для некоторых задач нужна multi-GPU-конфигурация или хотя бы две карты.
Какой объем данных предстоит обрабатывать? От этого зависят производительность и количество GPU.
Нужен ли полный контроль над инфраструктурой? Если нет, подойдет облачный сервис.
Какой срок эксплуатации планируется? Сравните стоимость сервера с расходами на аренду за аналогичный период.
Что выгоднее: свой сервер или аренда (почасовая и помесячная) ? Сравнивается стоимость своей инфраструктуры и мощностей провайдера при одинаковой полезной нагрузке.
Заключение
Выбор GPU-сервера начинается с расчета необходимой памяти и объективной оценки загрузки. Есть варианты под разные задачи. Для постоянного обучения модели подойдет выделенный сервер, для переменной — виртуальный с почасовой оплатой за аренду. Для многих задач инференса достаточно управляемого облачного сервиса.
FAQ
Что такое GPU-сервер?
Сервер с одной или несколькими видеокартами, которые позволяют быстро выполнять параллельные вычисления. Подходит для обучения и запуска нейросетей, обработки больших массивов данных и других ИИ-задач.
Сколько видеопамяти нужно для запуска LLM?
Параметры зависят от размера модели, точности и длины контекста. Также нужно место под KV-кеш и служебные операции.
Какой GPU выбрать для инференса, а какой — для обучения?
Для инференса важнее объем VRAM и пропускная способность памяти, для обучения — высокая производительность.
Что выгоднее — купить GPU-сервер или арендовать?
Покупка оправдана при постоянной загрузке. Аренда — при переменной или временной.
Сколько стоит аренда сервера с GPU в час?
Стоимость зависит от бизнес-задач, выбранного решения и условий конкретного провайдера.
Можно ли запустить нейросеть на сервере без GPU?
Да, но для мелких задач. Например, для постоянной генерации изображений и видео вариант не подходит, поскольку каждый процесс будет занимать несколько минут вместо нескольких секунд.
Что такое GPU-кластер?
Это несколько серверов с GPU, совместно работающих над задачами, с которыми не справляется один сервер. В сценарии может использоваться технология MIG (Multi-Instance GPU), позволяющая разделить одну видеокарту на инстансы. MIG поддерживается на GPU начиная с архитектуры Ampere — A100, H100, H200, B200; на более старых картах, например V100, он недоступен.