В этом разделе описано, как создать публичный эндпоинт и настроить его параметры: название, подключенные инференсы и способ распределения запросов.
При создании публичного эндпоинта новые инференсы не создаются, а остановленные инференсы не запускаются.
Перед началом работы
Убедитесь, что инференс Model RUN соответствует требованиям:
runtime инференса — vLLM, SGLang или Ollama;
подключение к VPC выключено;
инференс не удален и не находится в процессе удаления.
Если вы подключаете несколько инференсов, убедитесь, что они поддерживают одинаковый путь API и формат запросов.
Для аутентификации через токен доступа или API-ключ подготовьте включенный сервисный аккаунт.
Порядок действий
На верхней панели слева нажмите
 и перейдите в раздел AI Factory → ML Inference.
Выберите Публичные эндпоинты.
Нажмите Создать эндпоинт.
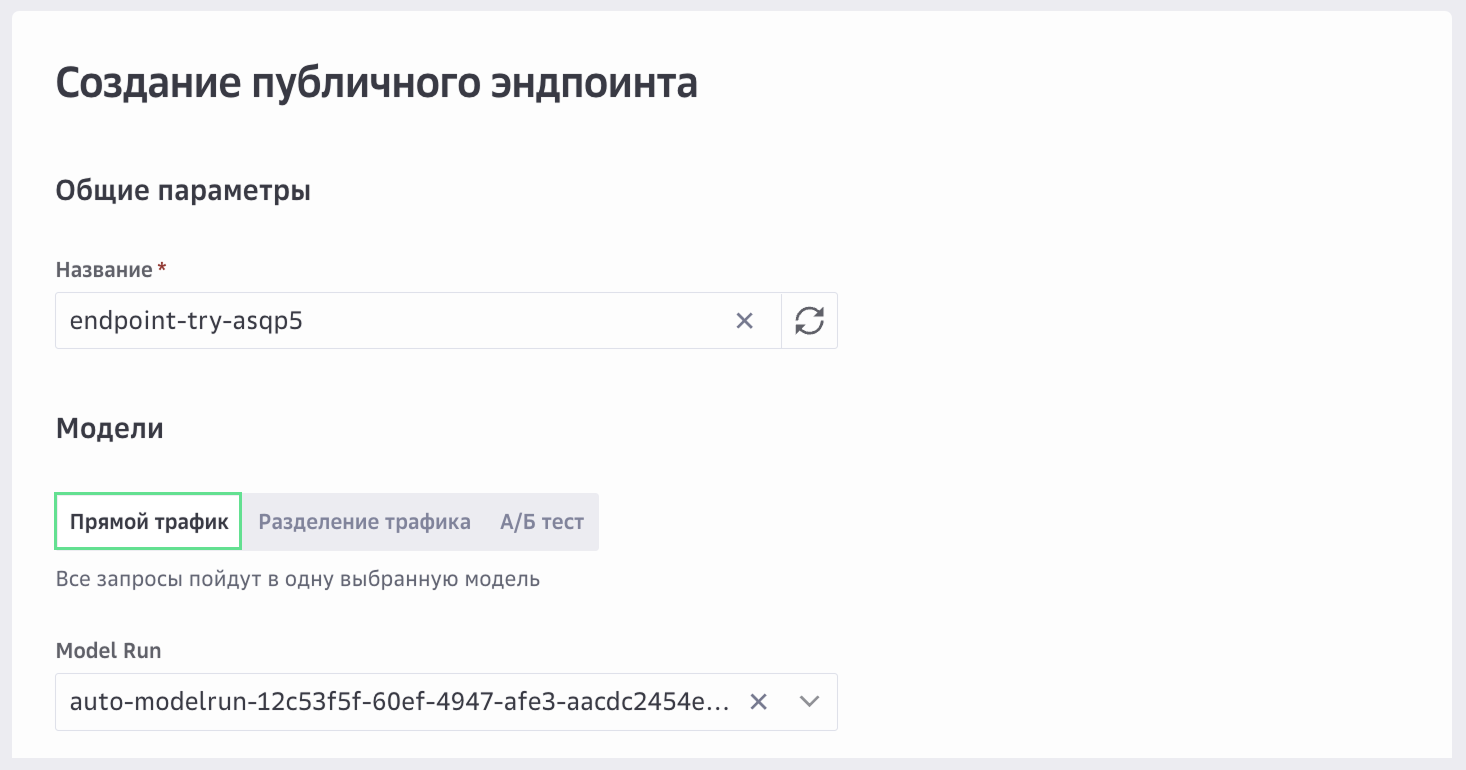
В поле Название укажите уникальное название для эндпоинта или оставьте предложенное системой.
Название эндпоинта будет передаваться в запросах к эндпоинту как значение поля model.
В блоке Модели выберите способ распределения запросов: Прямой трафик, Разделение трафика или А/Б тест.
Все запросы направляются к выбранному инференсу Model RUN.
Используйте прямой трафик, когда нужен стабильный адрес для одной модели с возможностью заменить ее позже.
В поле Model Run выберите инференс или создайте новый.
 Примечание
Инференс Model RUN нельзя удалить, пока он связан с публичным эндпоинтом. Для удаления инференса исключите его из всех публичных эндпоинтов или удалите публичные эндпоинты и дождитесь завершения операций. Ограничение не снимается при нулевом весе инференса.
(Опционально) Чтобы эндпоинт принимал запросы только от указанного сервисного аккаунта, включите опцию Аутентификация.
Настройка аутентификации публичного эндпоинта не влияет на настройки аутентификации инференсов Model RUN. Если для инференса включена авторизация, а публичный эндпоинт работает без нее, модель будет доступна без токена по публичному адресу эндпоинта. При обращении к прямому URL инференса Model RUN аутентификация по-прежнему потребуется.
ПримечаниеВызов защищенного публичного эндпоинта доступен пользователям с ролью для отправки вызовов к API ML Inference — inference.public-endpoint.invoke.
Нажмите Создать.
Следующие шаги
После публикации вы можете отправлять запросы по публичному адресу.
Успешная публикация публичного эндпоинта не означает, что подключенные инференсы готовы обрабатывать запросы. Проверьте их работоспособность. При ошибке инференса публичный эндпоинт не переключает трафик автоматически.