Data Warehouse Service (DWS) — это онлайн-база данных для анализа и обработки данных, построенная на инфраструктуре и платформе облако. Она предоставляет масштабируемые, готовые к использованию и полностью управляемые аналитические сервисы баз данных и совместима с синтаксисом ANSI/ISO SQL‑92, SQL‑99 и SQL:2003. Кроме того, DWS совместима с другими экосистемами баз данных, такими как PostgreSQL, Oracle, Teradata и MySQL. Это делает её конкурентоспособным вариантом для аналитики больших данных в масштабе петабайт в различных отраслях.
Логическая архитектура кластера
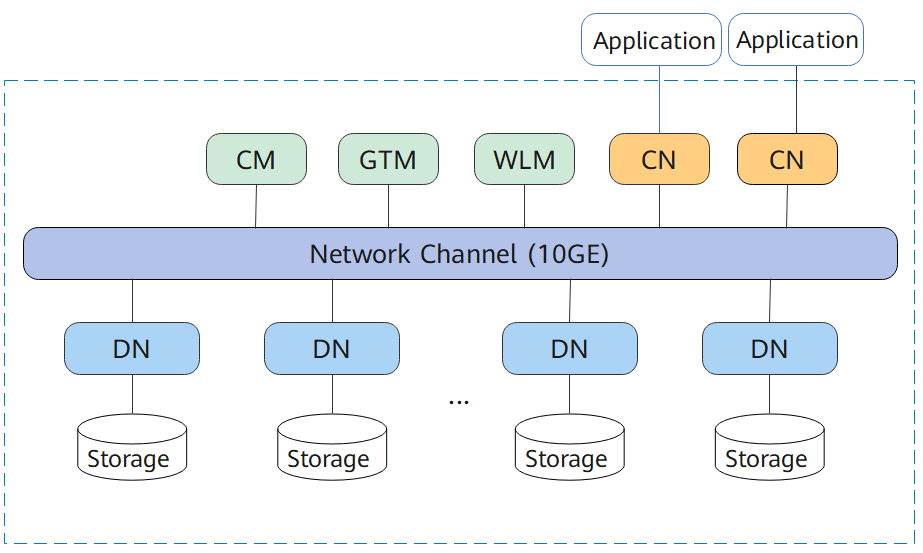
Figure 1 показывает логическую архитектуру кластера DWS. Для получения подробной информации об instance см. Table 1.
Figure 1 Logical cluster architecture
Имя | Функция | Описание |
|---|---|---|
Cluster Manager (CM) | Cluster Manager. Он управляет и контролирует состояние работы функциональных блоков и физических ресурсов в распределённой системе, обеспечивая стабильность системы. | CM состоит из CM Agent, OM Monitor и CM Server.
CM Servers развернуты в парах primary/standby для обеспечения высокой доступности системы. CM Agent подключается к primary CM Server. Если primary CM Server неисправен, standby CM Server повышается до primary, чтобы предотвратить единую точку отказа (SPOF). |
Global Transaction Manager (GTM) | Генерирует и поддерживает глобально уникальную информацию, такую как transaction ID, transaction snapshot и timestamp. | Кластер включает только одну пару GTM: один primary GTM и один standby GTM. |
Workload Manager (WLM) | Workload Manager. Он контролирует распределение системных ресурсов, чтобы предотвратить перегрузку сервиса и сбой системы, вызванный избыточной нагрузкой. | Не требуется указывать имена хостов, на которых будут развернуты WLM, поскольку installation program автоматически устанавливает WLM на каждый хост. |
Coordinator (CN) | CN получает запросы доступа от applications и возвращает результаты выполнения клиенту; разбивает задачи и распределяет их между различными DN для параллельной обработки. | CN в кластере имеют эквивалентные роли и возвращают одинаковый результат для одинакового DML‑оператора. Load balancers можно добавить между CN и applications, чтобы обеспечить прозрачность CN для applications. Если CN неисправен, load balancer автоматически подключает application к другому CN. Подробнее см. section "Associating and Disassociating ELB". CNs необходимо соединять друг с другом в распределённой транзакционной архитектуре. Чтобы уменьшить большую нагрузку, вызываемую избыточными потоками на GTMs, в кластере не следует конфигурировать более 10 CNs. DWS обрабатывает глобальную нагрузку ресурсов в кластере, используя Central Coordinator (CCN) для адаптивного динамического управления нагрузкой. При первом запуске кластера CM выбирает CN с наименьшим ID в качестве CCN. Если CCN неисправен, CM заменяет его новым. |
Datanode (DN) | DN хранит данные в режиме row-store, column-store или гибридном режиме, выполняет задачи запросов данных и возвращает результаты выполнения CNs. | В кластере несколько DN. Каждый DN хранит часть данных. DWS обеспечивает высокую доступность DN: active DN, standby DN и secondary DN. Принципы работы этих трёх компонентов следующие:
secondary DN используется исключительно в качестве резервной копии, никогда не переходя в статус active или standby при сбоях. Он экономит место, храня только данные Xlog, переданные от нового active DN, и данные, реплицированные во время сбоев оригинального active DN. Такой эффективный подход экономит одну треть объёма хранения по сравнению с традиционными методами три‑резервного копирования. |
Хранилище | Функционирует как локальные ресурсы хранилища сервера для постоянного хранения данных. | - |
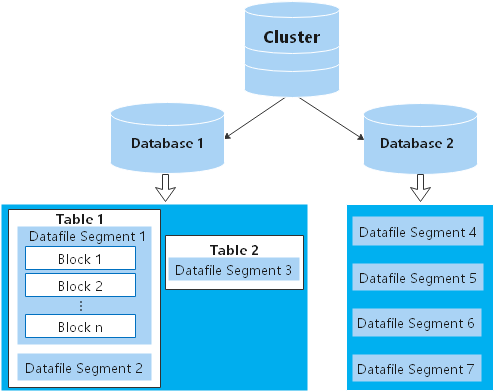
DN в кластере хранят данные на дисках. Figure 2 логически описывает объекты на каждом DN и взаимосвязи между ними.
- База данных управляет различными объектами данных и изолирована от других баз данных.
- Сегмент datafile хранит данные только в одной таблице. Таблица, содержащая более 1 ГБ данных, хранится в нескольких сегментах datafile.
- Таблица принадлежит только одной базе данных.
- Блок является базовой единицей управления базой данных, размер по умолчанию — 8 КБ.
Данные могут распределяться в режимах replication, round-robin или hash. Вы можете указать режим распределения при создании таблицы.
Figure 2 Logical database architecture
Физическая архитектура кластера
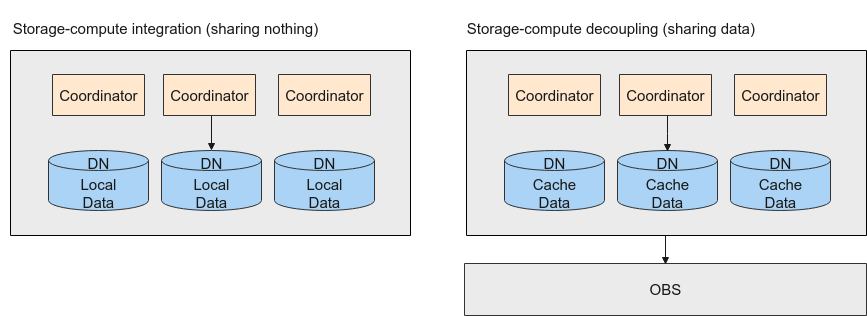
DWS поддерживает связанные и разъединённые архитектуры хранения‑вычислений.
В архитектуре, объединяющей хранение и вычисления, данные хранятся на локальных дисках DNs. В разъединённой архитектуре хранения‑вычислений локальные диски DN используются только для кэширования данных и хранения метаданных, а пользовательские данные хранятся в OBS. При необходимости можно выбрать требуемую архитектуру.
Figure 3 Выбор архитектуры
Архитектура, объединяющая хранение и вычисления
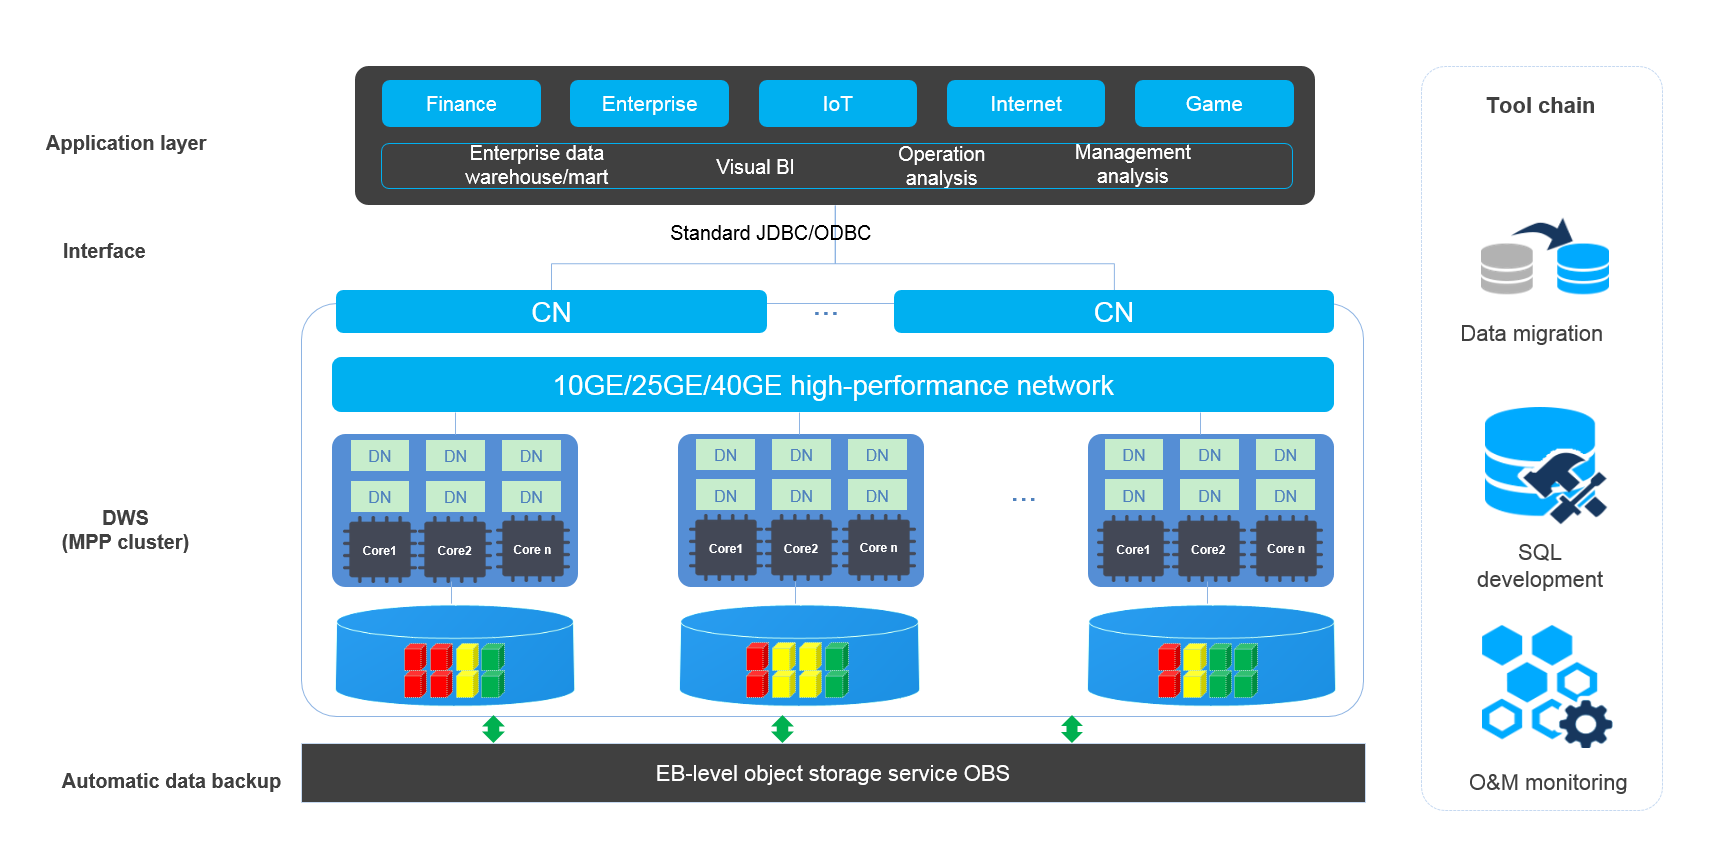
DWS использует архитектуру shared‑nothing и движок массовой параллельной обработки (MPP), состоит из множества независимых логических узлов, которые не разделяют системные ресурсы, такие как CPU, память и хранилище. В такой архитектуре данные сервиса хранятся отдельно на многочисленных узлах. Задачи анализа данных выполняются параллельно на узлах, где находятся данные. Массовая параллельная обработка данных значительно повышает скорость отклика.
Figure 4 Архитектура
- Слой приложений
Инструменты загрузки данных, инструменты Extract‑Transform‑Load (ETL), инструменты Business Intelligence (BI) и инструменты добычи и анализа данных могут быть интегрированы с DWS через стандартные интерфейсы. DWS совместим с экосистемой PostgreSQL, а синтаксис SQL совместим с Oracle и Teradata. Приложения могут быть плавно перенесены в DWS с минимальными изменениями.
- API
Приложения могут подключаться к DWS через стандартные JDBC и ODBC.
- DWS
Кластер DWS содержит узлы одного флейвора в одной подсети. Эти узлы совместно предоставляют услуги. Datanodes (DN) в кластере хранят данные на дисках. CN, или Coordinators, принимают запросы доступа от клиентов и возвращают результаты выполнения. Они также разбивают и распределяют задачи между Datanodes (DN) для параллельного выполнения.
- Автоматический бэкап данных
Снимки кластера могут автоматически бэкапиться в Object Storage Service (OBS) уровня EB, что упрощает периодический бэкап кластера в непиковые часы и обеспечивает восстановление данных после возникновения исключения кластера.
Снимок представляет собой полную бэкап DWS в указанный момент времени. Он фиксирует все данные конфигурации и сервисные данные кластера в указанный момент.
- Цепочка инструментов
DWS предоставляет широкий набор инструментов, включая General Data Service (GDS) для параллельной загрузки данных, SQL editor для разработки SQL и GDS‑Kafka для миграции данных. Кластер O&M можно мониторить в console.
Архитектура с разделением хранения и вычислений
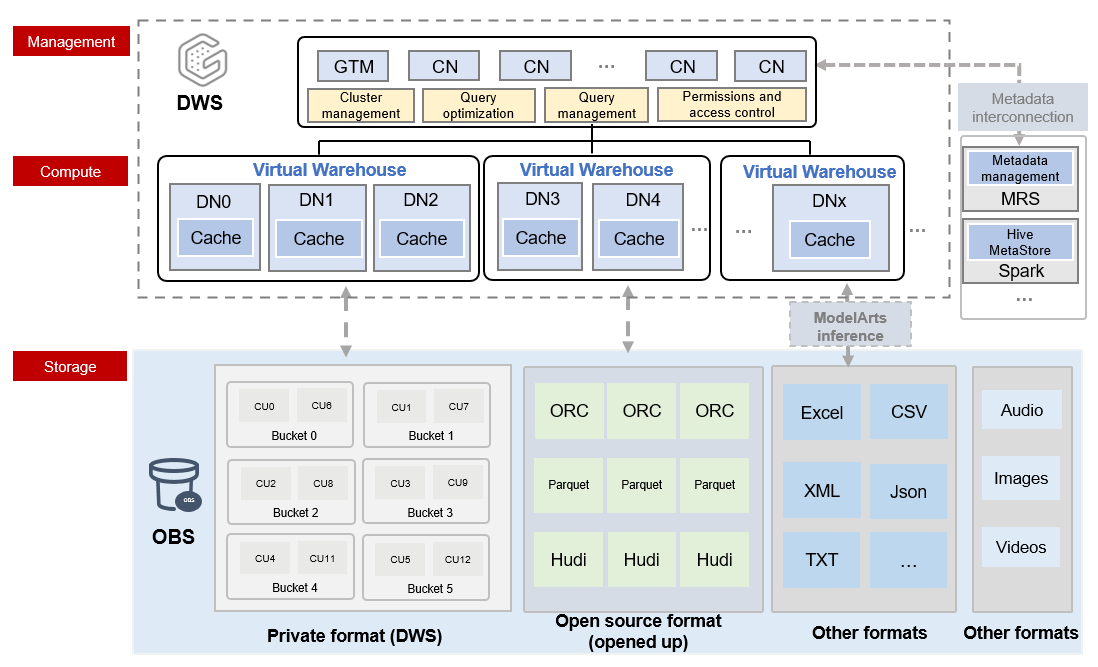
Новый DWS storage‑compute decoupled cloud‑native data warehouse предоставляет пул ресурсов, массивное хранилище и архитектуру MPP с разделёнными вычислениями и хранением. Это обеспечивает высокую эластичность, импорт и совместное использование данных в реальном времени, а также интеграцию lake warehouse.
Cloud-native data warehouse позволяет отдельное масштабирование вычислительных и хранилищных ресурсов благодаря разделённым вычислениям и хранению. Пользователи могут легко регулировать свои вычислительные возможности в пиковые и непиковые часы. Кроме того, хранилище может расширяться без ограничений, обеспечивая быстрый и гибкий отклик на изменения сервиса при сохранении экономичности.
Архитектура с разделением хранения и вычислений имеет следующие преимущества:
- Lakehouse: Он упрощает обслуживание и эксплуатацию интегрированного lakehouse. Он бесшовно интегрируется с DLI, поддерживает автоматический импорт метаданных, ускоряет запросы к внешним таблицам, позволяет выполнять объединённые запросы внутренних и внешних таблиц, а также обеспечивает чтение и запись форматов data lake, упрощая импорт данных.
- Real-time write: Он предоставляет движок хранения H‑Store, который оптимизирует запись данных в реальном времени и поддерживает высокопроизводительные пакетные записи и обновления в реальном времени.
- High elasticity: Масштабирование вычислительных ресурсов и использование on‑demand storage могут привести к значительной экономии затрат. Исторические данные не требуется мигрировать в другие носители, что обеспечивает сквозной анализ данных для отраслей, таких как финансы и Интернет.
- Data sharing: Несколько загрузок совместно используют одну копию данных в реальном времени, при этом вычислительные ресурсы изолированы. Поддерживаются множественные записи и чтения.
Figure 5 Архитектура с разделением хранения и вычислений
- Отличная масштабируемость
- Виртуальные склады (VWs) могут расширяться одновременно в зависимости от требований сервиса.
- Данные совместно используются несколькими VWs в реальном времени, устраняя необходимость дублирования данных.
- Несколько VWs повышают пропускную способность и параллелизм, обеспечивая отличную изоляцию чтения/записи и нагрузки.
- Lakehouse
- Бесшовный гибридный запрос по озёрам данных и хранилищам данных
- При анализе в озере данных вы получаете высочайшую производительность и точный контроль хранилищ данных.
Сравнение архитектур Storage-Compute Coupled и Decoupled
Версия | Объединённое хранение и вычисления | Разъединённое хранение и вычисления | ||
|---|---|---|---|---|
Носитель хранения | Данные хранятся на локальных дисках вычислительных узлов. Локальные диски могут быть cloud SSDs, в зависимости от выбранного типа хранения.
| Данные в колонковом хранилище сохраняются в Cloud Object Storage Service (OBS). Локальные диски вычислительных узлов используются в качестве кэша запросов к данным OBS. Данные в строковом хранилище по‑прежнему сохраняются на локальных дисках вычислительных узлов. | ||
Преимущество | Данные хранятся на локальных дисках вычислительных узлов, обеспечивая высокую производительность. | Архитектура разделяет хранилище и вычисления, обеспечивая слоистую эластичность, использование хранилища по запросу, быстрый масштаб вычислений, неограниченную вычислительную мощность и ёмкость. Данные, хранящиеся в объектном хранилище, снижают затраты, а несколько VWs поддерживают более высокую конкурентность. Обмен данными и интеграция lakehouse. | ||