Поиск неисправности
На странице сведений рабочей нагрузки, если отображается событие, указывающее, что pod не удалось запустить, выполните следующие действия для поиска неисправности:
- Войдите в node, где находится аномальная рабочая нагрузка.
- Проверьте ID контейнера, в котором pod рабочей нагрузки выходит аномально.
Если node использует Docker, выполните следующую команду:
docker ps -a | grep $podNameЕсли node использует containerd, выполните следующую команду:
crictl ps -a | grep $podName - Просмотрите логи контейнера.
Если node использует Docker, выполните следующую команду:
docker logs $containerIDЕсли node использует containerd, выполните следующую команду:
crictl logs $containerIDИсправьте неисправность рабочей нагрузки на основе логов.
- Проверьте журналы ошибок ОС. Например, проверьте, содержат ли логи ошибки OOM.cat /var/log/messages | grep $containerID | grep oom
Проверьте, был ли вызван системный OOM на основе логов.
Устранение неполадок
Определите причину на основе логов или событий, как указано в Table 1.
Журнал или событие | Возможная причина | Определение неисправности и решение |
|---|---|---|
Журналы Pod: код выхода 0 | В pod нет процесса. | Проверьте, может ли pod работать корректно. Для получения подробной информации см. No Process in the Pod (Exit Code: 0). |
| Проверка работоспособности не удалась. | Проверьте, правильно ли настроен liveness probe для pod. Для получения подробной информации см. Health Check Failed (Exit Code: 137). |
| Недостаточно места на диске. | Увеличьте размер диска или удалите ненужные файлы. Для получения подробной информации см. Insufficient Disk Space of the Pod. |
Pod logs: oom | Недостаточно памяти pod. | Проверьте, имеет ли pod правильные настройки ресурсов. Для получения подробной информации см. Insufficient Container Resources. |
Pod logs: Address already in use | В pod возникает конфликт между портами контейнеров. | Проверьте, есть ли конфликт портов контейнера в pod. Для получения подробной информации см. Container Port Conflict in the Pod. |
Kubernetes event:
| Секрет монтируется в рабочую нагрузку, и значение секрета не зашифровано с помощью Base64. | Для получения подробной информации о решении см. Improper Value of the Secret Mounted to the Workload. |
Kubernetes event:
| Образ контейнера x86 может запускаться на узле Arm. | Для получения подробной информации о решении см. Unmatched Container Image Tag with the Node Architecture. |
Kubernetes event:
| Версия containerd несовместима с версией tail. | Для получения подробной информации о решении см. Exit of tail -f xx in the Container Startup Command (Exit Code: 141). |
Other pod logs | Определите неисправность на основе сервисов. | Для получения подробной информации об определении неисправности см. Service Setting Checks. |
No Process in the Pod (Exit Code: 0)
- Войдите в узел, где расположена аномальная рабочая нагрузка.
- Просмотрите статус pod.
Если узел использует Docker, выполните следующую команду:
docker ps -a | grep $podNameЕсли узел использует containerd, выполните следующую команду:
crictl ps -a | grep $podNameНиже показан пример.

Если в pod нет процесса, отображается код состояния Exited (0).
Health Check Failed (Exit Code: 137)
Проверки состояния, настроенные для рабочей нагрузки, периодически выполняются на сервисах. Если происходит исключение, будет событие, указывающее на нездоровый pod, и перезапуски pod завершатся неудачей.
Если для рабочей нагрузки настроен liveness probe и количество неудачных проверок состояния превышает порог, pod будет перезапущен. На странице деталей рабочей нагрузки, если события Kubernetes содержат Liveness probe failed: Get http..., проверка состояния считается неуспешной.
Решение
Нажмите имя рабочей нагрузки, чтобы перейти на страницу деталей рабочей нагрузки, нажмите вкладку Containers. Затем выберите Health Check, чтобы проверить, корректна ли политика, и работают ли сервисы правильно.
Недостаточно места на диске Pod
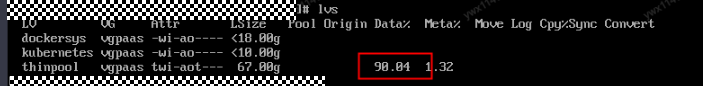
Следующее сообщение относится к thin pool диску, который выделяется из Docker диска, выбранного при создании узла. Вы можете выполнить команду lvs от пользователя root для просмотра текущего использования диска.
Thin Pool has 15991 free data blocks which is less than minimum required 16383 free data blocks. Create more free space in thin pool or use dm.min_free_space option to change behavior
Решение
Решение 1: Очистка образов
Выполните следующие действия для очистки неиспользуемых образов: Не удаляйте системные образы, такие как образ cce-pause. В противном случае создание pod может завершиться ошибкой.
Решение 2: Расширение ёмкости диска
Чтобы расширить ёмкость диска, выполните следующие действия:
- Увеличьте ёмкость диска с данными в консоли EVS.
Только емкость хранилищ EVS‑дисков может быть увеличена. Необходимо выполнить следующие операции для расширения емкости логических томов и файловых систем.
- Войдите в CCE console и нажмите название кластера, чтобы открыть консоль кластера. В панели навигации выберите Nodes. В правой панели нажмите вкладку Nodes, найдите строку, содержащую узел, и выберите More > Sync Server Data в столбце Operation.
- Войдите в узел.
- Выполните lsblk, чтобы просмотреть информацию о блочных устройствах узла.
A data disk is divided depending on the container storage Rootfs:
Недостаточно ресурсов контейнера
Если достигнут верхний предел ресурсов контейнера, OOM будет отображён в деталях события, а также в журнале:
cat /var/log/messages | grep 96feb0a425d6 | grep oom
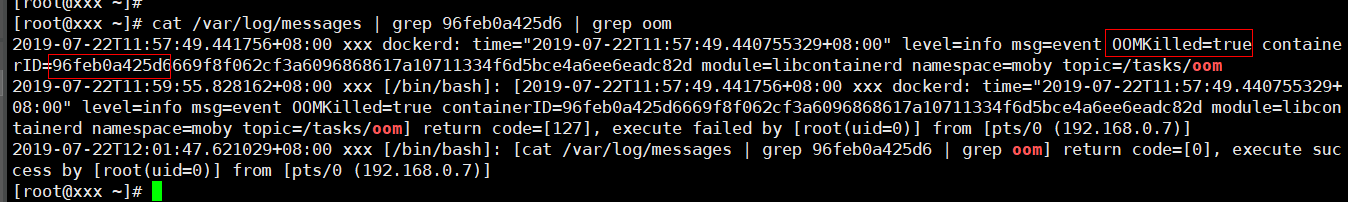
При создании рабочей нагрузки, если запрошенные ресурсы превышают сконфигурированный верхний предел, срабатывает системный OOM, и контейнер завершается неожиданно.
Конфликт портов контейнера в Pod
- Войдите в node, где находится аномальная рабочая нагрузка.
- Проверьте ID контейнера, где pod рабочей нагрузки выходит аномально.
Если node использует Docker, выполните следующую команду:
docker ps -a | grep $podNameЕсли node использует containerd, выполните следующую команду:
crictl ps -a | grep $podName - Просмотрите журналы контейнера.
Если node использует Docker, выполните следующую команду:
docker logs $containerIDЕсли node использует containerd, выполните следующую команду:
crictl logs $containerIDУстраните ошибку рабочей нагрузки на основе журналов. Как показано на следующем рисунке, порты контейнеров в одном pod конфликтуют. В результате контейнер не может быть запущен.
Рисунок 1 Сбой перезапуска Pod из‑за конфликта порта контейнера
Решение
Настройте корректные порты контейнеров, которые не конфликтуют друг с другом. Затем создайте рабочую нагрузку заново.
Если pod использует host network (с параметром hostNetwork: true), может возникнуть конфликт порта контейнера. Это происходит потому, что контейнеры в pod используют сетевой интерфейс и диапазон портов хост‑узла. Несколько pod, использующих один и тот же порт, не могут работать на одном узле.
Неправильное значение Secret, монтируемого в рабочую нагрузку
В событии отображается информация, аналогичная следующей:
Error: failed to start container "filebeat": Error response from daemon: OCI runtime create failed: container_linux.go:330: starting container process caused "process_linux.go:381: container init caused \"setenv: invalid argument\"": unknown
Коренной причиной является монтирование Secret в рабочую нагрузку, но значение Secret не зашифровано с помощью Base64.
Решение
Создайте Secret в консоли. Значение Secret автоматически шифруется с помощью Base64.
Если вы используете YAML для создания Secret, необходимо вручную зашифровать его значение с помощью Base64.
echo -n "Content to be encoded" | base64
Несоответствующий Container Image Tag архитектуре узла
При создании рабочей нагрузки на узле Arm не используется корректный тег образа. Чтобы решить проблему, используйте правильный тег образа.
Выход команды tail -f xx в команде запуска контейнера (Код выхода: 141)
Событие Kubernetes выглядит следующим образом:
the failed container exited with ExitCode: 141
Возможная причина
Устаревшая версия containerd несовместима с версией tail (≥ 8.28) в образе контейнера. В результате выполнение команды tail -f приводит к неожиданному завершению с кодом выхода 141.
Временное решение
Измените tail -f xx в параметрах запуска на sleep 2 && tail -f xx и снова создайте рабочую нагрузку.
Решение
- Обновите кластер до v1.25.16-r20, v1.27.16-r20, v1.28.15-r10, v1.29.10-r10, v1.30.6-r10, v1.31.4-r0 или более новой версии.
- Сбросьте узел и вместо этого используйте среду выполнения контейнеров Docker.
Проверки параметров сервиса
Проверьте, правильно ли выполняется команда запуска рабочей нагрузки, или есть ли в ней ошибка.
- Войдите в узел, где находится аномальная рабочая нагрузка.
- Проверьте ID контейнера, в котором pod рабочей нагрузки завершается аномально.
Если узел использует Docker, выполните следующую команду:
docker ps -a | grep $podNameЕсли узел использует containerd, выполните следующую команду:
crictl ps -a | grep $podName - Просмотрите журналы контейнера.
Если узел использует Docker, выполните следующую команду:
docker logs $containerIDЕсли узел использует containerd, выполните следующую команду:
crictl logs $containerIDПримечание: В предыдущей команде containerID указывает ID контейнера, который завершил работу.
Исправьте ошибку нагрузки на основе журналов.
Общая проблема 1: Неправильная команда запуска контейнера
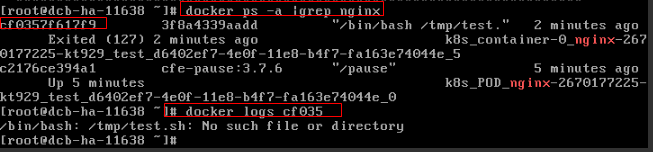
Как показано на рисунке ниже, контейнер не запускается из‑за неправильной команды запуска.
Решение
Создайте новую нагрузку и настройте правильную команду запуска.
Общая проблема 2: "fatal error: procresize: invalid arg" при запуске
После создания нагрузки она не запускается. В журналах отображается следующая ошибка:
fatal error: procresize: invalid argruntime stack:runtime.throw(0x75be20, 0x17)/usr/lib/google-golang/src/runtime/panic.go:530 +0x99runtime.procresize(0x180, 0x0)/usr/lib/google-golang/src/runtime/proc1.go:2735 +0xba6runtime.schedinit()/usr/lib/google-golang/src/runtime/proc1.go:72 +0x110runtime.rt0_go(0x7ffcd751f9f8, 0x1, 0x7ffcd751f9f8, 0x0, 0x0, 0x1, 0x7ffcd7520b77, 0x0, 0x7ffcd7520b81, 0x7ffcd7520bc3, ...)/usr/lib/google-golang/src/runtime/asm_amd64.s:109 +0x132
Согласно журналам ошибок, программа Go падает при запуске, потому что среда выполнения пытается установить GOMAXPROCS на основе видимого количества CPU и вычисляет недопустимое значение из‑за переполнения целого числа. Это происходит, когда видимое количество CPU контейнера превышает 255, а версия Go — 1.9 или 1.10. Версия Go в образе — 1.10.
В Go 1.9 и 1.10 среда выполнения использует 8‑битное целое число для хранения количества CPU, которое переполняется при наличии более 255 видимых ядер. Переполненное значение передаётся внутренней функции procresize, вызывая сбой контейнера.
Выполните следующую команду, чтобы проверить ограничение CPU узла:
cat /sys/fs/cgroup/cpuset/cpuset.cpus
Вывод 0-383, что превышает 255. Это подтверждает причину.
Решение
Используйте один из следующих методов для устранения этой проблемы:
- Обновите программу Go в образе до версии новее 1.10 (рекомендуется последняя версия). Пересоберите образ и повторно разверните.
- Добавьте переменные окружения в файл YAML рабочей нагрузки, чтобы ограничить GOMAXPROCS.- env:- name: GOMAXPROCSvalue: "1"