Если вы столкнулись с ошибкой, когда кластер доступен, но некоторые узлы в нём недоступны, вы можете исправить её, обратившись к методам, приведённым в этом разделе.
Механизм обнаружения недоступности узлов
Kubernetes предоставляет heartbeat‑сигналы, помогающие определить, доступен ли узел. Подробную информацию о механизме и интервале обнаружения см. Heartbeats.
Устранение неполадок
Возможные причины перечислены в порядке вероятности.
Проверяйте эти причины одну за другой, пока не найдёте причину ошибки.
- Пункт проверки 1: перегружен ли узел
- Пункт проверки 2: удалён ли ECS или имеет неисправность
- Пункт проверки 3: можете ли вы войти в ECS
- Пункт проверки 4: изменена ли Security Group
- Пункт проверки 5: содержат ли правила Security Group правило, позволяющее коммуникацию между Master Nodes и Worker Nodes
- Пункт проверки 6: аномален ли диск
- Пункт проверки 7: находятся ли внутренние компоненты в нормальном состоянии
- Пункт проверки 8: правильно ли настроен DNS‑адрес
- Пункт проверки 9: Был ли диск vdb на узле удалён
- Пункт проверки 10: Сервис Docker работает нормально
Пункт проверки 1: Перегружен ли узел
Симптом
Подключение узла в кластере аномально, несколько узлов сообщают об ошибках записи, но сервисы не затронуты.
Поиск неисправности
- Войдите в консоль CCE и нажмите название кластера, чтобы открыть консоль кластера. В панели навигации выберите Nodes. В правой панели нажмите вкладку Nodes, найдите строку с недоступным узлом и нажмите Monitor.
- В верхней части отображаемой страницы нажмите View More, чтобы перейти в консоль AOM и просмотреть исторические записи мониторинга.
Слишком высокое использование CPU или памяти на узле приводит к высокой задержке сети или вызывает системный OOM, поэтому узел отображается как недоступный.
Решение
- Уменьшите количество рабочих нагрузок на узле, мигрируя сервисы на другие узлы, и настройте ограничения ресурсов для рабочих нагрузок.
- Очистите данные на узлах CCE в кластере.
- Ограничьте квоты CPU и памяти для каждого контейнера.
- Добавьте больше узлов в кластер.
- Перезапустите узел в консоли ECS.
- Добавьте дополнительные узлы и разверните контейнеры с высоким потреблением памяти отдельно.
- Сбросьте узлы.
После того как узел станет доступным, рабочие нагрузки восстанавливаются.
Проверьте пункт 2: удалён ли ECS или неисправен.
- Проверьте, доступен ли кластер.
Войдите в консоль CCE и проверьте, доступен ли кластер.
- Если кластер недоступен, например, произошла ошибка, выполните операции, описанные в How Do I Locate the Fault When a Cluster Is Unavailable?.
- Если кластер работает, но некоторые узлы в кластере недоступны, перейдите к 2.
- Войдите в консоль ECS и просмотрите статус ECS.
- Если статус ECS Deleted, вернитесь в консоль CCE, удалите соответствующий узел из списка узлов кластера и затем создайте новый.
- Если статус ECS Stopped или Frozen, сначала восстановите ECS. Восстановление узла занимает около 3 минут.
- Если ECS неисправен, перезапустите его, чтобы устранить ошибку.
- Если статус ECS Running, войдите в ECS и найдите причину неисправности, обратившись к Check Item 7: Whether Internal Components Are Normal.
Проверьте пункт 3: можете ли вы войти в ECS.
- Войдите в консоль ECS.
- Проверьте, совпадает ли отображаемое имя узла с именем на VM и можно ли использовать пароль или ключ для входа в узел.
Если имена узлов несоответствуют и вход в узел с использованием пароля или ключа невозможен, это означает, что при создании ECS возникла проблема Cloud-Init. В этом случае перезапустите узел и отправьте запрос в службу поддержки ECS‑персоналу для выявления причины.
Пункт проверки 4: изменена ли Security Group
Войдите в консоль VPC. В панели навигации выберите Access Control > Security Groups и найдите master node security group кластера.
Имя этой security group имеет формат {cluster_name}-cce-control-{ID}. Вы можете выполнить поиск security group по имени кластера, а затем -cce-control-.
Проверьте, изменились ли правила security group. Подробную информацию о security groups см. в How Do I Modify Cluster Security Group Rules?.
Пункт проверки 5: содержат ли правила Security Group правило, позволяющее связь между Master Nodes и Worker Nodes.
Проверьте, существует ли такое правило security group.
При добавлении узла в кластер добавьте правила security group, показанные на рисунке ниже, в security group cluster-name-cce-control-random-ID, чтобы обеспечить доступность добавленного узла. Это необходимо, если к VPC подсети узла добавлен вторичный CIDR‑блок и подсеть находится во вторичном CIDR‑блоке. Однако если вторичный CIDR‑блок уже был добавлен к VPC при создании кластера, этот шаг не требуется.
Подробную информацию о security groups см. в How Do I Modify Cluster Security Group Rules?.
Пункт проверки 6: аномальный ли Диск.
Каждый новый узел оснащён 100‑GiB Диском с данными, предназначенным для Docker. Если этот Диск с данными будет удалён или повреждён, сервис Docker будет нарушен, и узел станет недоступным.
Нажмите имя узла и проверьте, был ли удалён Диск с данными, подключённый к узлу. Если диск был отсоединён от узла, необходимо присоединить к узлу другой Диск с данными и перезапустить узел. После этого узел можно восстановить.
Пункт проверки 7: нормальны ли внутренние компоненты.
- Войдите в узел и проверьте, работают ли правильно следующие ключевые компоненты:
- kubelet
- kube-proxy
- Компоненты сети
- yangtse: используется кластерами, которые используют сети VPC или Cloud Native 2.0
- canal: используется кластерами, которые используют сети контейнерных туннелей
- Runtime: Docker или containerd
- chronyd
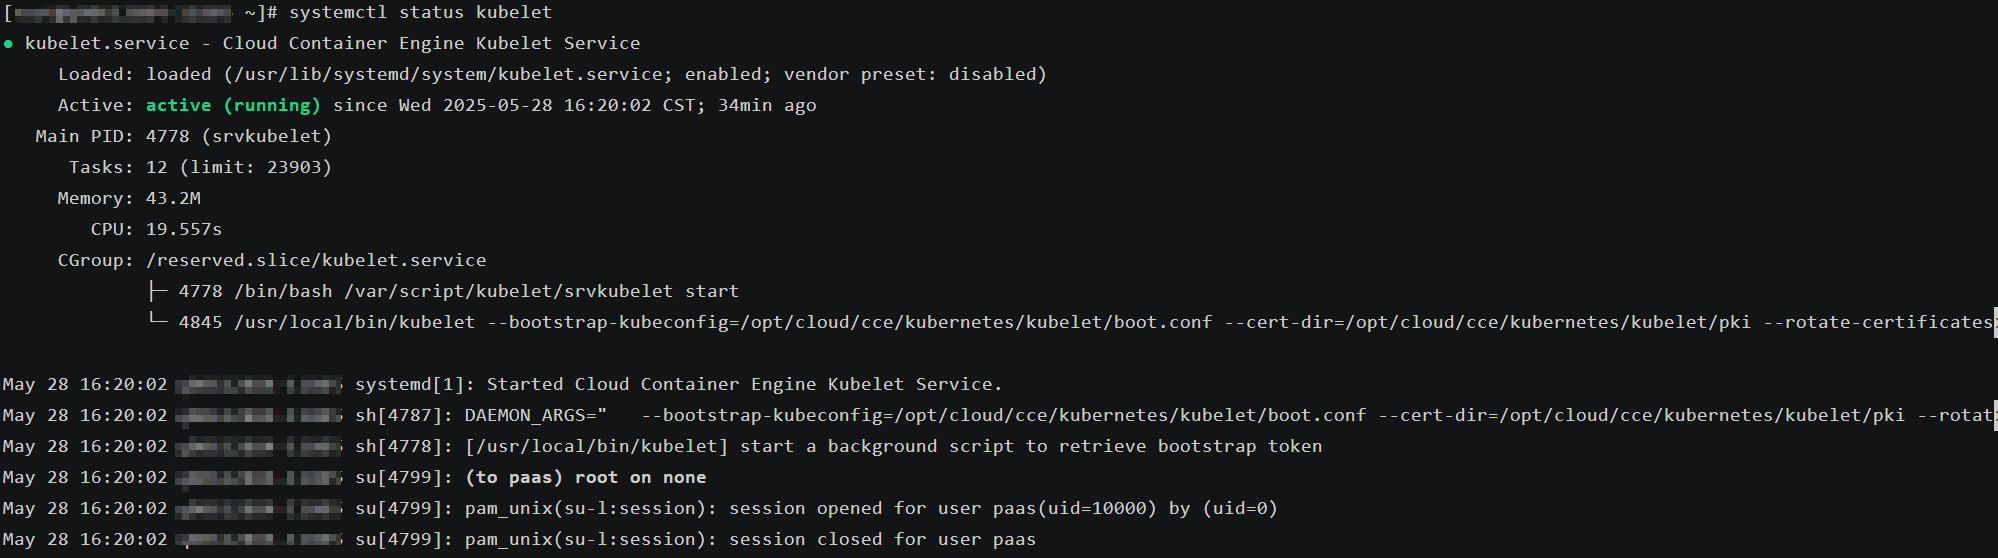
Проверьте состояние компонента. Например, чтобы проверить состояние kubelet, выполните следующую команду:
systemctl status kubeletkubelet — это имя компонента. При необходимости его можно заменить.
Ожидаемый вывод показан на рисунке ниже.
- Если компонент находится не в состоянии Active, перезапустите его. Укажите команду перезапуска в зависимости от неисправного компонента. Если неисправен yangtse, выполните следующую команду:systemctl restart yangtse
Проверьте состояние компонента снова.
systemctl status yangtse - Если после перезапуска компонента статус узла всё ещё не восстановлен, отправьте заявку в службу поддержки и свяжитесь с customer service.
Пункт проверки 8: правильно ли настроен DNS‑адрес
- Войдите в узел и проверьте, записаны ли сбои разрешения доменных имён в /var/log/cloud-init-output.log.
cat /var/log/cloud-init-output.log | grep resolv
Если вывод команды содержит следующую информацию, это означает, что произошёл сбой разрешения доменных имён.
Could not resolve host: Unknown error
- На узле выполните ping доменного имени, которое не удалось разрешить на предыдущем шаге, чтобы проверить, может ли доменное имя быть разрешено.
- Если доменное имя не отвечает на ping, DNS не может разрешить IP‑адрес. Проверьте, совпадает ли DNS‑адрес в файле /etc/resolv.conf с тем, который настроен в подсети VPC. В большинстве случаев DNS‑адрес в файле настроен неверно, что приводит к невозможности разрешить доменное имя. Чтобы устранить проблему, измените конфигурацию DNS подсети VPC и перезапустите узел.
- Если доменное имя отвечает на ping, конфигурация DNS‑адреса корректна. Проверьте наличие других неисправностей.
Пункт проверки 9: Был ли удалён vdb Disk на узле
Если диск vdb на узле был удалён, вы можете восстановить узел, обратившись к What Should I Do If the vdb Disk of a Node Is Damaged and the Node Can't Be Recovered After Reset?
Пункт проверки 10: Работает ли сервис Docker нормально
- Выполните следующую команду, чтобы проверить, запущен ли сервис Docker:systemctl status docker
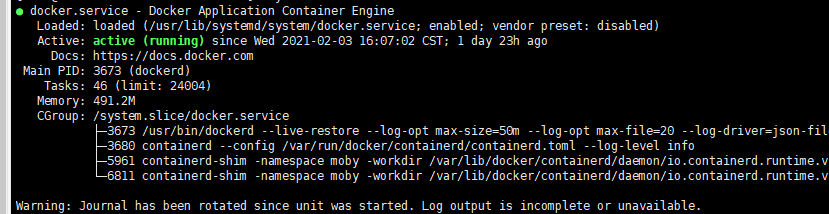
Если команда не может быть выполнена или статус сервиса Docker не активен, определите причину или при необходимости обратитесь в техническую поддержку.
- Выполните следующую команду, чтобы проверить количество контейнеров на узле:docker ps -a | wc -l
Если команда приостановлена, выполняется слишком долго или количество аномальных контейнеров превышает 1000, следует проверить, не создаются и не удаляются ли нагрузки повторно. При частом создании и удалении большого количества контейнеров может возникнуть множество аномальных контейнеров, которые невозможно быстро очистить.
В этом случае прекратите повторное создание и удаление нагрузок или используйте больше узлов для распределения нагрузки. Обычно узел восстанавливается через некоторое время. При необходимости выполните команду docker rm {container_id} для ручного удаления аномальных контейнеров.