Если вы столкнулись с ошибкой, когда кластер доступен, но некоторые узлы в нём недоступны, вы можете исправить её, обратившись к методам, приведённым в этом разделе.
Механизм обнаружения недоступности узла
Kubernetes предоставляет heartbeat, чтобы помочь вам определить, доступен ли узел. Подробную информацию о механизме и интервале обнаружения см. в Heartbeats.
Устранение неполадок
Возможные причины перечислены в порядке вероятности.
Проверяйте эти причины одну за другой, пока не найдёте причину неисправности.
- Пункт проверки 1: Перегружен ли узел
- Пункт проверки 2: Удалён ли ECS или имеет неисправность
- Пункт проверки 3: Можете ли вы войти в ECS
- Пункт проверки 4: Было ли изменено Security Group
- Пункт проверки 5: Содержат ли правила Security Group правило, позволяющее связь между мастер‑узлами и рабочими узлами
- Пункт проверки 6: Есть ли аномалии с диском
- Пункт проверки 7: Нормальны ли внутренние компоненты
- Пункт проверки 8: Правильно ли настроен DNS‑адрес
- Пункт проверки 9: Был ли удалён vdb Disk на узле
- Пункт проверки 10: Сервис Docker работает нормально
Пункт проверки 1: Является ли узел перегруженным
Симптом
Подключение узла в кластере аномально, несколько узлов сообщают об ошибках записи, но сервисы не затронуты.
Локализация неисправности
- Войдите в консоль CCE и нажмите название кластера, чтобы открыть консоль кластера. В панели навигации выберите Nodes. В правой панели нажмите вкладку Nodes, найдите строку, содержащую недоступный узел, и нажмите Monitor.
- В верхней части отображаемой страницы нажмите View More, чтобы перейти в консоль AOM и просмотреть исторические записи мониторинга.
Слишком высокое использование CPU или памяти на узле приведёт к высокой задержке сети или вызовет системный OOM, поэтому узел отображается как недоступный.
Решение
- Уменьшите количество рабочих нагрузок на узле, мигрируя сервисы на другие узлы, и настройте ограничения ресурсов для рабочих нагрузок.
- Очистите данные на узлах CCE в кластере.
- Ограничьте квоты CPU и памяти для каждого контейнера.
- Добавьте больше узлов в кластер.
- Перезапустите узел в консоли ECS.
- Добавьте дополнительные узлы и разверните контейнеры с высоким потреблением памяти отдельно.
- Сбросьте узлы.
После того как узел станет доступным, рабочие нагрузки будут восстановлены.
Проверьте пункт 2: удалён ли ECS или неисправен
- Проверьте, доступен ли кластер.
Войдите в консоль CCE и проверьте, доступен ли кластер.
- Если кластер недоступен, например, произошла ошибка, выполните операции, описанные в How Do I Locate the Fault When a Cluster Is Unavailable?
- Если кластер работает, но некоторые узлы в кластере недоступны, перейдите к 2.
- Log in to the ECS console and view the ECS status.
- If the ECS status is Deleted, go back to the CCE console, delete the corresponding node from the node list of the cluster, and then create a new one.
- If the ECS status is Stopped or Frozen, restore the ECS first. It takes about 3 minutes to restore the node.
- Если ECS неисправен, перезапустите его, чтобы устранить ошибку.
- If the ECS status is Running, log in to the ECS and locate the fault by referring to Check Item 7: Whether Internal Components Are Normal.
Проверьте пункт 3: можете ли вы войти в ECS
- Войдите в консоль ECS.
- Проверьте, совпадает ли отображаемое имя узла с именем на VM, и можно ли использовать пароль или ключ для входа в узел.
Если имена узлов несоответствуют и вход в узел с использованием пароля или ключа невозможен, это означает, что при создании ECS возникла проблема Cloud-Init. В этом случае перезапустите узел и отправьте запрос в службу поддержки ECS для выявления первопричины.
Пункт проверки 4: изменена ли Security Group
Войдите в консоль VPC. В панели навигации выберите Access Control > Security Groups и найдите Security Group мастер‑узла кластера.
Имя этой Security Group имеет формат {cluster_name}-cce-control-{ID}. Вы можете выполнить поиск Security Group по имени кластера, а затем по -cce-control-.
Проверьте, изменены ли правила Security Group. Подробную информацию о Security Group см. в How Do I Modify Cluster Security Group Rules?
Пункт проверки 5: содержат ли правила Security Group правило, позволяющее связь между мастер‑узлами и worker‑узлами
Проверьте, существует ли такое правило Security Group.
При добавлении узла в кластер добавьте правила Security Group, показанные на рисунке ниже, в Security Group cluster-name-cce-control-random-ID, чтобы обеспечить доступность добавленного узла. Это необходимо, если к VPC подсети узла добавлен вторичный CIDR‑блок и подсеть находится во вторичном CIDR‑блоке. Однако если вторичный CIDR‑блок уже был добавлен к VPC при создании кластера, этот шаг не требуется.
Подробную информацию о Security Group см. в How Do I Modify Cluster Security Group Rules?
Пункт проверки 6: аномален ли диск
Каждый новый узел оснащён 100‑GiB Диском с данными, предназначенным для Docker. Если этот Диск с данными будет удалён или повреждён, сервис Docker будет нарушен, и узел станет недоступным.
нажмите node name и проверьте, был ли удалён Диск с данными, присоединённый к узлу. Если диск был отсоединён от узла, необходимо присоединить к узлу другой Диск с данными и перезапустить узел. После этого узел можно восстановить.
Пункт проверки 7: находятся ли внутренние компоненты в нормальном состоянии.
- Войдите в узел и проверьте, работают ли правильно следующие ключевые компоненты:
- kubelet
- kube-proxy
- Компоненты сети
- yangtse: используется кластерами, которые используют сети VPC или Cloud Native 2.0
- canal: используется кластерами, которые используют сети контейнерных туннелей
- Runtime: Docker или containerd
- chronyd
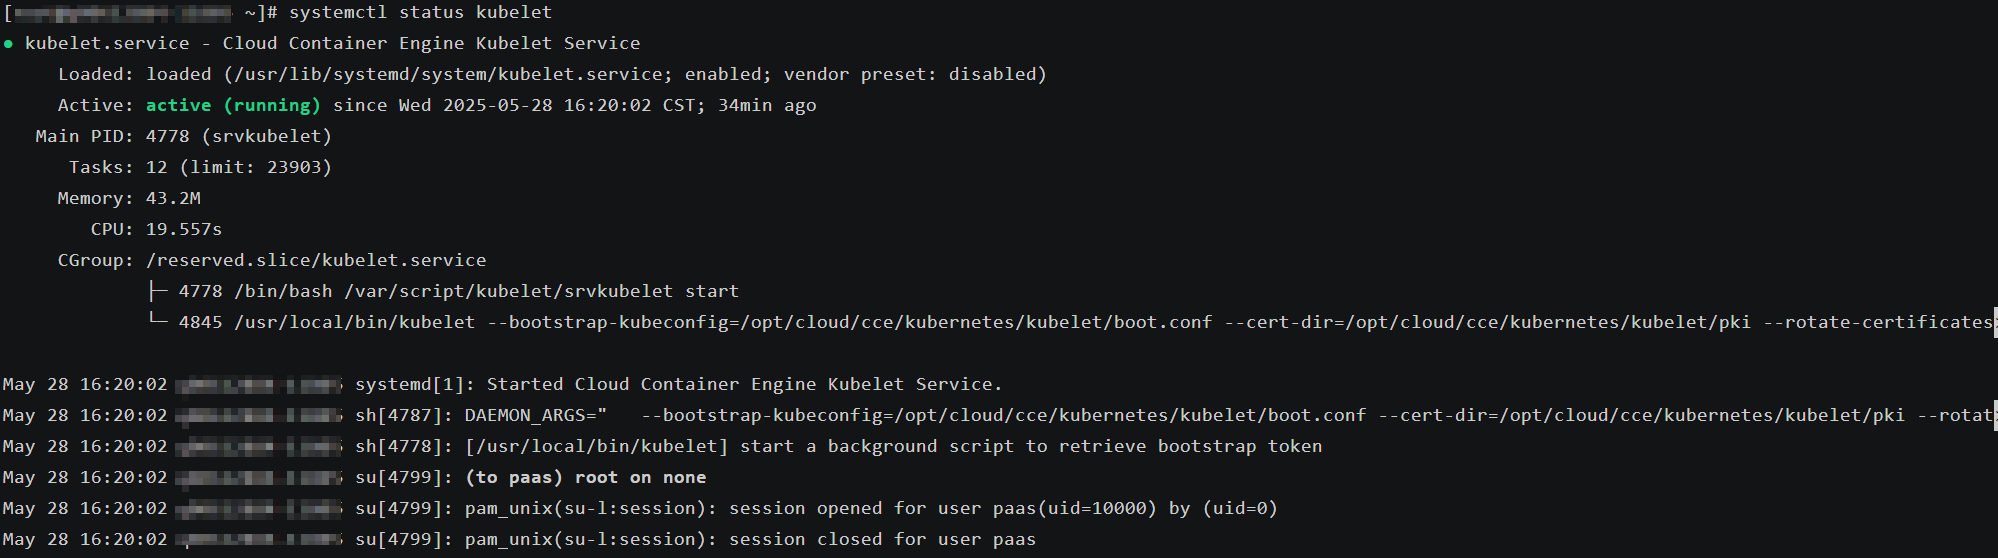
Проверьте состояние компонента. Например, чтобы проверить состояние kubelet, выполните следующую команду:
systemctl status kubeletkubelet — это имя компонента. При необходимости вы можете заменить его.
Ожидаемый вывод показан на рисунке ниже.
- Если компонент находится не в состоянии Active, перезапустите его. Укажите команду перезапуска в зависимости от неисправного компонента. Если неисправен yangtse, выполните следующую команду:systemctl restart yangtse
Проверьте состояние компонента еще раз.
systemctl status yangtse - Если после перезапуска компонента статус узла все еще не восстановлен, отправьте заявку в службу поддержки и свяжитесь со службой поддержки клиентов.
Пункт проверки 8: правильно ли настроен DNS‑адрес
- Войдите в узел и проверьте, записаны ли какие-либо сбои разрешения доменных имен в /var/log/cloud-init-output.log.
cat /var/log/cloud-init-output.log | grep resolv
Если вывод команды содержит следующую информацию, это означает, что произошёл сбой разрешения доменных имён.
Could not resolve host: Unknown error
- На узле выполните ping доменного имени, которое не удалось разрешить на предыдущем шаге, чтобы проверить, может ли доменное имя быть разрешено.
- Если доменное имя нельзя пропинговать, DNS не может разрешить IP‑адрес. Проверьте, совпадает ли DNS‑адрес в файле /etc/resolv.conf с тем, который настроен в подсети VPC. В большинстве случаев DNS‑адрес в файле настроен неверно, что приводит к невозможности разрешения доменного имени. Чтобы устранить проблему, скорректируйте конфигурацию DNS подсети VPC и перезапустите узел.
- Если доменное имя можно пропинговать, конфигурация DNS‑адреса верна. Проверьте наличие других неисправностей.
Пункт проверки 9: удалён ли vdb Disk на узле
Если vdb disk на узле был удалён, вы можете восстановить узел, обратившись к What Should I Do If the vdb Disk of a Node Is Damaged and the Node Can't Be Recovered After Reset?
Пункт проверки 10: работает ли Docker Service нормально
- Выполните следующую команду, чтобы проверить, запущен ли сервис Docker:systemctl status docker
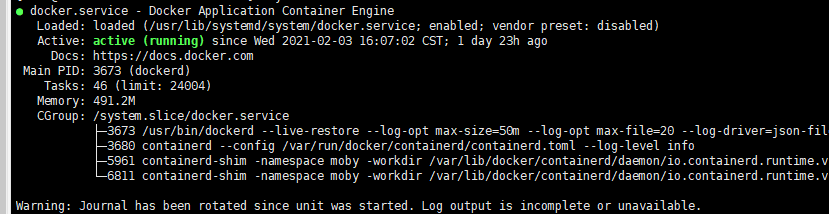
Если команда не может быть выполнена или статус сервиса Docker не активен, определите причину или при необходимости обратитесь в техническую поддержку.
- Выполните следующую команду, чтобы проверить количество контейнеров на узле:docker ps -a | wc -l
Если команда приостановлена, выполняется слишком долго или обнаружено более 1000 аномальных контейнеров, следует проверить, не создаются и не удаляются ли нагрузки повторно. При частом создании и удалении большого количества контейнеров может возникнуть множество аномальных контейнеров, которые невозможно быстро очистить.
В этом случае прекратите повторное создание и удаление нагрузок или используйте больше узлов для распределения нагрузки. Обычно узел восстанавливается через некоторое время. При необходимости выполните команду docker rm {container_id} для ручного удаления аномальных контейнеров.