Сценарий
CDM поддерживает миграцию таблиц и файлов между однородными или разнородными источниками данных. Для получения подробной информации о поддерживаемых источниках данных см. Supported Data Sources.
Ограничения
- Функция записи грязных данных зависит от OBS.
- JSON‑файл задания для импорта не может превышать 1 МБ.
- Размер файла для передачи не может превышать 1 ТБ.
- Имена полей параметров источника и назначения не могут содержать амперсанд (&) или знак процента (%).
Предварительные требования
- Связь создана. Для получения подробной информации см. Creating a Link Between CDM and a Data Source.
- Кластер CDM может взаимодействовать с источником данных.
Процедура
- Войдите в консоль управления и выберите Service List > Cloud Data Migration. В левой панели навигации выберите Cluster Management. Найдите целевой кластер и нажмите Job Management.
- Выберите . Отобразится страница настройки задания.
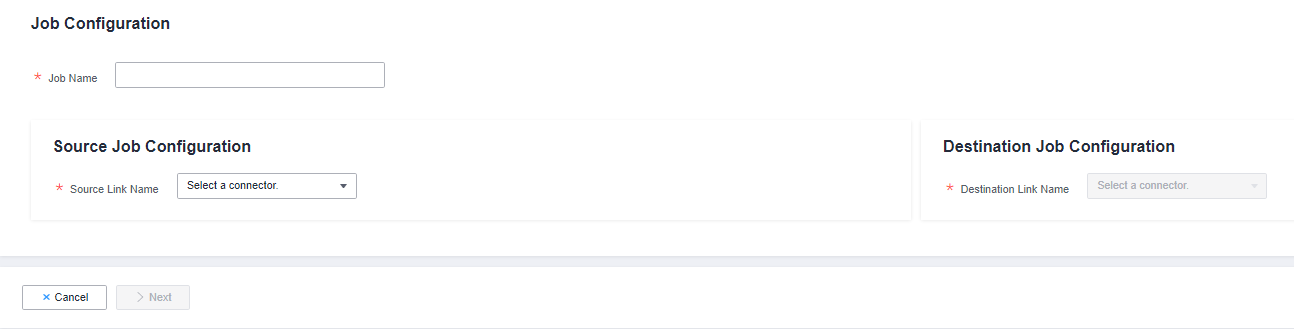
Рисунок 1 Создание задания миграции
- Выберите исходные и целевые ссылки.
- Job Name: Введите строку, содержащую от 1 до 240 символов. Имя может содержать цифры, буквы, дефисы (-), подчёркивания (_) и точки (.), и не может начинаться с дефиса (-) или точки (.). Пример значения oracle2rds_t.
- Source Link Name: Выберите источник данных, из которого будут экспортированы данные.
- Destination Link Name: Выберите источник данных, в который будут импортированы данные.
- Настройте параметры исходной ссылки.
Параметры различаются в зависимости от источников данных. Для получения подробной информации о параметрах задания для других типов источников данных см. Table 1 и Table 2.
Table 1 Описание параметров исходной ссылкиИсточник миграции
Описание
Настройки параметров
OBS
Данные могут быть извлечены в формате CSV, JSON или бинарном формате. Данные, извлечённые в бинарном формате, не зависят от разрешения файлов, что обеспечивает высокую производительность и более подходит для миграции файлов.
Для получения подробной информации см. From OBS.
- MRS HDFS
- FusionInsight HDFS
- Apache HDFS
Данные HDFS могут быть экспортированы в формате CSV, Parquet или бинарном формате и могут быть сжаты в нескольких форматах.
Для получения подробной информации см. From HDFS.
- MRS HBase
- FusionInsight HBase
- Apache HBase
- CloudTable Service
Данные могут быть экспортированы из MRS, FusionInsight HD, открытого Apache Hadoop HBase или CloudTable. Необходимо знать все семейства столбцов и имена полей таблиц HBase.
Для получения подробной информации см. From HBase/CloudTable.
- MRS Hive
- FusionInsight Hive
- Apache Hive
Данные могут быть экспортированы из Hive через JDBC API.
Если источником данных является Hive, CDM автоматически будет разбивать данные на разделы, используя файл разбиения данных Hive.
Для получения подробной информации см. From Hive.
DLI
Данные могут быть экспортированы из DLI.
Для получения подробной информации см. From DLI.
- FTP
- SFTP
Данные FTP и SFTP могут быть экспортированы в формате CSV, JSON или бинарном формате.
Для получения подробной информации см. From FTP/SFTP.
- HTTP
Эти коннекторы используются для чтения файлов по URL HTTP/HTTPS, например для чтения публичных файлов в сторонних системах объектного хранилища и веб‑дисков.
В настоящее время данные могут экспортироваться только из URL HTTP.
Для получения подробной информации см. From HTTP.
Data Warehouse Service
Данные могут быть экспортированы из DWS.
Для получения подробной информации см. From DWS.
SAP HANA
Данные могут быть экспортированы из SAP HANA.
Для получения подробной информации см. From SAP HANA.
- RDS for PostgreSQL
- RDS for SQL Server
- Microsoft SQL Server
- PostgreSQL
Данные могут быть экспортированы из облачных сервисов баз данных.
База данных, не являющаяся облачной, может быть создана в локальном дата-центре или развернута на ECSs, либо быть сервисом баз данных в сторонних облаках.
При экспорте данных из этих источников CDM использует JDBC API для извлечения данных. Параметры задания для источника миграции одинаковы. Для получения подробной информации см. From PostgreSQL/SQL Server.
MySQL
Данные могут быть экспортированы из базы данных MySQL.
Для получения подробной информации см. From MySQL.
Oracle
Данные могут быть экспортированы из базы данных Oracle.
Для получения подробной информации см. From Oracle.
Шардинг базы данных
Данные можно экспортировать из шарда.
Для получения подробной информации см. From a Database Shard.
- MongoDB
- Document Database Service
Данные можно экспортировать из MongoDB или DDS.
ПРИМЕЧАНИЕ:Источники данных MongoDB и DDS с включённым SSL не поддерживаются.
Для получения подробной информации см. From MongoDB/DDS.
Redis
Данные можно экспортировать из open source Redis.
Для получения подробной информации см. From Redis.
- Apache Kafka
- DMS Kafka
- MRS Kafka
Данные могут экспортироваться только в Cloud Search Service (CSS).
Для получения подробной информации см. From Kafka/DMS Kafka.
- Cloud Search Service
- Elasticsearch
Данные могут экспортироваться из CSS или Elasticsearch.
Для получения подробной информации см. From Elasticsearch or CSS.
MRS Hudi
Данные могут экспортироваться из MRS Hudi.
Для получения подробной информации см. From MRS Hudi.
MRS ClickHouse
Данные могут экспортироваться из MRS ClickHouse.
Для получения подробной информации см. From MRS ClickHouse.
LogHub (SLS)
Данные могут экспортироваться из LogHub (SLS).
Для получения подробной информации см. From LogHub (SLS).
ShenTong database
Данные могут быть экспортированы из ShenTong database.
Для получения подробной информации см. From a ShenTong Database.
- Настройте параметры задания для места назначения миграции на основе Table 2.Table 2 Описание параметра
Место назначения миграции
Описание
Настройки параметра
OBS
Файлы (даже в большом объёме) могут быть пакетно мигрированы в OBS в формате CSV или binary.
Для получения подробной информации см. To OBS.
MRS HDFS
Вы можете выбрать формат сжатия при импорте данных в HDFS.
Для получения подробной информации см. To HDFS.
MRS HBase
CloudTable Service
Данные могут быть импортированы в HBase. Алгоритм сжатия можно задать при создании новой таблицы HBase.
Для получения подробной информации см. To HBase/CloudTable.
MRS Hive
Данные могут быть быстро импортированы в MRS Hive.
Для получения подробной информации см. To Hive.
- MySQL
- SQL Server
- PostgreSQL
Данные могут быть импортированы в облачные сервисы баз данных.
Для получения подробной информации о том, как использовать JDBC API для импорта данных, см. To MySQL/SQL Server/PostgreSQL.
DWS
Данные могут быть импортированы в DWS.
Для получения подробной информации см. To DWS.
Oracle
Данные могут быть импортированы в базу данных Oracle.
Для получения подробной информации см. To Oracle.
DLI
Данные могут быть импортированы в DLI.
Для получения подробной информации см. To DLI.
Elasticsearchor Cloud Search Service (CSS)
Данные могут быть импортированы в CSS.
Для получения подробной информации см. To Elasticsearch/CSS.
MRS Hudi
Данные могут быть быстро импортированы в MRS Hudi.
Для получения подробной информации см. To MRS Hudi.
MRS ClickHouse
Данные могут быть быстро импортированы в MRS ClickHouse.
Для получения подробной информации см. To MRS ClickHouse.
MongoDB
Данные могут быть быстро импортированы в MongoDB.
ПРИМЕЧАНИЕ:Источники данных MongoDB с включённым SSL не поддерживаются.
Для получения подробной информации см. To MongoDB.
- После настройки параметров нажмите Next. Отобразится страница вкладки Map Field.
Если файлы мигрируют между FTP, SFTP, OBS и HDFS, и параметр File Format источника миграции установлен в Binary, файлы будут передаваться напрямую, без сопоставления полей.
В остальных сценариях CDM автоматически сопоставляет поля исходной и целевой таблиц. Необходимо проверить правильность сопоставления и формата времени. Например, проверьте, может ли тип поля источника быть преобразован в тип поля назначения.
Рисунок 2 Сопоставление полей
 Note
- Если поля источника и назначения не совпадают, их можно перетаскивать для корректировки.
- На странице вкладки Map Field, если CDM не удалось получить все столбцы путем получения образцов значений (например, когда данные экспортируются из HBase, CloudTable или MongoDB, или когда данные мигрируют из SFTP/FTP в DLI, существует высокая вероятность, что CDM не получит все столбцы), вы можете нажать
 и выбрать Add a new field для добавления новых полей, чтобы обеспечить полноту импортируемых в пункт назначения данных.
- При использовании реляционной базы данных, Hive, DLI или MRS Hudi в качестве источника миграции получить образцы значений невозможно.
- На странице Map Field вы можете нажать
 для добавления пользовательских констант, переменных и выражений.
- Имена столбцов отображаются, когда источником миграционной задачи является OBS, необходимо мигрировать CSV‑файлы, и параметр Extract first row as columns установлен в Yes.
- Если в качестве назначения используется SQLServer, поля типа timestamp нельзя записать. Необходимо изменить их тип (например, на datetime), чтобы запись была возможна.
- Если в качестве источника используется Hive, данные типов array и map могут быть прочитаны.
- При использовании бинарного формата для миграции файлов в файлы сопоставление полей не участвует.
- Если данные импортируются в DWS, необходимо выбрать распределительные столбцы в полях назначения. Рекомендуется выбирать распределительные столбцы в соответствии со следующими принципами:
- Используйте первичный ключ в качестве распределительного столбца.
- Если несколько сегментов данных объединены в первичные ключи, укажите все первичные ключи в качестве распределительного столбца.
- В случае отсутствия первичного ключа, если распределительный столбец не выбран, DWS по умолчанию использует первый столбец в качестве распределительного столбца. В результате существует риск дисбаланса данных.
- CDM поддерживает преобразование полей. Нажмите
 , затем нажмите Create Converter.
Рисунок 3 Создание конвертера
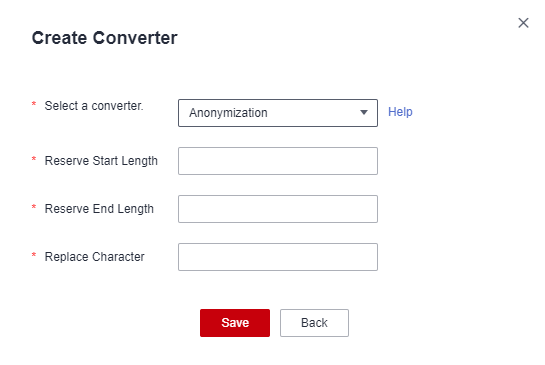
CDM поддерживает следующие конвертеры:
- Anonymization: скрывает ключевые данные в строке.
Например, если необходимо преобразовать 12345678910 в 123****8910, настройте параметры следующим образом:
- Установите Reserve Start Length в 3.
- Установите Reserve End Length в 4.
- Установите Replace Character в *.
- Trim автоматически удаляет пробелы до и после строки.
- Reverse string автоматически меняет порядок символов в строке. Например, преобразуйте ABC в CBA.
- Replace string заменяет указанную строку символов.
- Expression conversion использует язык выражений JSP (EL) для преобразования текущего поля или строки данных.
- Remove line break удаляет символы переноса строки, такие как \n, \r и \r\n, из поля.
NoteЕсли Use SQL Statement установлен в Yes в конфигурации исходного задания, конвертеры создать нельзя.
- Anonymization: скрывает ключевые данные в строке.
- Нажмите Next, задайте параметры задания и нажмите Show Advanced Attributes, чтобы отобразить и настроить необязательные параметры.
Figure 4 Task parameters
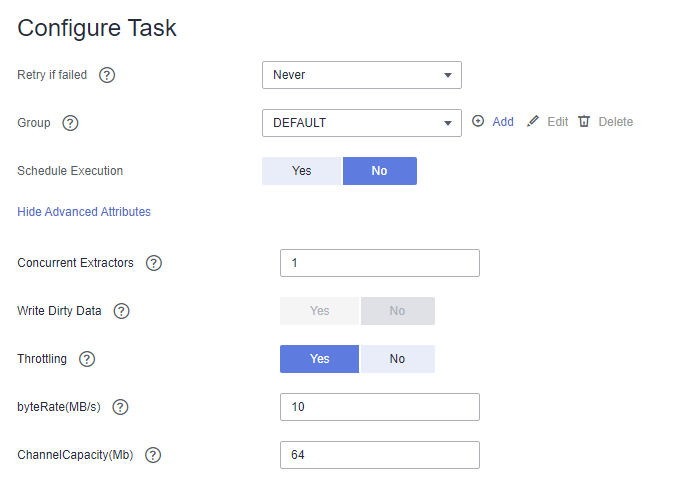
Table 3 описывает связанные параметры.
Table 3 Parameter descriptionParameter
Description
Example Value
Retry upon Failure
Вы можете выбрать Retry 3 times или Never.
Рекомендуется настраивать автоматический повтор только для заданий миграции файлов или заданий миграции баз данных с включённым Import to Staging Table, чтобы избежать несогласованности данных, вызванной повторными записями.
ПРИМЕЧАНИЕ:Если вы хотите задать параметры в DataArts Studio DataArts Factory для планирования задачи миграции CDM, не настраивайте этот параметр. Вместо этого задайте параметр Retry upon Failure для узла CDM в DataArts Factory.
Never
Job
Выберите группу, в которой находится задача. Группа по умолчанию — DEFAULT. На странице Job Management задачи могут отображаться, запускаться или экспортироваться по группе.
DEFAULT
Schedule Execution
Если вы выберете Yes, вы сможете задать время начала, цикл и период действия задачи. Подробности см. в Configuring a Scheduled CDM Job.
NOTE:Если вы используете DataArts Studio DataArts Factory для планирования задачи миграции CDM и настраиваете этот параметр, обе конфигурации вступят в силу. Чтобы обеспечить единообразную логику сервиса и избежать конфликтов планирования, включите планирование задач в DataArts Factory и не настраивайте запланированную задачу для этой задачи в DataArts Migration.
No
Concurrent Extractors
Максимальное количество потоков задачи для чтения данных из источника
NOTE:Количество одновременных потоков может быть меньше или равно значению этого параметра для некоторых источников данных, не поддерживающих одновременное извлечение, например, CSS и ClickHouse.
CDM переносит данные с помощью задач миграции данных. Это происходит следующим образом:
- Когда задачи миграции данных отправляются, CDM разбивает каждую задачу на несколько подзадач на основе параметра Concurrent Extractors в конфигурации задачи.NOTE:
Задачи для разных источников данных могут разбиваться по различным измерениям. Некоторые задачи могут не разбиваться на основе параметра Concurrent Extractors.
- CDM отправляет задачи в работающий пул последовательно. Задачи (определяемые параметром Maximum Concurrent Extractors) выполняются одновременно. Избыточные задачи ставятся в очередь.
Установив соответствующие значения для этого параметра и параметра Maximum Concurrent Extractors, вы можете ускорить миграцию.
Настройте количество одновременных экстракторов в соответствии со следующими правилами:
- При миграции данных в файлы CDM не поддерживает несколько одновременных задач. В этом случае установите один процесс для извлечения данных.
- Если каждая строка таблицы содержит данные объёмом не более 1 МБ, данные могут извлекаться одновременно. Если каждая строка содержит более 1 МБ данных, рекомендуется извлекать данные в одном потоке.
- Установите Concurrent Extractors для задачи, исходя из Maximum Concurrent Extractors кластера. Рекомендуется, чтобы Concurrent Extractors было меньше, чем Maximum Concurrent Extractors.
- Если назначением является DLI, рекомендуется установить количество одновременных экстракторов равным 1. В противном случае запись данных может завершиться ошибкой.
Максимальное количество одновременных экстракторов для кластера зависит от типа флейвора кластера CDM. Рекомендуется установить максимальное количество одновременных экстракторов вдвое больше количества vCPU кластера CDM. Например, максимальное количество одновременных экстракторов для кластера с 8 vCPU и 16 ГБ памяти равно 16.
1
Concurrent Loaders
Number of Loaders to be concurrently executed
Этот параметр отображается только когда HBase или Hive используется в качестве источника данных назначения.
3
Number of split retries
Количество повторных попыток, когда выполнение разделения не удалось. Значение 0 указывает, что повторные попытки не будут выполнены.
0
Write Dirty Data
Записывать грязные данные. По умолчанию этот параметр установлен в No.
Грязные данные в CDM — это данные в недопустимом формате. Если исходные данные содержат грязные данные, рекомендуется включить эту функцию. В противном случае задание миграции может завершиться ошибкой.
ПРИМЕЧАНИЕ:Грязные данные могут быть записаны только в пути OBS. Поэтому этот параметр доступен только при наличии ссылки OBS.
Yes
Write Dirty Data Link
Этот параметр отображается только когда Write Dirty Data установлен в Yes.
Можно выбрать только ссылку OBS.
obs_link
OBS Bucket
Этот параметр отображается только когда Write Dirty Data Link является ссылкой на OBS.
Имя OBS Bucket, в который будут записываться грязные данные.
dirtydata
Dirty Data Directory
Этот параметр отображается только когда Write Dirty Data установлен в Yes.
Грязные данные сохраняются в каталоге для хранения грязных данных в OBS. Грязные данные сохраняются только при настройке этого параметра.
Вы можете перейти в этот каталог, чтобы запросить данные, которые не удалось обработать или которые были отфильтрованы во время выполнения задания, и проверить исходные данные, не соответствующие правилам преобразования или очистки.
/user/dirtydir
Max. Error Records in a Single Shard
Этот параметр отображается только когда Write Dirty Data установлен в Yes.
Если количество записей с ошибками в отдельном map превышает верхний предел, задание автоматически завершится, и импортированные данные нельзя будет откатить. Рекомендуется использовать временную таблицу в качестве целевой. После импорта данных переименуйте таблицу или объедините её с окончательной таблицей данных.
0
Throttling
Включение throttling снижает нагрузку чтения на источник. Он контролирует скорость передачи CDM, а не трафик NIC.
ПРИМЕЧАНИЕ:- Throttling можно включить для заданий миграции файлов, не являющихся бинарными.
- Чтобы настроить throttling для нескольких заданий, умножьте скорость на количество одновременно выполняемых заданий.
- Throttling не поддерживается для бинарной передачи между файлами.
Yes
byteRate(MB/s)
Максимальная скорость чтения/записи задачи
Для задачи миграции данных в Hive, DLI, JDBC, OBS или HDFS можно включить ограничение скорости. Если разрешено несколько одновременных задач, фактическую максимальную скорость можно вычислить, умножив значение этого параметра на количество одновременных задач.
ПРИМЕЧАНИЕ:Скорость задаётся целым числом, большим 1.
20
Intermediate Queue Cache Size (MB)
Объём данных, который может кэшировать промежуточная очередь. Значение может принимать значения от 1 до 500. Значение по умолчанию — 64.
Если объём данных строки превышает значение этого параметра, миграция может завершиться неудачей. Если значение этого параметра слишком велико, кластер может работать некорректно. Установите подходящее значение для этого параметра и используйте значение по умолчанию (64), если не указано иное.
64
- Когда задачи миграции данных отправляются, CDM разбивает каждую задачу на несколько подзадач на основе параметра Concurrent Extractors в конфигурации задачи.
- Нажмите Save или Save and Run. На отображаемой странице вы можете просмотреть статус задачи.Note
Статус задачи может быть New, Pending, Booting, Running, Failed, Succeeded или Stopped.
Pending указывает, что задача ожидает планирования системой, а Booting указывает, что данные для миграции анализируются.