Введение
Дополнение CCE AI Suite (NVIDIA GPU) помогает использовать и управлять GPU в ваших кластерах. Оно поддерживает доступ к GPU в контейнерах и помогает эффективно запускать и поддерживать вычислительно‑интенсивные нагрузки на основе GPU в облачно‑нативных средах. С этим дополнением как стандартные, так и Turbo кластеры CCE могут выполнять планирование GPU, автоматически устанавливать драйверы, управлять средами выполнения и мониторить производительность. Это обеспечивает полную поддержку GPU‑нагрузок на протяжении всего их жизненного цикла. Чтобы запускать узлы GPU в кластере, необходимо установить это дополнение.
Как работает nvidia-gpu-device-plugin
nvidia-gpu-device-plugin является одним из основных компонентов CCE AI Suite (NVIDIA GPU). Как мост между платформой контейнеров и аппаратным обеспечением GPU, nvidia-gpu-device-plugin абстрагирует физические GPU в ресурсы, которые могут быть обнаружены и запланированы платформой контейнеров. Это решает проблемы распределения и использования GPU в контейнеризованных средах.
Этот компонент работает как DaemonSet, чтобы GPU на каждом узле могли быть обнаружены kubelet и переданы в Kubernetes. Для использования GPU на узлах достаточно указать запросы ресурсов GPU в спецификациях pod. kubelet самостоятельно не обнаруживает GPU‑устройства. Вместо этого он полагается на nvidia-gpu-device-plugin для регистрации и передачи информации о GPU. nvidia-gpu-device-plugin запускается на каждом узле с GPU и использует протокол gRPC для связи с kubelet Device Plugin Manager и завершения регистрации. Ниже показан рабочий процесс. Рисунок 1 Отчетность о ресурсах GPU и их состояние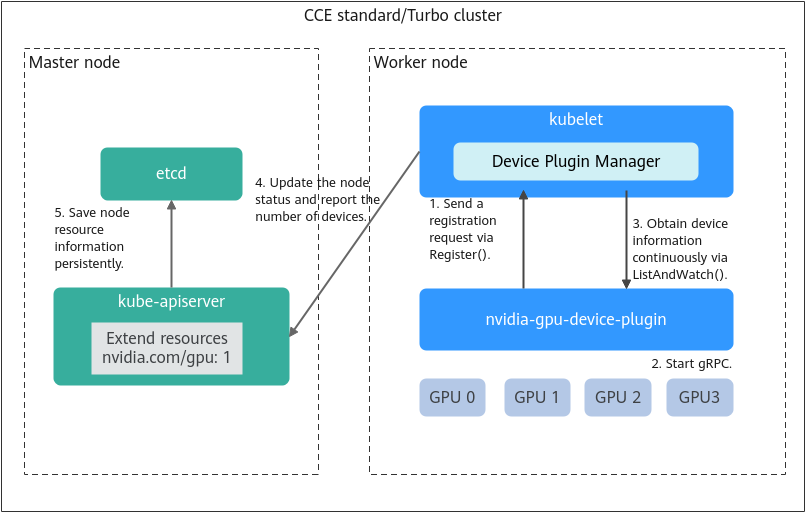
Ограничения
- Загружаемый драйвер должен быть файлом .run.
- Поддерживаются только драйверы NVIDIA Tesla, а не драйверы GRID.
- При установке или переустановке дополнения убедитесь, что адрес загрузки драйвера корректен и доступен. CCE не проверяет действительность адреса.
- Это дополнение только позволяет загрузить драйвер и выполнить скрипт установки. Состояние дополнения лишь показывает, как работает дополнение, а не то, установлен ли драйвер успешно.
- CCE не гарантирует совместимость версии драйвера GPU и версии библиотеки CUDA вашего приложения. Необходимо проверять совместимость самостоятельно.
- Если в пользовательском образе ОС установлен драйвер GPU, CCE не может гарантировать совместимость драйвера GPU с другими компонентами GPU, например, компонентами мониторинга, используемыми в CCE.
Установка дополнения
- Войдите в CCE console и нажмите название кластера, чтобы открыть консоль кластера.
- В панели навигации выберите Add-ons. В правой панели найдите дополнение CCE AI Suite (NVIDIA GPU) и нажмите Install.
- Определите, включить ли Use DCGM-Exporter to Observe DCGM Metrics. После включения этой функции DCGM-Exporter будет развернут на узле GPU.Notice
Если версия дополнения 2.7.40 или новее, DCGM-Exporter может быть развернут. DCGM-Exporter сохраняет возможности сообщества и не поддерживает режим совместного использования или виртуализацию GPU.
- Настройте параметры дополнения.
Table 1 Add-on parameters Parameter
Описание
Драйвер кластера по умолчанию
Все узлы GPU в кластере используют один и тот же драйвер. Вы можете выбрать подходящую версию драйвера GPU или настроить ссылку на драйвер и ввести ссылку для загрузки драйвера NVIDIA.
ПРИМЕЧАНИЕ:- Если ссылка для загрузки является интернет‑адресом, например, https://us.download.nvidia.com/tesla/470.103.01/NVIDIA-Linux-x86_64-470.103.01.run, привяжите EIP к каждому узлу GPU. Подробную информацию о том, как получить ссылку на драйвер, см. Obtaining a Driver Link from the Internet.
- Если ссылка для загрузки является URL OBS, привязывать EIP к узлам GPU не требуется. Подробную информацию о том, как получить ссылку на драйвер, см. Obtaining a Driver Link from the OBS Link.
- Убедитесь, что версия драйвера NVIDIA соответствует узлам GPU.
- Если версия драйвера изменена, перезапустите узлы, чтобы применить изменения.
NoteПосле установки дополнения вы можете настроить виртуализацию GPU и драйверы пула узлов на вкладке Heterogeneous Resources в Settings.
- Нажмите Install.Note
Если дополнение удалено, новые GPU‑pod'ы, запланированные на узлы, не смогут работать корректно, однако уже работающие GPU‑pod'ы на узлах не будут затронуты.
Проверка дополнения
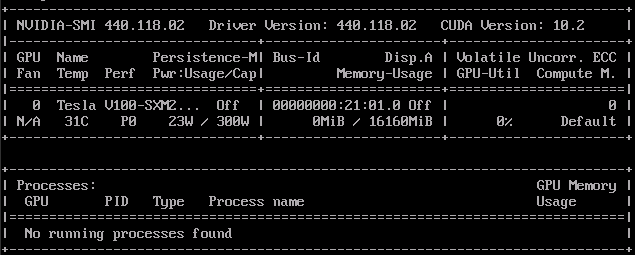
После установки дополнения выполните команду nvidia-smi на узле GPU и в контейнере, который планирует ресурсы GPU, чтобы проверить доступность устройства GPU и драйвера.
- Узел GPU:
- Если версия дополнения старше 2.0.0, выполните следующую команду:cd /opt/cloud/cce/nvidia/bin && ./nvidia-smi
- Если версия add-on 2.0.0 или более поздняя, выполните следующую команду:cd /usr/local/nvidia/bin && ./nvidia-smi
- Если версия дополнения старше 2.0.0, выполните следующую команду:
- Pod:
- Если версия кластера v1.27 или более ранняя, выполните следующую команду:cd /usr/local/nvidia/bin && ./nvidia-smi
- Если версия кластера v1.28 или более поздняя, выполните следующую команду:cd /usr/bin && ./nvidia-smi
- Если версия кластера v1.27 или более ранняя, выполните следующую команду:
Если возвращена информация о GPU, устройство доступно и add-on установлен.
Управление add-on
После установки add-on вы можете при необходимости выполнять его обновление или откат. Перед обновлением или откатом add-on CCE AI Suite (NVIDIA GPU) убедитесь, что на узле GPU не запущены рабочие нагрузки виртуализации GPU. Если на узле GPU есть рабочие нагрузки виртуализации GPU, при обновлении или откате add-on необходимо выполнить drain узла GPU.
Обновление драйвера GPU
Если используемая библиотека CUDA несовместима с версией драйвера NVIDIA, соответствующий GPU‑узел становится недоступным. Чтобы решить проблему, необходимо обновить версию драйвера. Как стандартные, так и Turbo‑кластеры CCE поддерживают обновление драйверов на уровнях кластера и пула узлов. В этом разделе рассматривается процедура обновления драйвера кластера. Для получения подробной информации о том, как обновить драйвер пула узлов, см. Upgrading the Driver Version of a GPU Node Using a Node Pool.
Обновление драйвера NVIDIA кластера подразумевает переустановку драйвера во время перезапуска узла. После указания требуемой версии драйвера кластера в консоли необходимо вручную перезапустить GPU‑узел. Для этого выполните следующие действия:
- Укажите версию драйвера кластера. Вы можете указать версию драйвера кластера одним из следующих способов:
- Upgrading the add-on: In the navigation pane, choose Add-ons. In the right pane, find the CCE AI Suite (NVIDIA GPU) add-on and click Upgrade. In the window that slides out from the right, change the value of Default Cluster Driver to a proper one, for example, 535.216.03, and click OK.
- Editing the add-on: In the navigation pane, choose Add-ons. In the right pane, find the CCE AI Suite (NVIDIA GPU) add-on and click Edit. In the window that slides out from the right, change the value of Default Cluster Driver to a proper one, for example, 535.216.03, and click OK.
- Configuring heterogeneous resources: In the navigation pane, choose Settings. In the right pane, click the Heterogeneous Resources tab, change the value of Default Cluster Driver to a proper one, for example, 535.216.03, and click Confirm Settings.
- Perform rolling restart on the GPU node and install the driver of the specified version. Evict pods on the GPU node before restarting the node. For details, see Draining a Node. When draining a GPU node, make sure to reserve enough GPU resources on other nodes to meet pod scheduling needs. This helps avoid pod scheduling issues due to inadequate resources and ensures smooth service operation.
- В панели навигации выберите Nodes. В правой панели нажмите вкладку Nodes и просмотрите все GPU‑узлы.
- Нажмите имя GPU‑node. На отображённой странице нажмите Restart в правом верхнем углу. После перезапуска GPU‑node подождите от 5 до 10 минут, пока установка драйвера не завершится. Вы можете проверить статус дополнения CCE AI Suite (NVIDIA GPU), чтобы увидеть, установлен ли драйвер. Если статус дополнения изменится на Running, драйвер установлен.
- Войдите в node, проверьте версию установленного на нём драйвера и подтвердите, что обновление драйвера GPU‑node прошло успешно. Команда получения версии драйвера зависит от версии CCE AI Suite (NVIDIA GPU).
- Для v1.x.x выполните следующую команду:/opt/cloud/cce/nvidia/bin/nvidia-smi
- Для v2.0.0–v2.5.3 выполните следующую команду:/usr/local/nvidia/bin/nvidia-smi
- Для версий новее v2.5.4 выполните следующую команду:nvidia-smi
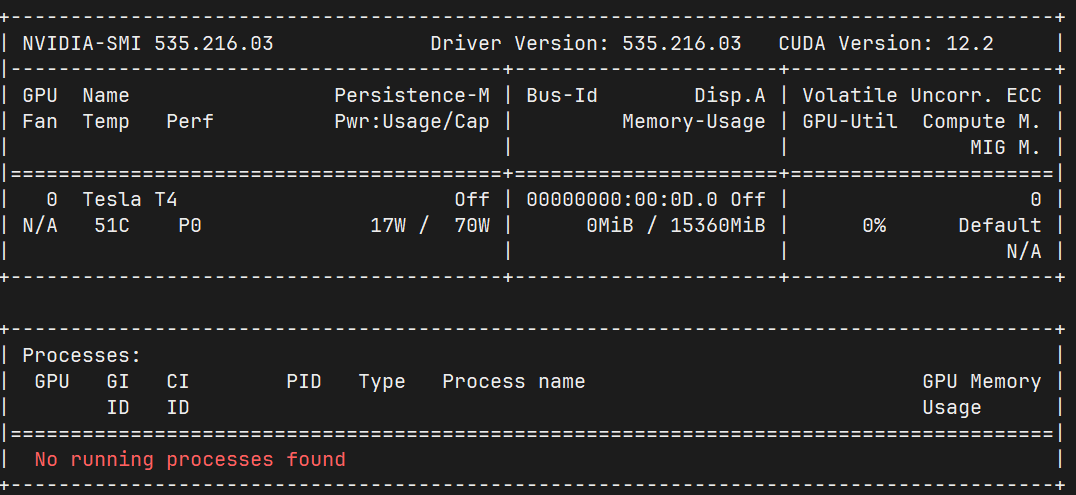
Отображён вывод следующей команды. Версия драйвера node — 535.216.03 и соответствует указанной версии. Это указывает на завершение обновления.
После проверки корректной работы node и сервисов повторите предыдущие шаги, чтобы перезапустить оставшиеся GPU‑node в кластере.
- Для v1.x.x выполните следующую команду:
Поддерживаемые GPU‑драйверы
- Список поддерживаемых GPU‑драйверов применим только к CCE AI Suite (NVIDIA GPU) версии 1.2.28 и новее.
- Чтобы использовать новейший GPU‑драйвер, обновите ваш CCE AI Suite (NVIDIA GPU) до последней версии.
- Совместимость ОС, GPU‑драйверов и моделей GPU, перечисленных в Table 2, протестирована и подтверждена. Для обеспечения высокой производительности и стабильности используйте эти GPU‑драйверы. Если развертывание производится в непроверенной среде, проведите полные тесты в соответствии с окружением, чтобы гарантировать совместимость и стабильность.
- NVIDIA более не предоставляет обновления или исправления безопасности для GPU‑драйверов, достигших конца срока службы (EOL). Подробности см. в Driver Lifecycle. Например, ветка Production Branch (PB) обеспечивает поддержку в течение одного года с даты выпуска, а ветка Long-Term Support Branch (LTSB) — три года.
Согласно этой политике, CCE не предоставляет техническую поддержку GPU‑драйверов, достигших EOL, включая установку и обновление драйверов. Следующие драйверы достигли EOL: 510.47.03, 470.141.03 и 470.57.02.
- При установке GPU‑драйвера на Ubuntu и CentOS обратите внимание на версию ОС. Подробности см. в Table 3. Дополнительную информацию см. в NVIDIA Driver Documentation.
GPU Model | Supported Cluster Type | Specification | OS | OS | OS |
|---|---|---|---|---|---|
HCE OS 2.0 | Ubuntu 22.04 | CentOS Linux release 7.6 | |||
Tesla T4 | CCE standard cluster | g6 pi2 | 580.126.20 570.86.15 535.216.03 535.161.08 535.54.03 510.47.03 470.57.02 | 580.126.20 570.86.15 535.216.03 535.161.08 535.54.03 | 535.216.03 535.161.08 535.54.03 510.47.03 470.141.03 470.57.02 |
Tesla V100 | CCE standard cluster | p2s p2vs p2v | 580.126.20 570.86.15 535.216.03 535.161.08 535.54.03 510.47.03 470.57.02 | 580.126.20 570.86.15 535.216.03 535.161.08 535.54.03 | 535.216.03 535.161.08 535.54.03 510.47.03 470.141.03 470.57.02 |
Версия драйвера | Ubuntu 22.04 | CentOS Linux release 7.6 |
|---|---|---|
Ubuntu 22.04.z LTS (where z ≤ 5) | Не поддерживается | |
Ubuntu 22.04.z LTS (where z ≤ 4) | CentOS 7.y (where y ≤ 9) | |
Ubuntu 22.04.z LTS (where z ≤ 3) | CentOS 7.y (where y ≤ 9) | |
Ubuntu 22.04.z LTS (where z ≤ 2) | CentOS 7.y (where y ≤ 9) | |
Не поддерживается | CentOS 7.y (где y ≤ 9) | |
Не поддерживается | CentOS 7.y (где y ≤ 9) | |
Не поддерживается | CentOS 7.y (где y ≤ 9) |
Получение ссылки на драйвер из Интернета
- Войдите в CCE console и нажмите название кластера, чтобы открыть консоль кластера.
- Создайте узел. В области Specifications выберите флейвор GPU‑узла. Модели GPU отображаются в нижней части области.
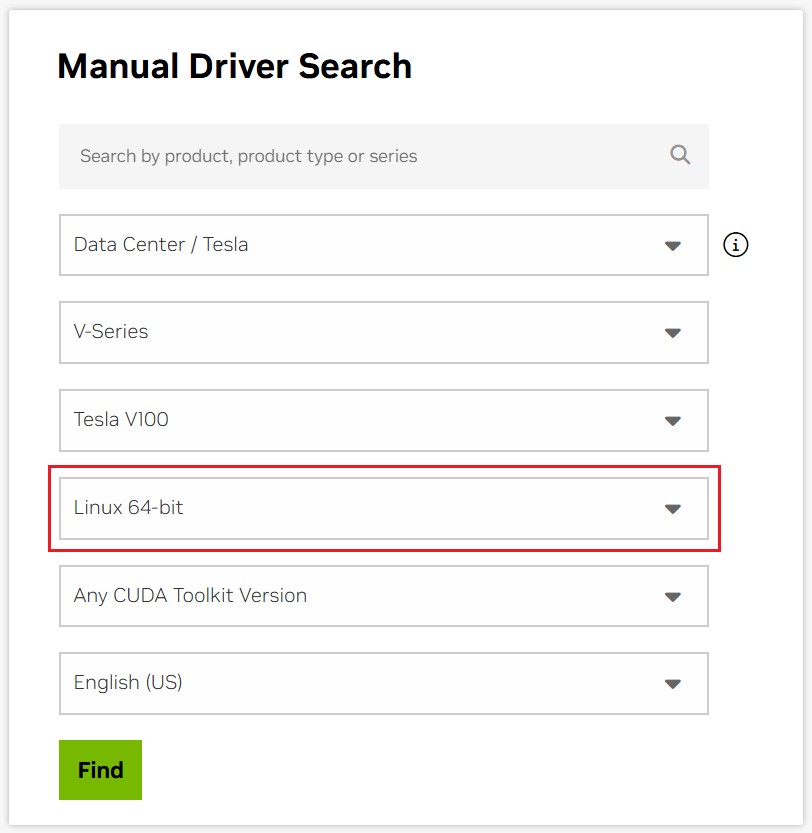
- Перейдите на NVIDIA driver download page и найдите информацию о драйвере. Операционная система должна быть Linux 64-bit.
Рисунок 2 Выбор параметров
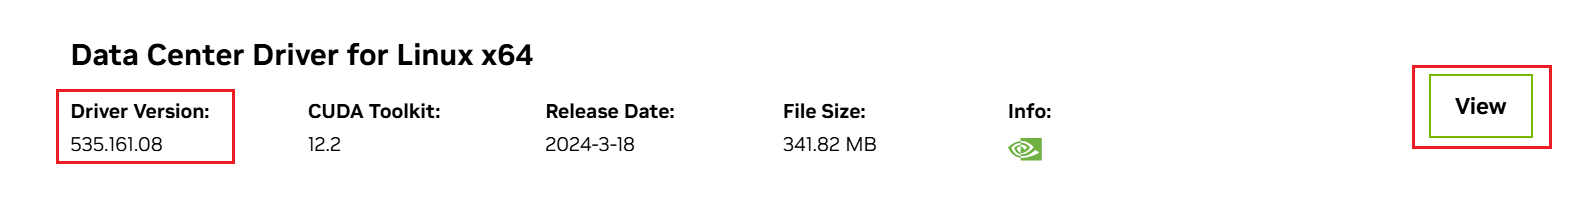
- После подтверждения информации о драйвере нажмите Find. На отображённой странице найдите драйвер для загрузки и нажмите View.
Рисунок 3 Просмотр информации о драйвере
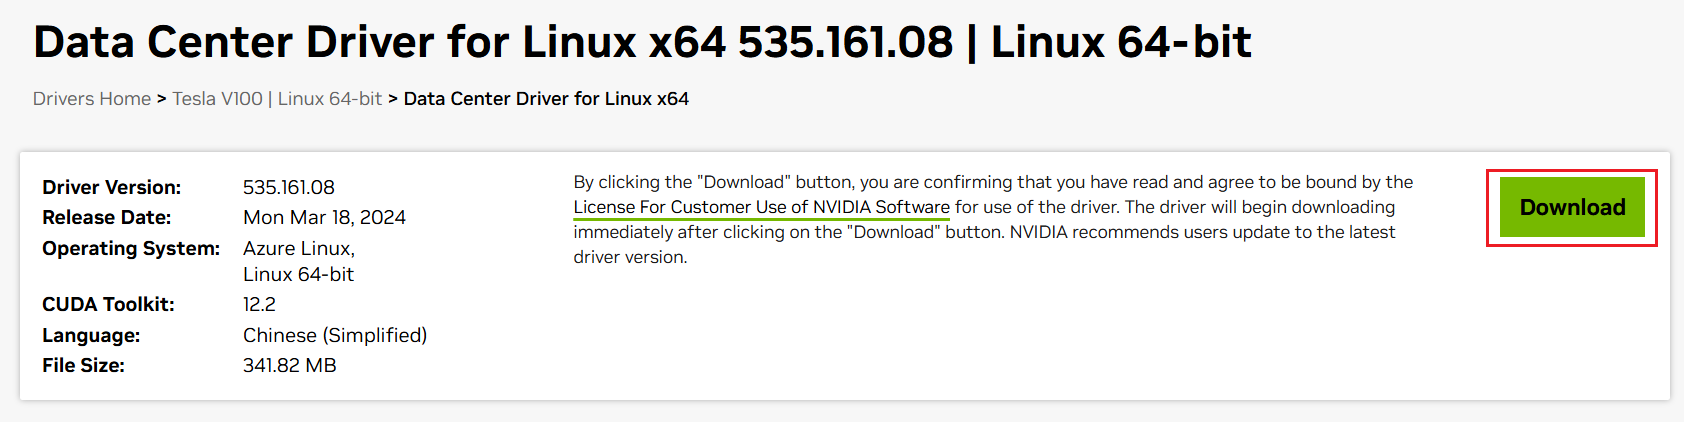
- Нажмите Download и скопируйте ссылку для загрузки.
Рисунок 4 Получение ссылки
Получение ссылки драйвера из ссылки OBS
- Загрузите драйвер в OBS и установите для файла драйвера публичный доступ на чтение Note
При перезапуске узла драйвер будет загружен и установлен повторно. Убедитесь, что ссылка OBS bucket драйвера действительна
- В списке bucket выберите имя bucket, чтобы перейти на страницу Objects
- Нажмите имя целевого объекта и скопируйте ссылку драйвера на вкладке Basic Information
Компоненты
Component | Description | Resource Type |
|---|---|---|
nvidia-driver-installer | Рабочая нагрузка для установки драйвера NVIDIA GPU на узле, использующая ресурсы только во время установки (после установки ресурсы больше не потребляются) | DaemonSet |
nvidia-gpu-device-plugin | Плагин устройства Kubernetes, предоставляющий гетерогенные вычисления NVIDIA GPU для контейнеров | DaemonSet |
nvidia-operator | Компонент, предоставляющий возможности управления узлами NVIDIA GPU для кластеров | Deployment |
Полезные ссылки
- CCE AI Suite (NVIDIA GPU) предоставляет метрики мониторинга GPU. Для получения подробной информации о метриках GPU см. GPU Metrics.